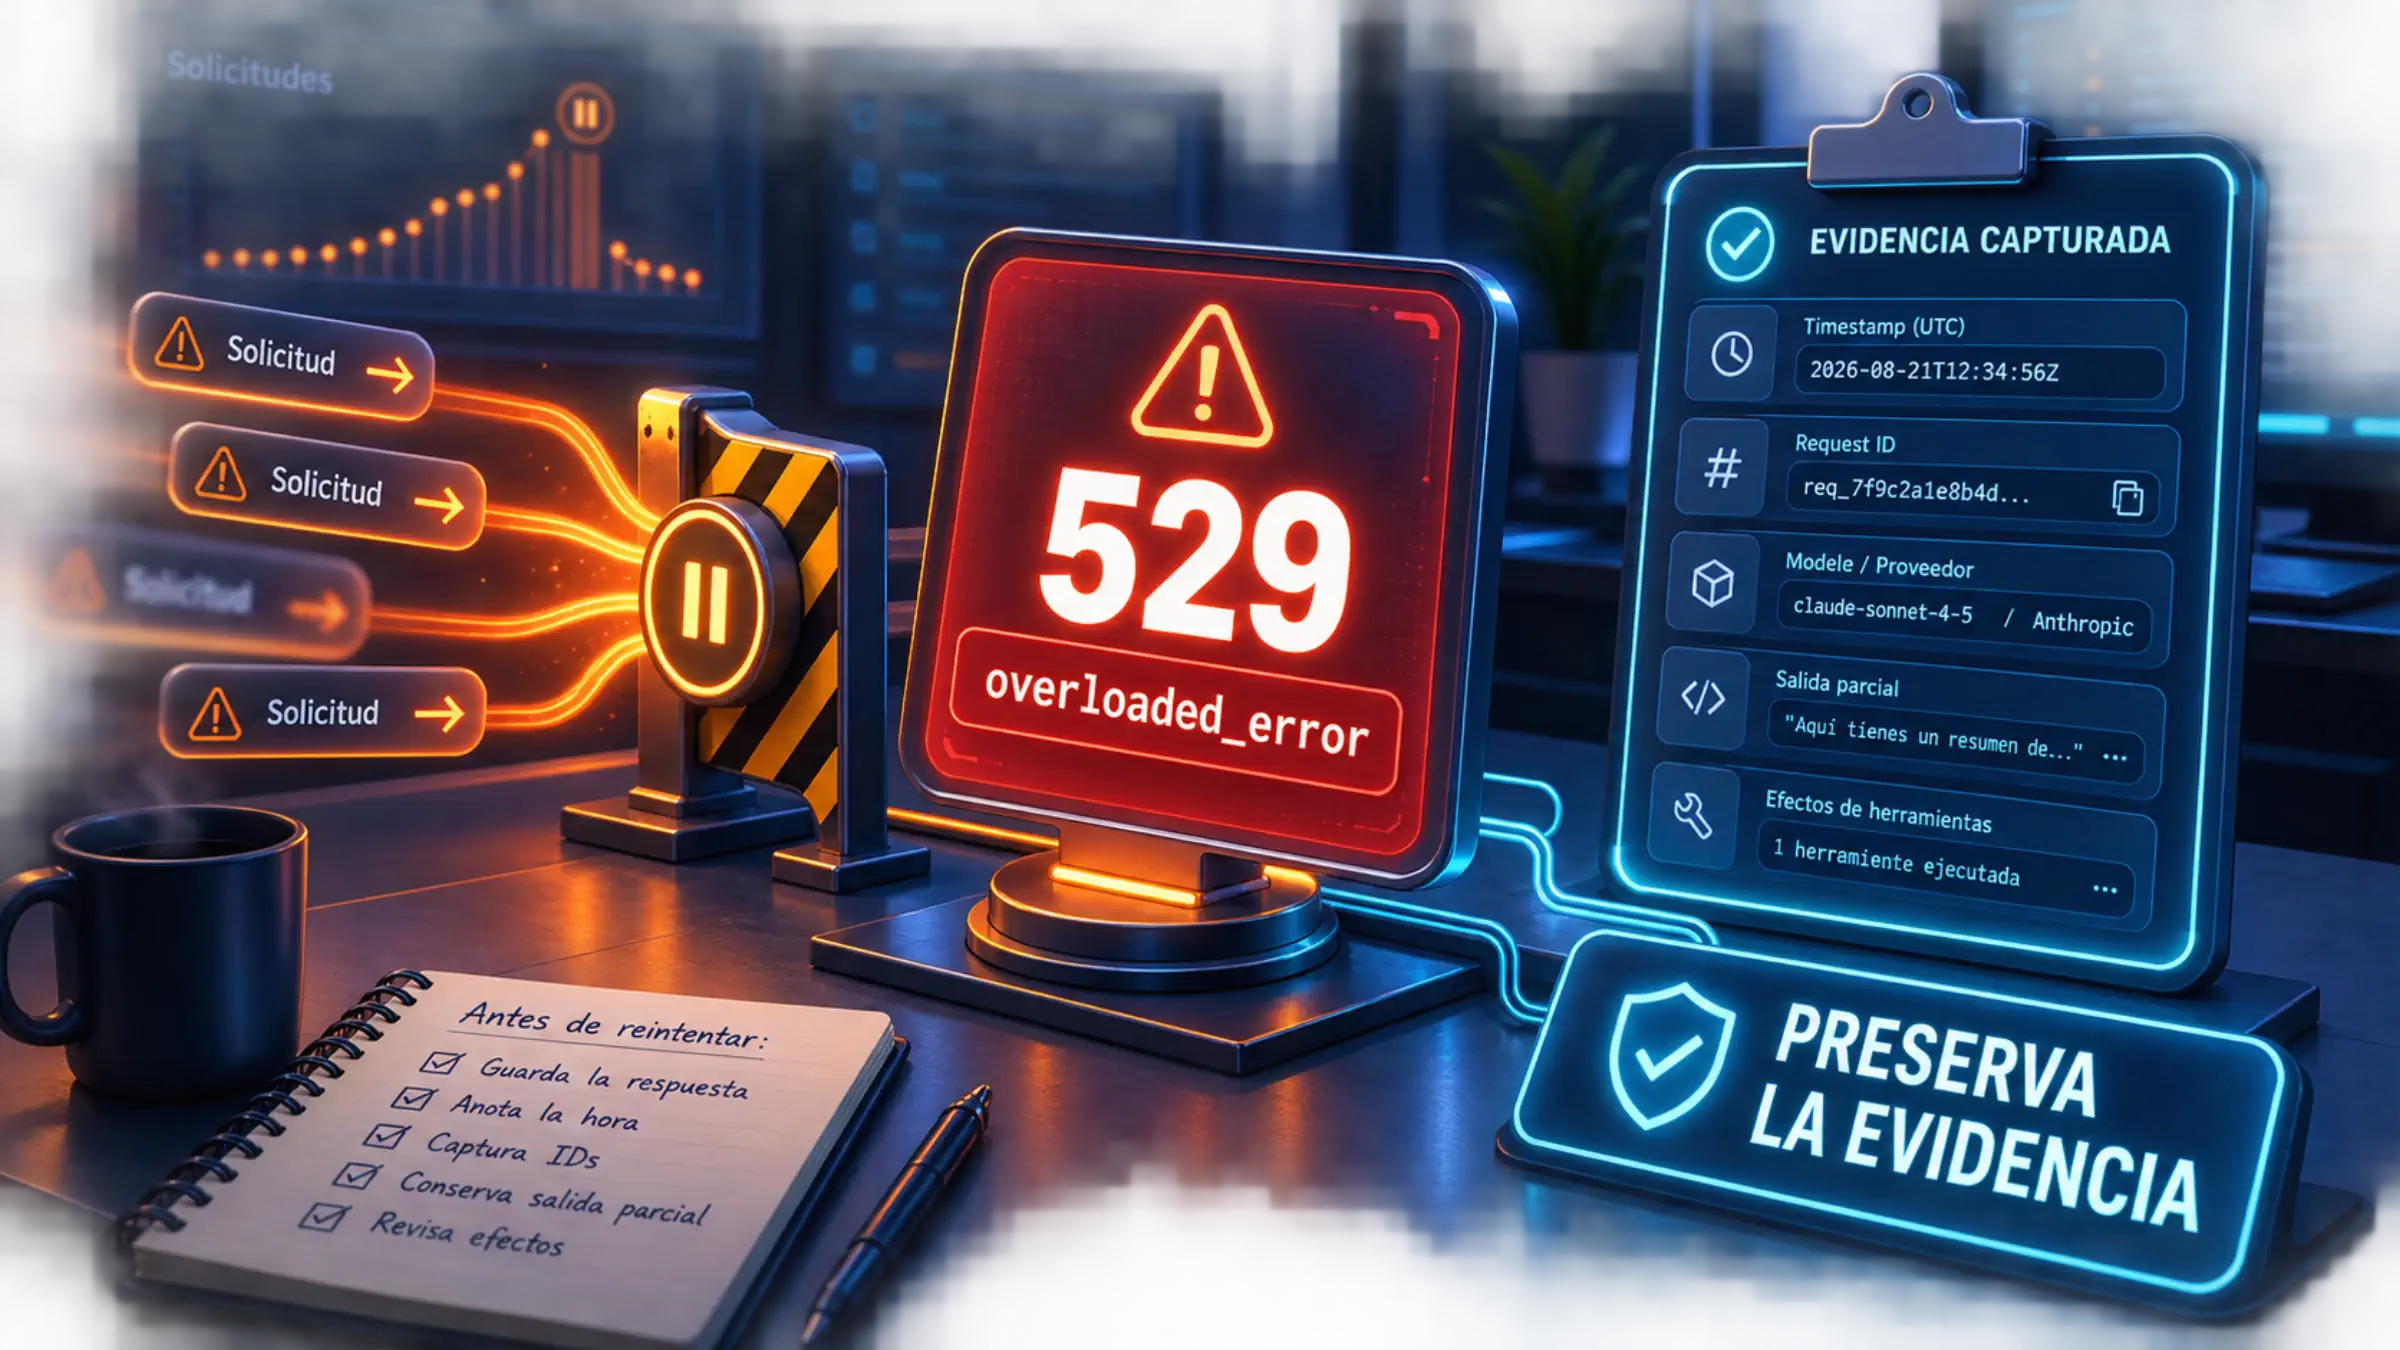
En la API de Claude, Anthropic define un 529 overloaded_error como una sobrecarga temporal. No es lo mismo que un 429 rate_limit_error y, por sí solo, tampoco demuestra que tu cuenta haya alcanzado un límite, que no exista consumo asociado o que la operación no haya producido una salida parcial. Si usas un intermediario, primero confirma si este conserva o envuelve el error del proveedor upstream.
Antes de volver a intentarlo, conserva el error completo, la hora, la superficie utilizada, el proveedor, el modelo, el request_id, cualquier salida parcial, los efectos de herramientas y los reintentos (retries) ya ejecutados. Esa captura evita dos problemas frecuentes: añadir otra capa de reintentos sobre un cliente que ya reintentó y repetir una operación con efectos externos.
Respuesta rápida: qué hacer ante un 529
- Confirma el código y el cuerpo reales. Busca
529yoverloaded_error; no diagnostiques a partir de un mensaje resumido por una interfaz. - Identifica la superficie. API directa, Claude Code,
claude.ai, un proveedor cloud o una pasarela de terceros tienen controles y registros distintos. - Comprueba el estado del proveedor nombrado en el error. Una página global en verde es una señal útil, no una prueba sobre tu ruta, región, modelo o instante concreto.
- Cuenta los reintentos existentes. Los SDK oficiales y Claude Code pueden haber reintentado antes de enseñarte el fallo.
- Protege resultados parciales y efectos. Si hubo texto recibido o una herramienta ya actuó, no repitas a ciegas.
- Aplica una recuperación limitada. Reduce concurrencia, espera con backoff y jitter, fija un máximo de intentos y detente si no hay recuperación.
- Escala con evidencia. Aporta
request_id, timestamp, modelo, ruta, versión del cliente y registros correlacionados.
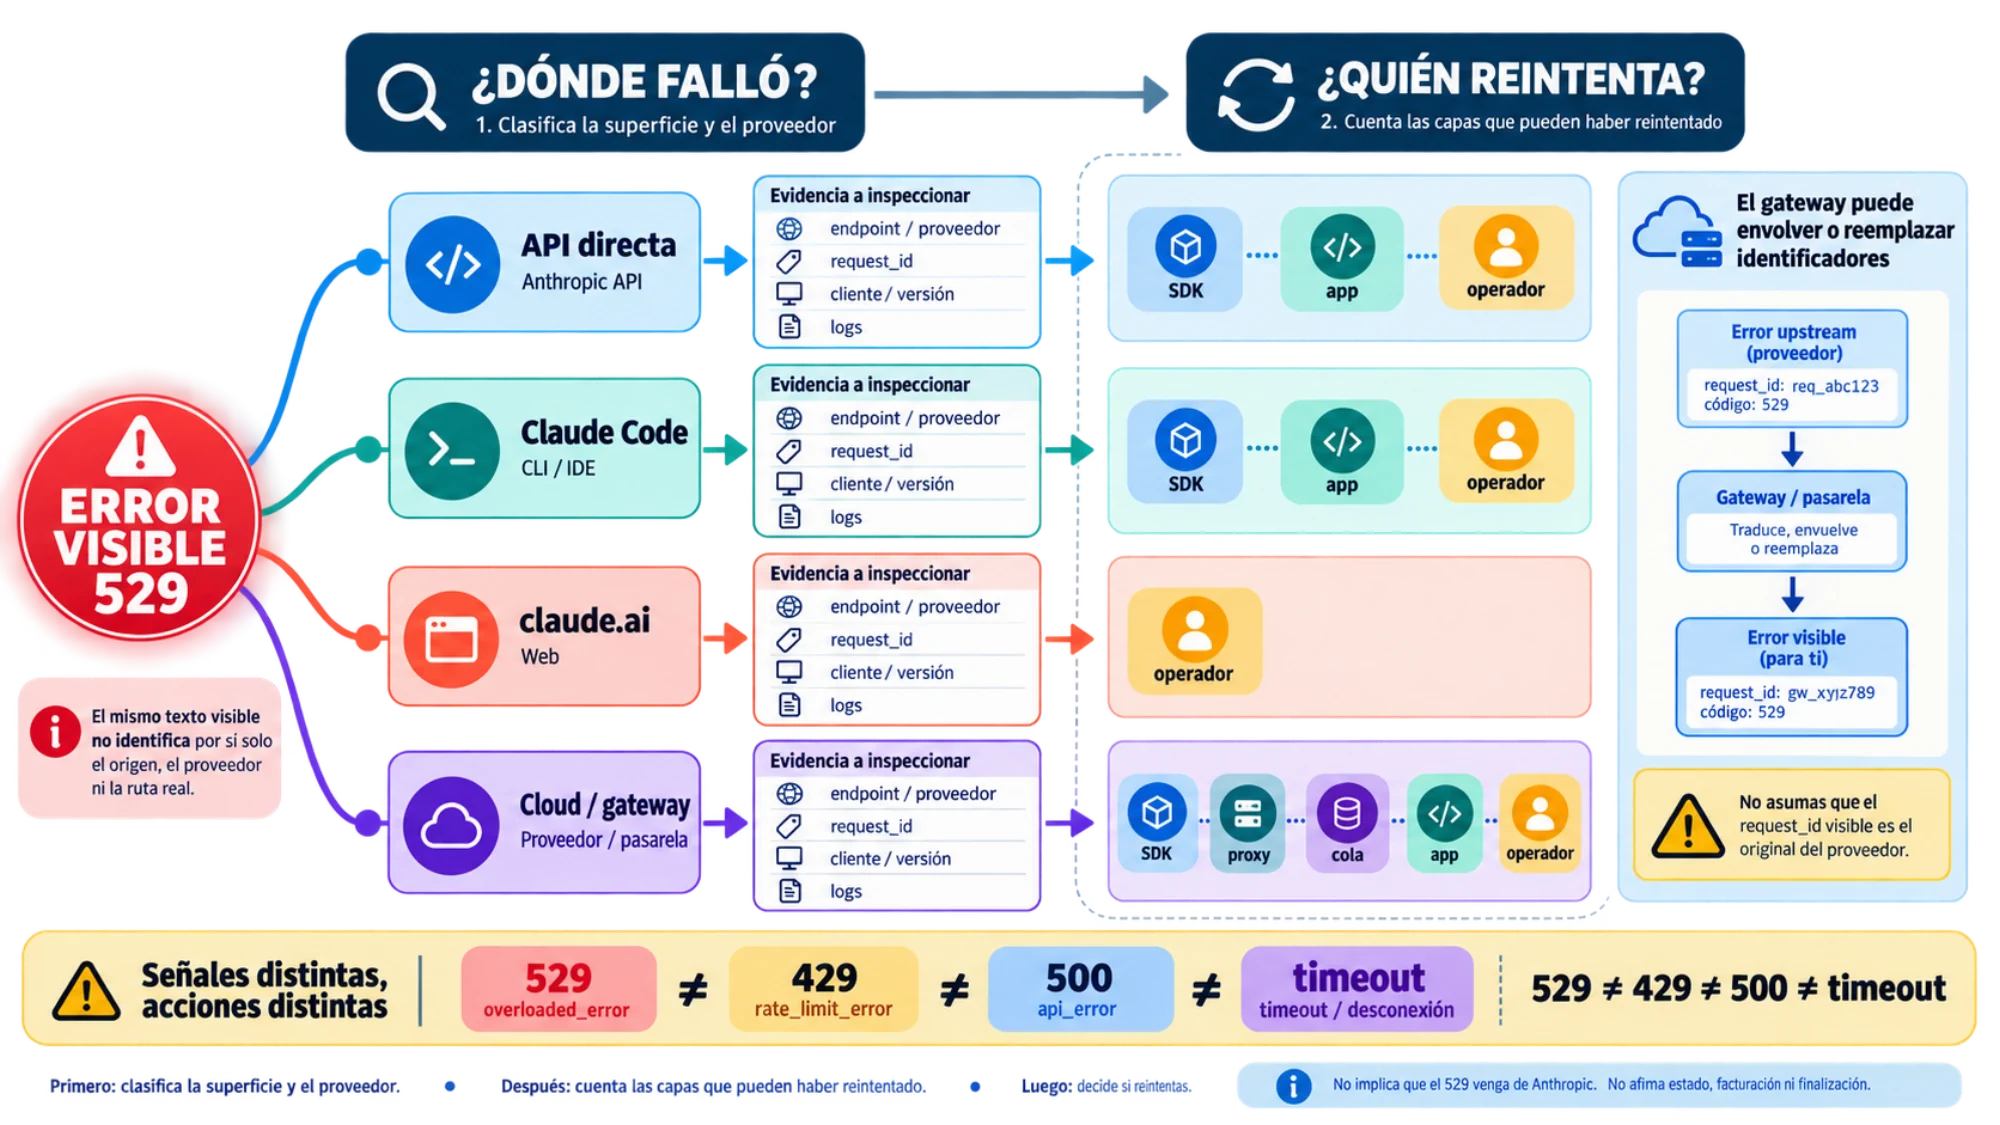
529 no es 429: la diferencia cambia la acción
Anthropic define el 529 como una sobrecarga temporal de la API durante periodos de tráfico elevado. En cambio, un 429 corresponde a limitación de tasa y puede estar relacionado con rate limits, un límite mensual de gasto o un límite de gasto del workspace de Claude Code. La referencia oficial mantiene ambos errores separados porque sus causas probables y comprobaciones no son equivalentes.
| Señal | Interpretación inicial | Primera comprobación |
|---|---|---|
529 overloaded_error | Capacidad temporal insuficiente | Superficie, proveedor, estado, modelo y reintentos previos |
429 rate_limit_error | Límite de tasa o gasto aplicable a la ruta | Cuerpo y headers, límites del proyecto/workspace y consola |
500 api_error | Error interno distinto de la señal de sobrecarga | request_id, estado y logs de la petición |
| Timeout o desconexión | El cliente dejó de esperar o perdió la conexión | Si el servidor siguió procesando, si hubo salida parcial y qué capa abortó |
No conviertas un timeout local en un 529 por intuición. Tampoco asumas que una respuesta HTTP 200 inicial garantiza que un stream terminó bien: en una conexión SSE puede aparecer un error después de haberse iniciado la respuesta.
Primero localiza dónde falló
El mismo texto visible puede haber atravesado varias capas. La acción correcta depende de cuál emitió o envolvió el error.
API directa de Anthropic
Conserva el tipo de error, el mensaje, el request_id del cuerpo y el header de request ID si está disponible. Revisa la configuración real del SDK: los SDK oficiales reintentan por defecto ciertos fallos transitorios —incluidos errores 5xx— dos veces con retroceso exponencial, aunque ese máximo puede modificarse o desactivarse.
Si tu aplicación, cola o proxy también reintenta, calcula el total combinado. Tres capas con “solo dos reintentos” pueden multiplicar las solicitudes mucho más de lo esperado.
Claude Code
Cuando Claude Code muestra un 529 repetido, ya ha hecho varios intentos. La documentación actual indica que puede reintentar fallos transitorios elegibles hasta diez veces con backoff exponencial antes de mostrar el error.
En esta superficie, el 529 no es un límite de uso y no cuenta contra la cuota de Claude Code. Esa precisión es específica de Claude Code: no debe ampliarse a una promesa de coste cero para API directa, proveedores cloud o gateways.
Claude Code también evita volver a ejecutar automáticamente un fallo a mitad de stream después de un bloque de texto completado o una llamada de herramienta, porque repetirla podría ejecutar la misma acción dos veces. Si ves salida o actividad de herramientas, inspecciónala antes de lanzar otra sesión.
claude.ai
La web ofrece menos control sobre los reintentos y los request IDs que una integración propia. Guarda la hora exacta, el mensaje visible, la conversación afectada y si apareció contenido parcial. Comprueba el estado oficial y prueba de nuevo de forma manual y limitada; si el fallo persiste, documenta la cuenta o plan sin compartir credenciales ni datos sensibles.
Proveedor cloud o gateway de terceros
El nombre “Claude” no identifica necesariamente al proveedor que respondió. Comprueba el endpoint, el provider elegido, los headers y los logs de cada salto. Una pasarela puede reintentar, cambiar de modelo, reemplazar un identificador upstream o aplicar su propia política de facturación.
No atribuyas a Anthropic un 529 envuelto por un intermediario hasta correlacionar los registros. Tampoco deduzcas idempotencia, finalización, cargo o doble cargo solo a partir del código: esas respuestas requieren la documentación de la ruta y los registros de uso correspondientes.
Un procedimiento de recuperación con límites
1. Congela la evidencia antes de cambiar nada
Copia una ficha mínima como esta en tu incidente o log seguro:
texthora_utc:
superficie: api_directa | claude_code | claude_ai | cloud | gateway
endpoint_o_proveedor:
modelo:
codigo_http:
tipo_error:
request_id:
cliente_y_version:
retries_configurados:
retries_observados:
salida_parcial:
herramientas_o_efectos:
estado_consultado_y_hora:
Usa la hora con zona horaria y preserva la respuesta original. Un screenshot recortado sin timestamp, endpoint ni identificador suele ser insuficiente para correlacionar el fallo.
2. Consulta el estado, pero no cierres el diagnóstico ahí
Revisa la página oficial de estado de Claude y el estado del proveedor que aparece en tu ruta. El 21 de agosto de 2026, la página de Claude mostraba los componentes principales operativos y ningún incidente de ese día; también mostraba como resuelto un incidente de errores elevados del día anterior.
Ese dato es una fotografía agregada. No descarta una saturación breve, específica de un modelo, región, cuenta o gateway, ni demuestra la causa de tu solicitud. Registra la hora de la consulta para no presentar el estado actual como si describiera el instante del fallo.
3. Calcula quién es dueño del retry
Enumera todas las capas capaces de repetir:
- SDK oficial o cliente HTTP;
- Claude Code;
- proxy o gateway;
- cola de trabajos;
- plataforma serverless;
- lógica propia de la aplicación;
- operador que pulsa “reintentar”.
Elige una sola capa como coordinadora cuando sea posible. Define un máximo total de intentos y un tiempo límite global. Respeta retry-after si la respuesta lo incluye; en su ausencia, usa backoff exponencial con jitter para evitar que todos los workers vuelvan a la vez.
4. Reduce presión antes de repetir
Pausa nuevos trabajos no esenciales, baja la concurrencia y evita relanzar todo el lote. Reintenta primero una operación pequeña y observable. Si la capacidad parece específica del modelo y tu producto lo permite, puedes valorar otro modelo, pero comprueba disponibilidad, política, compatibilidad y calidad requerida antes del cambio.
5. Protege la operación, no solo la petición
Antes de repetir, responde:
- ¿Llegó texto parcial que deba conservarse?
- ¿Se completó una llamada de herramienta?
- ¿Se creó un archivo, ticket, pago, correo o registro?
- ¿Existe una clave de idempotencia o una comprobación de “ya realizado”?
- ¿Puedes consultar el estado downstream sin volver a ejecutar?
Si no puedes demostrar que el reintento es seguro, detén la automatización y reconcilia el estado. Una recuperación un poco más lenta es preferible a duplicar un efecto irreversible.
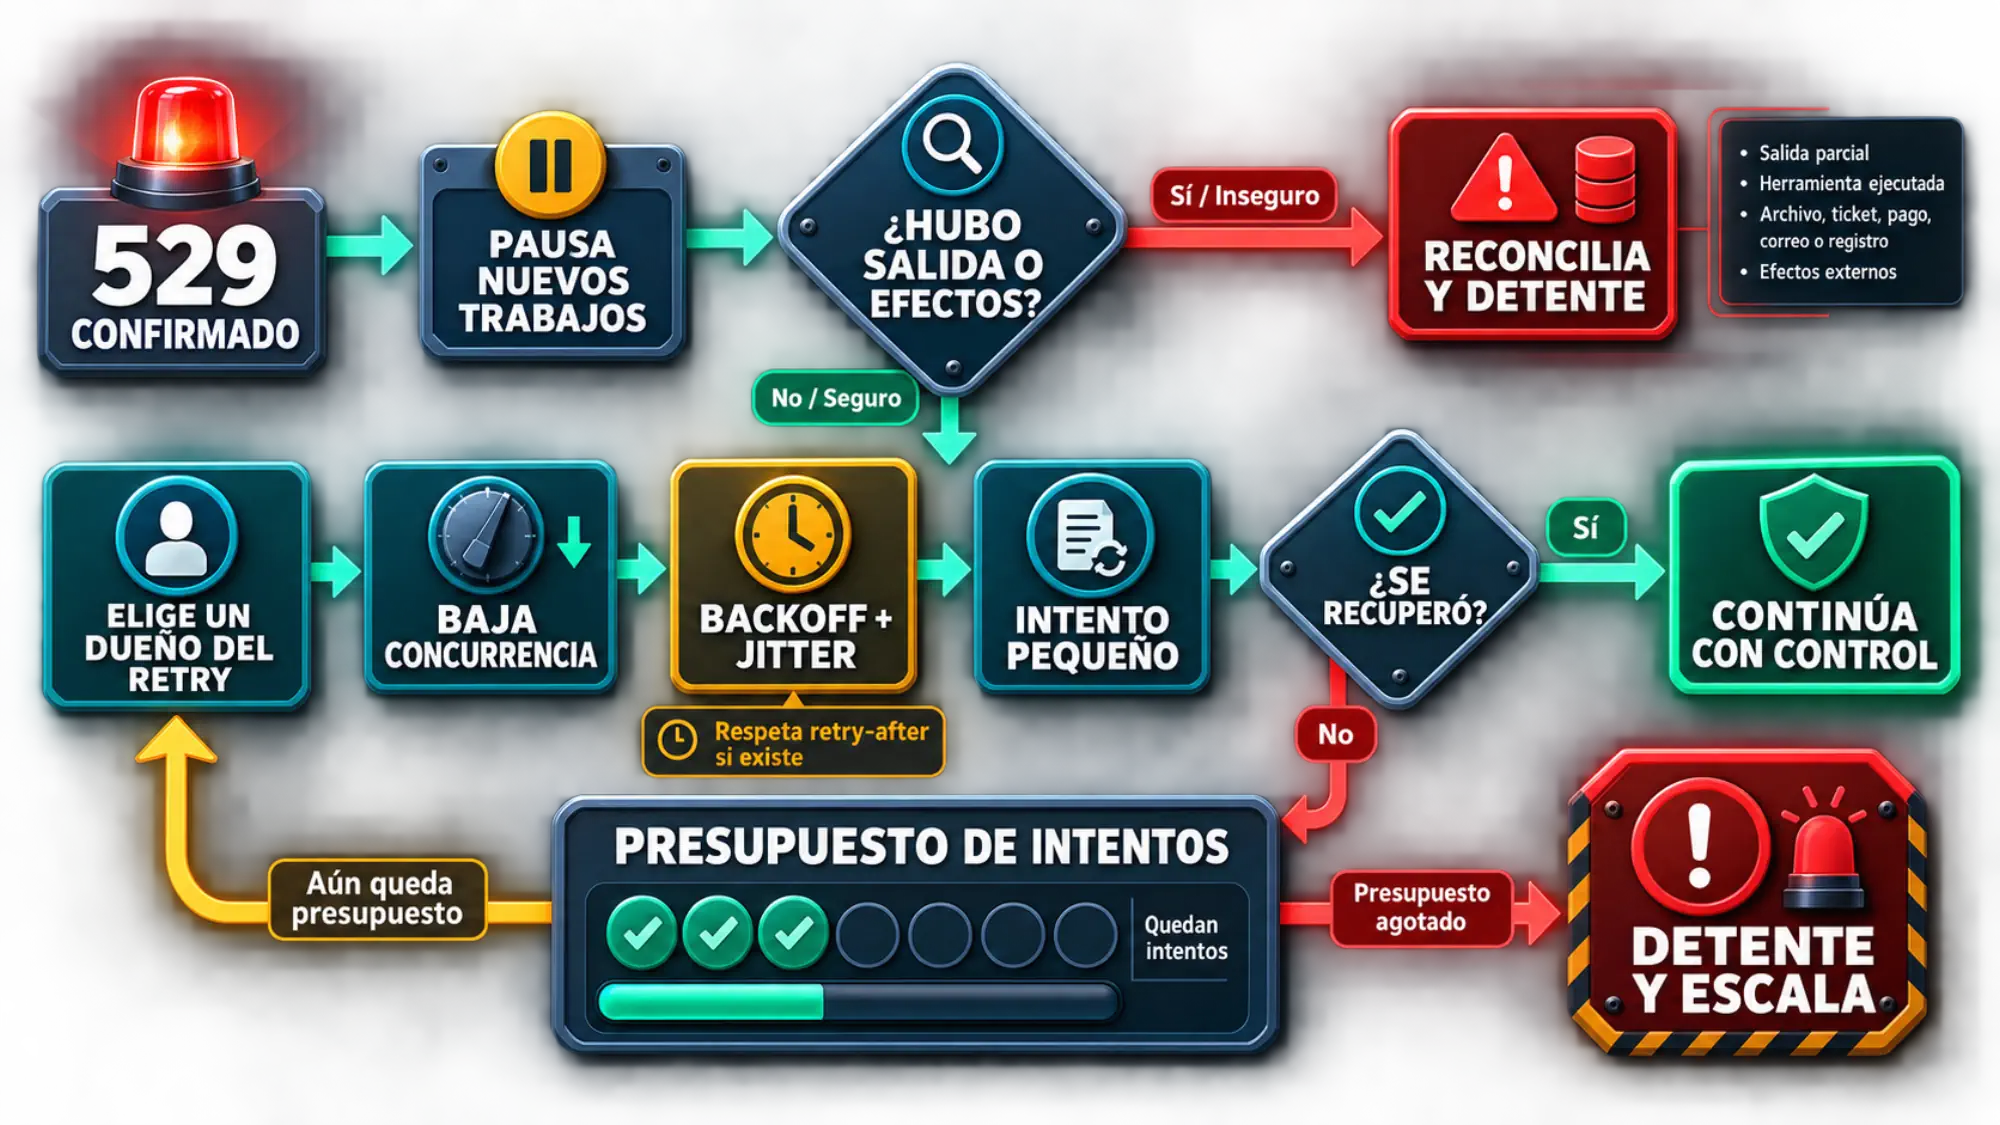
Cuándo esperar, cambiar de modelo o detenerse
Espera y reintenta con límites cuando el error está confirmado como 529, no hay efectos parciales sin reconciliar, conoces el número total de reintentos y el proveedor no indica una acción distinta.
Reduce concurrencia cuando varios workers fallan juntos o tu cola intenta recuperar en paralelo. Aunque la sobrecarga sea del proveedor, una avalancha sincronizada prolonga la presión y dificulta observar qué intento funcionó.
Considera otro modelo cuando la documentación y tu ruta permiten el cambio, la capacidad parece específica del modelo y el resultado alternativo sigue cumpliendo la tarea. No hagas failover silencioso si el modelo cambia coste, latencia, capacidades o requisitos de evaluación.
Detente y escala cuando ocurre cualquiera de estos casos:
- el error persiste después del presupuesto de intentos;
- no sabes cuántas capas están reintentando;
- hubo salida parcial o una herramienta pudo producir efectos;
- el gateway no conserva el
request_idupstream; - los registros de uso y las respuestas no se pueden reconciliar;
- cambiar de modelo alteraría el resultado de forma material;
- aparecen códigos mezclados —529, 429, 500 y timeout— en la misma cadena.
La opción CLAUDE_CODE_RETRY_WATCHDOG=1 merece especial cautela: en sesiones desatendidas puede reintentar indefinidamente errores de capacidad 429 y 529, y elevar a 300 el máximo predeterminado para otros fallos transitorios. No la actives como arreglo general sin controles explícitos de concurrencia, presupuesto, idempotencia y parada.
Qué enviar a soporte o al proveedor
Una escalada útil permite correlacionar el evento sin obligar a reconstruirlo. Incluye:
- timestamp exacto y zona horaria;
- superficie, endpoint y proveedor;
- modelo solicitado;
- código, tipo y mensaje de error sin reinterpretarlos;
request_idy, si interviene un gateway, sus identificadores de cada salto;- cliente, SDK o versión de Claude Code;
- configuración de retry y número observado de intentos;
- si hubo streaming, último bloque completo y punto del fallo;
- herramientas ejecutadas y estado de sus efectos;
- estado del proveedor consultado y hora de la consulta;
- extracto mínimo de logs, sin API keys, prompts sensibles ni datos personales.
Puedes contrastar el significado y los campos con la referencia oficial de errores de la API y, si corresponde, con la referencia de errores de Claude Code.
Preguntas frecuentes
¿Cuánto tarda en desaparecer un 529?
No existe un tiempo universal respaldado por el código de error. Puede ser breve o persistir según la capacidad, el modelo y la ruta. Usa un presupuesto de reintentos y una condición de parada, no un bucle abierto.
¿Un 529 significa que he agotado mi cuota?
En Claude Code, la documentación distingue el 529 de un límite de uso e indica que no cuenta contra su cuota. Para API directa o gateways, no generalices esa afirmación: revisa la respuesta, los registros de uso y las reglas de la ruta concreta.
¿Puedo reintentar la misma petición sin riesgo?
No siempre. Si hubo streaming, texto parcial o llamadas de herramienta, la operación pudo avanzar antes del fallo. Comprueba idempotencia y efectos externos antes de repetir.
¿Una página de estado en verde descarta una caída?
No. Describe un estado agregado en un momento concreto. Puede no reflejar un fallo breve o limitado a una región, modelo, cuenta, endpoint o intermediario.
¿Debo cambiar de modelo inmediatamente?
Solo si tu ruta lo admite y el modelo alternativo cumple los requisitos de la tarea. Primero preserva la evidencia y controla los reintentos; después evalúa el cambio como una decisión de compatibilidad, no como un atajo automático.
La regla práctica
Ante un 529, preserva, clasifica, limita y correlaciona: preserva la respuesta y los efectos, clasifica la superficie y el proveedor, limita la recuperación y correlaciona cada intento con sus identificadores. Así conviertes un mensaje genérico de sobrecarga en una decisión operativa segura, sin prometer una causa, un plazo ni un resultado de facturación que el error por sí solo no puede demostrar.