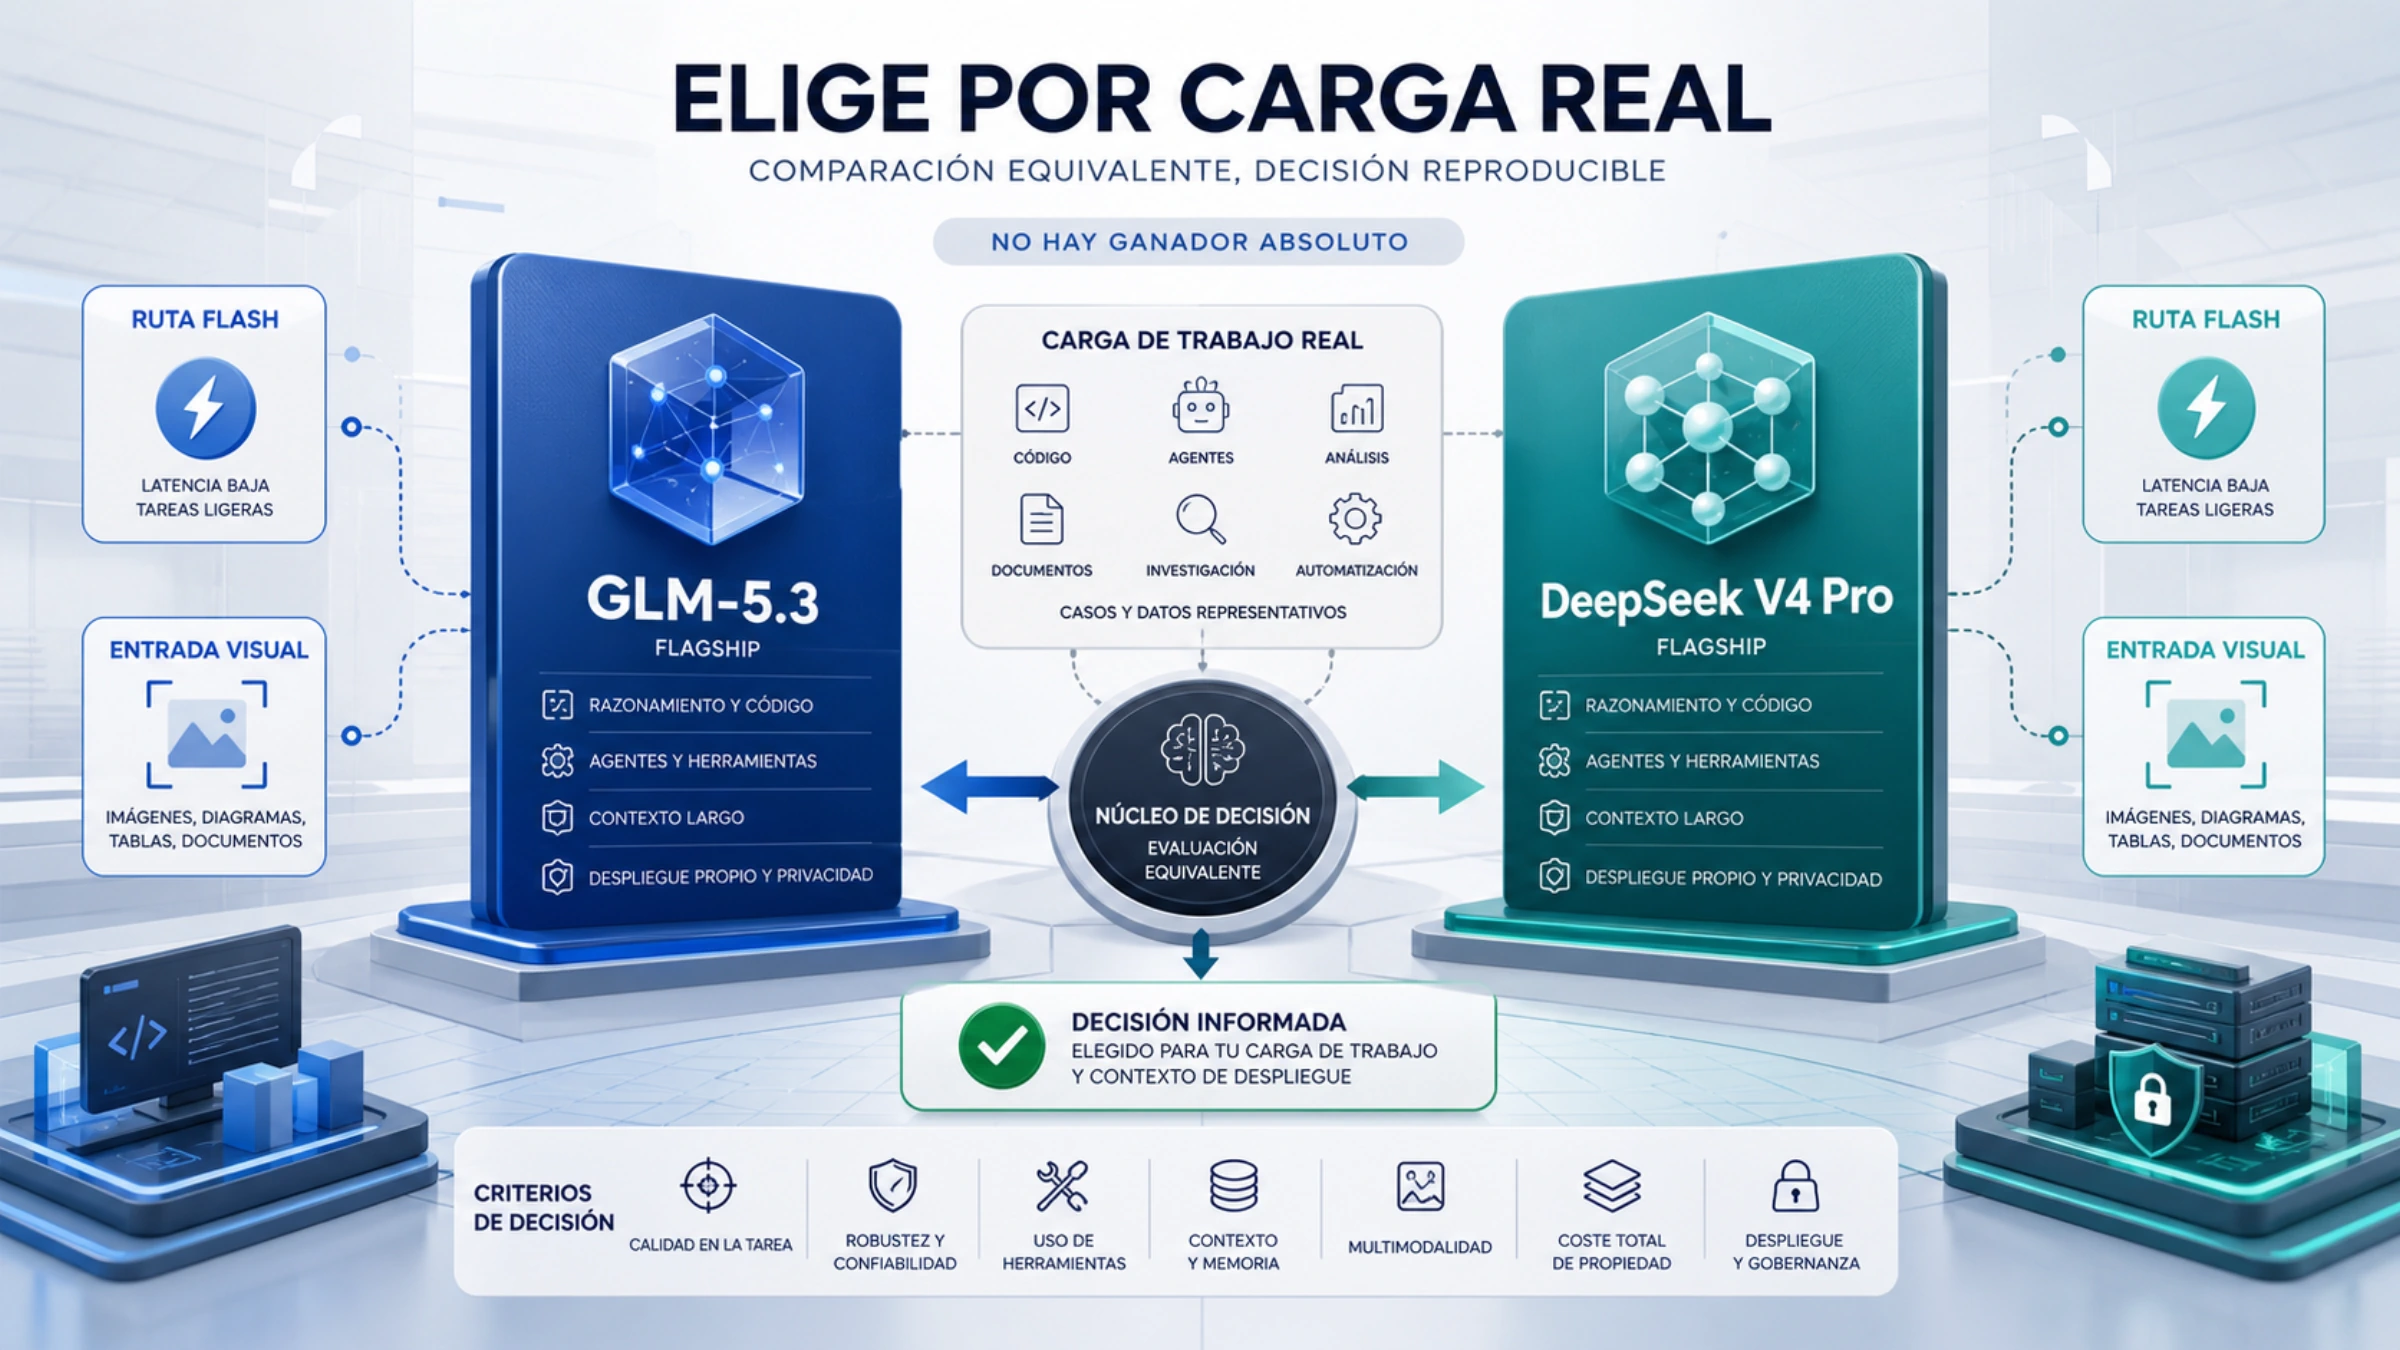
Respuesta corta: no hay evidencia comparable suficiente para declarar un ganador universal. Para un agente de texto o programación, empieza probando GLM-5.3 y DeepSeek V4 Pro con las mismas tareas, herramientas, esfuerzo de razonamiento y límites. Si priorizas coste o volumen, añade las variantes Flash a la prueba. Si necesitas entrada visual, compara GLM-5.3-Flash con DeepSeek V4 Flash Vision Exp, pero trata esta última como experimental. Y si necesitas pesos para despliegue propio, DeepSeek publica los de V4 Pro 0813 bajo licencia MIT.
Esta comparación está actualizada al 27 de agosto de 2026. La fecha importa: muchos comparadores aún enfrentan GLM-5.2 con DeepSeek V4, aunque Z.ai ya presenta GLM-5.3 como su modelo insignia más reciente.
La comparación correcta no es «GLM contra DeepSeek» a secas
Cada familia ofrece variantes con objetivos distintos. Mezclarlas produce conclusiones engañosas: un modelo Flash optimizado para coste o velocidad no es el mismo candidato que un modelo Pro, y una variante visual experimental no debe evaluarse como si tuviera el mismo nivel de madurez que un modelo de producción.
| Necesidad | Candidato GLM | Candidato DeepSeek | Qué comprobar |
|---|---|---|---|
| Código, razonamiento y agentes de texto | glm-5.3 | deepseek-v4-pro | Calidad aceptada, uso de herramientas, latencia, reintentos y coste total |
| Mucho volumen o presupuesto ajustado | glm-5.3-flash | deepseek-v4-flash | Calidad mínima, concurrencia, caché y estabilidad bajo carga |
| Entrada de imágenes | glm-5.3-flash | deepseek-v4-flash-vision-exp | Cobertura de formatos, precisión visual y tolerancia al estado experimental |
| Despliegue con pesos propios | No confirmado en las fuentes revisadas | DeepSeek V4 Pro 0813 | Hardware, cuantización, licencia, seguridad y paridad con la API |
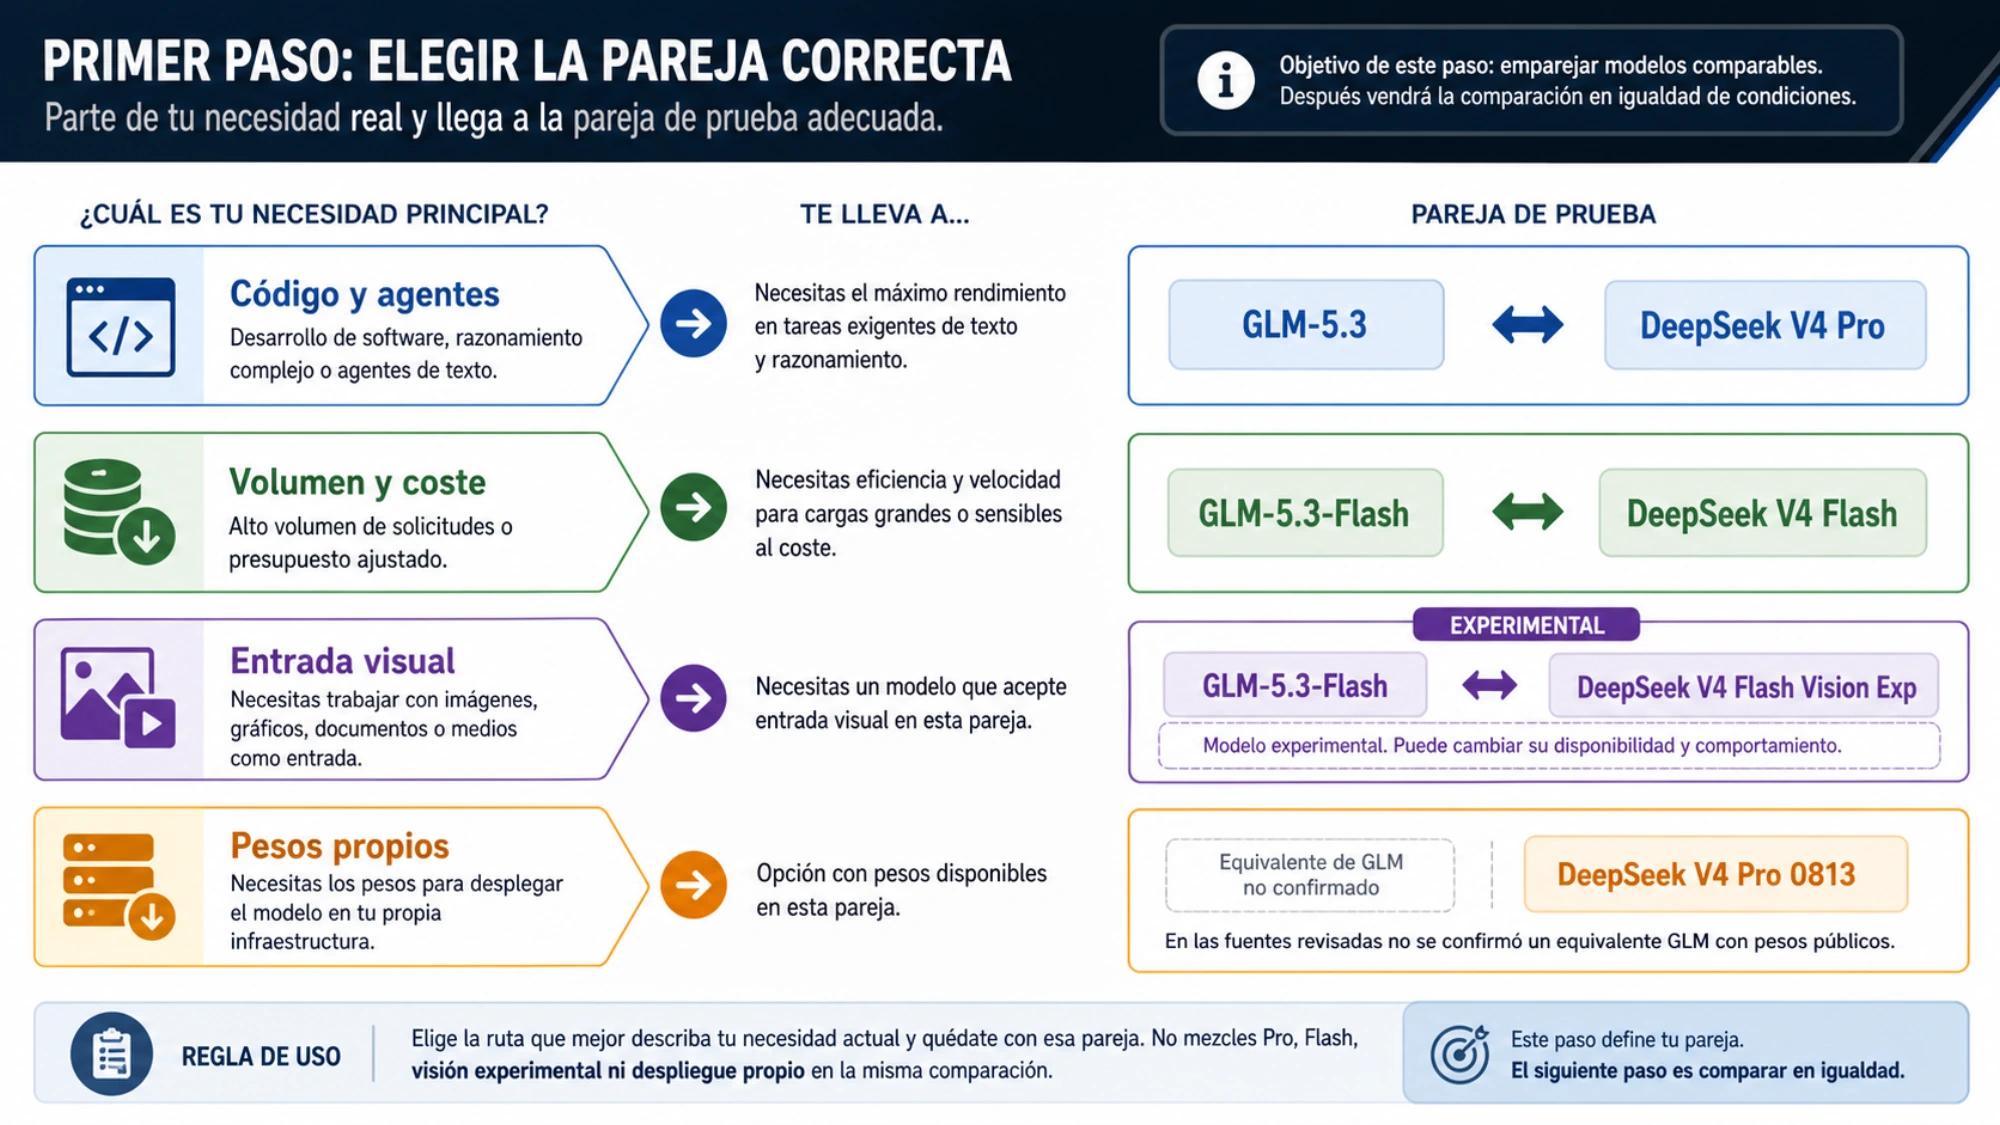
La primera decisión, por tanto, es escoger la pareja de candidatos adecuada. Solo después tiene sentido comparar resultados.
Qué ofrece hoy cada familia
GLM-5.3: texto, contexto largo y razonamiento siempre activo
Según la documentación oficial de GLM-5.3, su ID de API es glm-5.3. Es un modelo de entrada exclusivamente textual con:
- ventana de contexto de hasta 1 millón de tokens;
- salida máxima documentada de 128.000 tokens;
- razonamiento siempre activo;
- niveles
low,highymaxparareasoning_effort.
Z.ai comunica mejoras frente a GLM-5.2 en código y agentes de larga duración. Es una señal útil para decidir qué probar, pero sigue siendo una afirmación del fabricante: no demuestra por sí sola que GLM-5.3 supere a DeepSeek en tu repositorio, tu conjunto de herramientas o tu presupuesto.
GLM-5.3-Flash: la rama multimodal y de bajo coste
La ficha oficial de GLM-5.3-Flash documenta entradas de texto, imagen, vídeo y archivos, contexto de 1 millón de tokens, llamadas a funciones, salida estructurada y caché de contexto.
Es un candidato distinto de GLM-5.3. Puede encajar mejor cuando una tarea combina documentos o medios con herramientas, o cuando el coste domina la decisión. No conviene asumir que todas esas capacidades están disponibles de idéntica forma en cada endpoint, región o integración de agente: confírmalo en el entorno que vayas a utilizar.
DeepSeek V4 Pro: el candidato principal para agentes y API
DeepSeek anunció la disponibilidad general de V4 Pro el 13 de agosto de 2026. Su anuncio oficial indica niveles de razonamiento low, high y max, además de soporte nativo para OpenAI Responses API.
La tabla actual de modelos y precios identifica deepseek-v4-pro con la versión servida DeepSeek-V4-Pro-0813. Documenta contexto de hasta 1 millón de tokens, salida de hasta 384.000 tokens, JSON, llamadas a herramientas y compatibilidad con Responses API y Anthropic API.
Esos máximos describen el contrato público, no una garantía de que una tarea enorme vaya a terminar bien. En agentes largos suelen importar más la disciplina de herramientas, los timeouts, la recuperación tras errores y el crecimiento real del contexto que el máximo anunciado.
DeepSeek V4 Flash y Vision Exp
deepseek-v4-flash es la alternativa de la familia para cargas donde coste y throughput pesan más. Para entrada visual, DeepSeek lanzó deepseek-v4-flash-vision-exp el 21 de agosto de 2026. La propia denominación Exp es relevante: antes de usarlo en producción, valida estabilidad, formatos y comportamiento ante imágenes difíciles.
DeepSeek también publica los pesos de DeepSeek-V4-Pro-0813 bajo licencia MIT y ofrece orientación de despliegue local. Eso abre una ruta que una API alojada no cubre, aunque no abarata automáticamente el sistema: hay que contar GPU, almacenamiento, operación, observabilidad, seguridad y la posible pérdida de calidad por cuantización.
Comparación práctica: dónde está la diferencia real
Programación
No elijas por una cifra aislada de benchmark. Para programación, el modelo debe trabajar sobre el mismo estado del repositorio, respetar instrucciones, producir un parche válido y no romper pruebas existentes.
Una evaluación útil incluye al menos:
- corrección localizada de un bug con una prueba de regresión;
- cambio que atraviese varios archivos sin ampliar el alcance;
- investigación de un fallo donde la primera hipótesis sea incorrecta;
- tarea larga con herramientas, checkpoints y recuperación tras un error;
- revisión de código donde deba distinguir defectos reales de preferencias de estilo.
Un informe independiente de Aikido evaluó diez modelos en un entorno de ciberseguridad congelado y sin internet. En ese arnés concreto, DeepSeek V4 Pro encontró más vulnerabilidades acumuladas que GLM-5.3, pero también generó más hallazgos candidatos y pistas falsas. Es una observación valiosa para seguridad ofensiva bajo esas condiciones, no un veredicto general sobre programación, razonamiento, coste o agentes.
Agentes y uso de herramientas
Ambas opciones principales documentan razonamiento ajustable y capacidades orientadas a herramientas. La diferencia decisiva suele aparecer en el comportamiento, no en la casilla de una tabla:
- ¿elige la herramienta correcta sin llamadas redundantes?;
- ¿mantiene las restricciones después de muchos pasos?;
- ¿se recupera de una respuesta inválida de la herramienta?;
- ¿evita repetir acciones que ya fallaron?;
- ¿entrega un resultado verificable en lugar de detenerse en una explicación plausible?
Si el agente modifica código, datos o sistemas externos, mide también acciones no autorizadas y necesidad de supervisión humana. Un modelo algo más caro por token puede resultar más barato si reduce reintentos y revisión; uno barato puede ganar si su tasa de aceptación se mantiene con mucho volumen.
Contexto largo
GLM-5.3 y las variantes DeepSeek V4 documentadas llegan a 1 millón de tokens de contexto. DeepSeek V4 Pro anuncia además una salida máxima mayor: 384.000 frente a 128.000 tokens de GLM-5.3.
Pero «cabe en la ventana» no significa «lo usa bien». Antes de basar una arquitectura en esas cifras, prueba recuperación de detalles al principio y en medio del contexto, seguimiento de cambios entre archivos, precisión de citas y degradación de latencia. También registra cuántos tokens introduces realmente: enviar un repositorio entero puede ser peor que recuperar solo los archivos pertinentes.
Multimodalidad
Para vídeo o archivos además de imágenes, GLM-5.3-Flash documenta una superficie de entrada más amplia. Para DeepSeek, la opción visual revisada es deepseek-v4-flash-vision-exp, publicada como experimental y centrada en texto e imagen.
Esto no prueba que una variante entienda mejor una captura, un diagrama o un documento. Construye casos con el material real: texto pequeño, varias imágenes, tablas, páginas rotadas, elementos visuales ambiguos y preguntas que puedan comprobarse.
Acceso y control operativo
DeepSeek V4 Pro ofrece una ruta documentada de pesos MIT. Si necesitas operar el modelo en infraestructura propia, esa disponibilidad puede ser un criterio eliminatorio a su favor. Aun así, debes verificar la viabilidad del hardware, el comportamiento de la versión cuantizada y las condiciones de cualquier proveedor que aloje esos pesos.
Si vas a consumir una API desde España u otro país hispanohablante, una página pública accesible no confirma que puedas registrarte, pagar, recibir factura, cumplir residencia de datos o contratar un SLA. Valida esas condiciones en tu cuenta y con tus requisitos legales antes de comprometer una arquitectura.
Precio: compara el trabajo aceptado, no solo el token
Las tarifas cambian y pueden variar por caché, horario, impuestos y canal. Al 27 de agosto de 2026, la tarifa oficial en USD de Z.ai mostraba para GLM-5.3, por millón de tokens:
| Modelo | Entrada | Entrada en caché | Salida |
|---|---|---|---|
| GLM-5.3 | 1,40 USD | 0,26 USD | 4,40 USD |
La misma página mostraba para GLM-5.3-Flash una promoción temporal del 50 % —0,075 USD de entrada, 0,015 USD de entrada en caché y 0,25 USD de salida— hasta el 9 de septiembre de 2026 a las 24:00 UTC+8. No uses esos importes promocionales para proyectar meses posteriores sin volver a consultar la página.
Para DeepSeek V4 Pro, la tabla oficial distinguía horario valle y punta:
| DeepSeek V4 Pro, por 1 M de tokens | Valle | Punta |
|---|---|---|
| Entrada con acierto de caché | 0,022 USD | 0,044 USD |
| Entrada sin caché | 0,66 USD | 1,32 USD |
| Salida | 1,98 USD | 3,96 USD |
Un ejemplo sencillo: con 100.000 tokens de entrada sin caché y 20.000 de salida, la tarifa de lista sería aproximadamente 0,228 USD con GLM-5.3, 0,1056 USD con DeepSeek V4 Pro en valle y 0,2112 USD en punta. El ejemplo excluye herramientas, reintentos, impuestos, tipo de cambio y trabajo humano; tampoco dice qué modelo resolverá la tarea a la primera.
La métrica más útil es:
“coste por resultado aceptado = coste total de generación, herramientas y reintentos ÷ número de resultados que superan la revisión
Añade el tiempo de revisión humana cuando sea material. Así evitas que una tarifa baja esconda más correcciones o que una tarifa alta descarte un modelo que termina tareas difíciles con menos intentos.
Cómo hacer una prueba igualada en una tarde
No se encontró una evaluación independiente, repetida y contemporánea que enfrente GLM-5.3 y DeepSeek V4 Pro con el mismo endpoint, arnés, esfuerzo, prompts, herramientas, presupuesto y criterio de aceptación. La forma responsable de cerrar la elección es ejecutar una prueba pequeña propia.
1. Define entre 10 y 30 tareas representativas
Usa tareas reales pero desidentificadas. Incluye casos fáciles, normales y costosos. Para código, guarda commit inicial, pruebas y salida esperada. Para soporte o análisis, prepara una rúbrica verificable y ejemplos de errores graves.
2. Iguala las condiciones
Mantén constantes:
- prompt del sistema y mensaje del usuario;
- archivos, contexto recuperado y orden de entrada;
- herramientas, permisos y número máximo de llamadas;
- nivel de
reasoning_effort; - timeout y política de reintentos;
- criterio de éxito y evaluador;
- presupuesto máximo por tarea.
Si una API no permite igualar un parámetro, regístralo como diferencia en vez de ocultarlo.
3. Repite y registra fallos
Ejecuta cada caso al menos tres veces si la variabilidad puede cambiar la decisión. Registra por separado:
- éxito al primer intento;
- éxito tras reintento;
- error de herramienta o de formato;
- alucinación o cambio no solicitado;
- latencia hasta resultado aceptado;
- tokens sin caché, tokens con caché y tokens de salida;
- minutos de revisión humana.
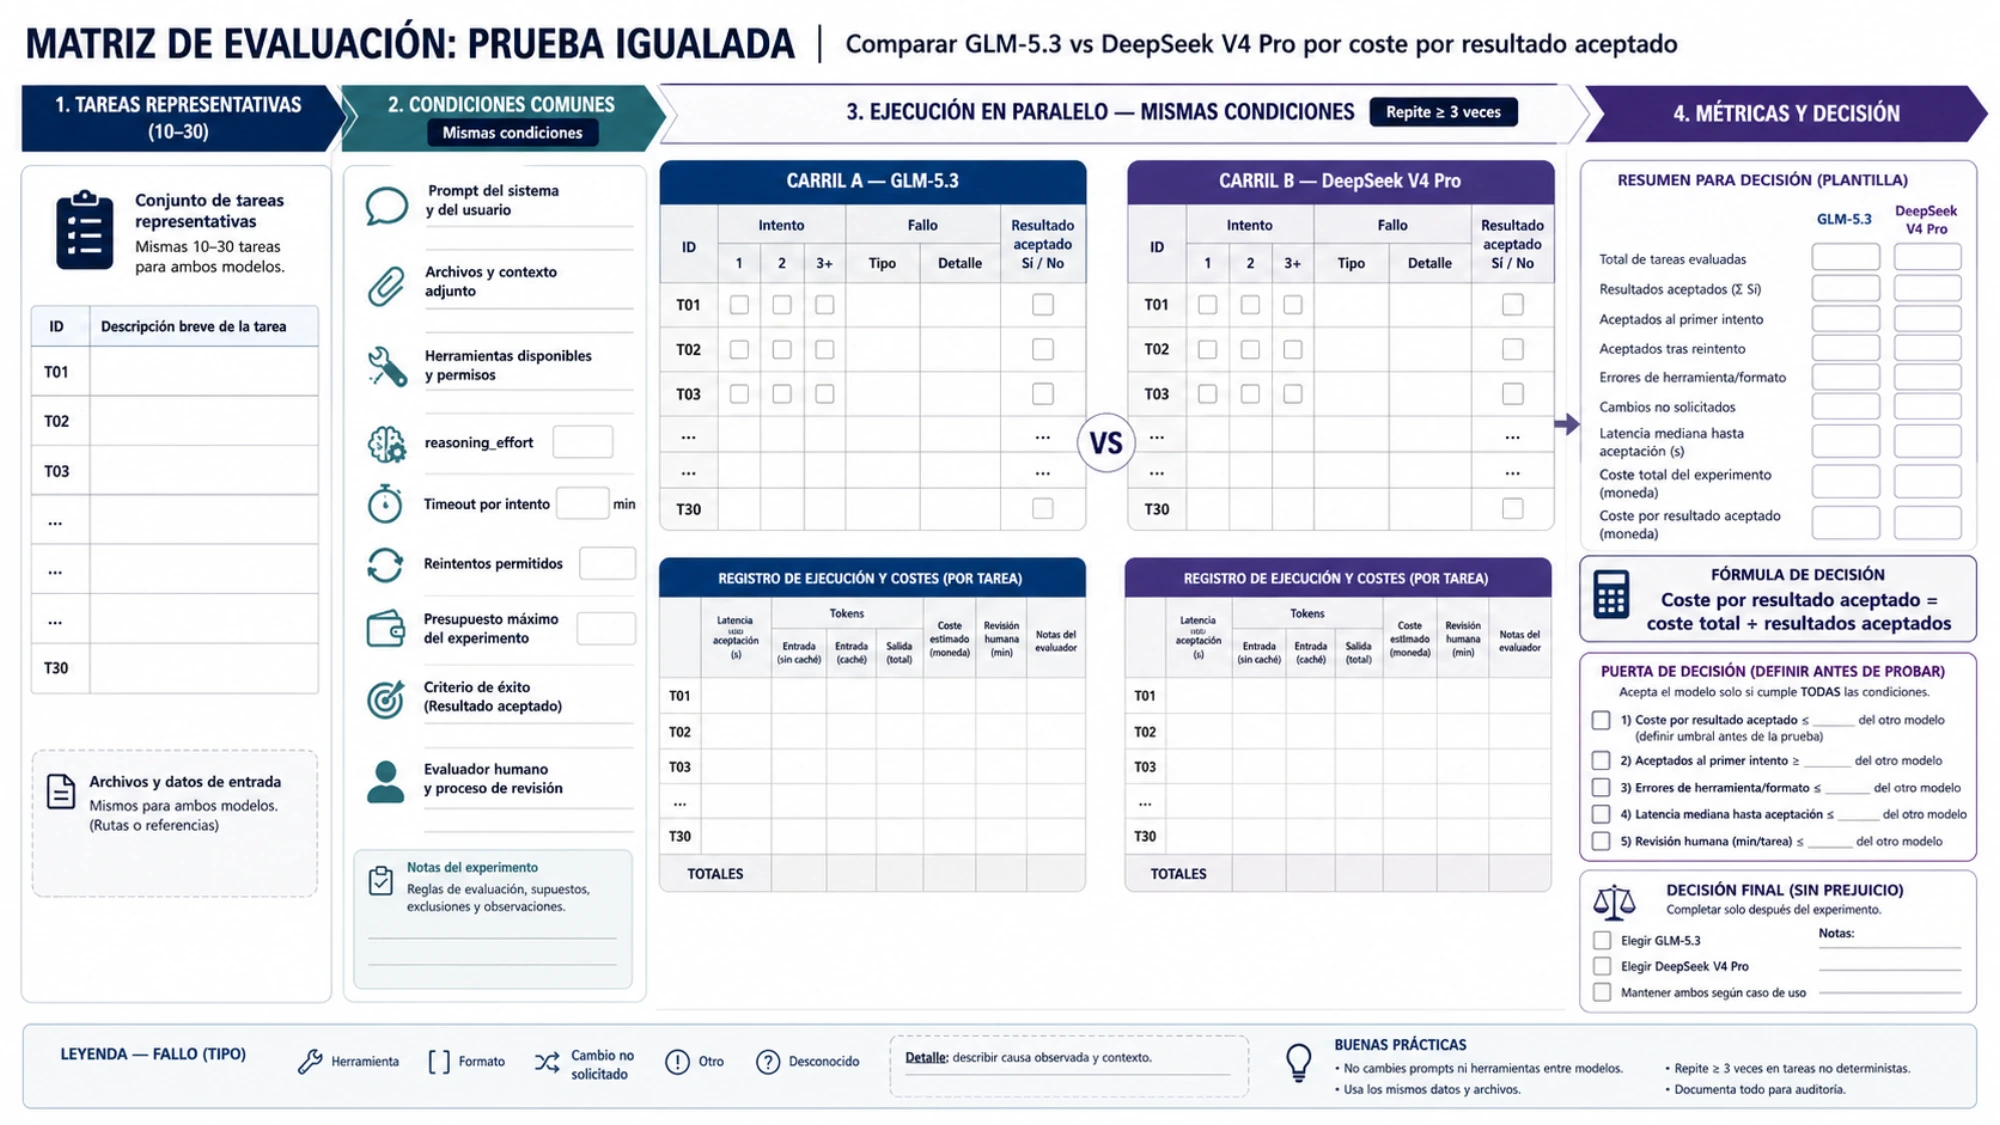
4. Decide con umbrales, no con una media única
Un modelo puede ganar en coste medio y perder en el 5 % de tareas donde un fallo es caro. Define antes los límites: por ejemplo, cero cambios fuera de alcance, al menos 90 % de pruebas superadas, menos de dos llamadas fallidas por tarea o latencia p95 por debajo de tu objetivo.
La elección final puede ser una ruta, no un único proveedor: Flash para clasificación y tareas de bajo riesgo; Pro o flagship para cambios complejos; y escalado humano cuando falle una regla crítica. Confirma que esa ruta cumple tus condiciones de datos, pago y disponibilidad.
Recomendación por escenario
| Si tu prioridad es… | Punto de partida | Motivo | Condición de salida |
|---|---|---|---|
| Agentes de código complejos | GLM-5.3 y DeepSeek V4 Pro | Son los candidatos actuales comparables de mayor nivel | Quédate con el que logre más tareas aceptadas bajo el mismo presupuesto |
| Coste y alto volumen | Añadir ambas variantes Flash | El precio por token puede cambiar mucho la economía | Descarta cualquier opción que no alcance tu umbral de calidad o estabilidad |
| Imágenes, vídeo o archivos | Probar GLM-5.3-Flash | Documenta una entrada multimodal amplia | Verifica formatos y calidad en tu endpoint real |
| Texto e imagen con DeepSeek | DeepSeek V4 Flash Vision Exp | Es la variante visual vigente revisada | No la promociones a producción sin validar su estado experimental |
| Pesos y operación propia | DeepSeek V4 Pro 0813 | Pesos publicados bajo MIT | Calcula infraestructura y verifica la paridad de la variante desplegada |
| Compras o datos regulados | Ninguno hasta completar diligencia | La documentación pública no confirma ajuste regional o contractual | Exige respuestas sobre facturación, residencia, retención, SLA y soporte |
Preguntas frecuentes
¿Es mejor GLM-5.3 que DeepSeek V4 Pro para programar?
No está demostrado de forma general. Los fabricantes publican mejoras y benchmarks, pero no comparten un único arnés totalmente igualado. Prueba ambos sobre tus repositorios y mide parches aceptados, pruebas superadas, acciones fuera de alcance, reintentos y coste total.
¿Cuál es más barato?
Depende del horario, la caché, la proporción entre entrada y salida y la tasa de éxito. En el ejemplo de tarifa de lista anterior, DeepSeek V4 Pro cuesta menos por una ejecución concreta, sobre todo en valle. Eso no garantiza menor coste por resultado aceptado. GLM-5.3-Flash tenía además una promoción temporal que debe volver a verificarse.
¿Cuál admite más contexto?
Los modelos actuales revisados documentan hasta 1 millón de tokens de contexto. DeepSeek V4 Pro documenta una salida máxima de 384.000 tokens y GLM-5.3, 128.000. Evalúa recuperación y precisión con contextos reales; el máximo no equivale a uso efectivo.
¿Puedo usar cualquiera desde España?
No se puede confirmar solo con las páginas públicas revisadas. Comprueba alta de cuenta, medios de pago, impuestos, facturación, restricciones regionales, residencia y retención de datos, entrenamiento con datos, SLA y soporte antes de contratar.
¿Debo elegir un solo modelo?
No necesariamente. Un enrutamiento sencillo puede usar Flash para tareas baratas y repetibles, y reservar GLM-5.3 o DeepSeek V4 Pro para casos complejos. La ruta solo merece la pena si el clasificador y los fallbacks no añaden más errores y coste de los que ahorran.
Conclusión
La comparación actual es GLM-5.3 frente a DeepSeek V4 Pro, no GLM-5.2 frente a una variante nueva elegida al azar. GLM-5.3 ofrece un contrato claro para texto, contexto largo y razonamiento siempre activo; su variante Flash amplía la entrada multimodal. DeepSeek V4 Pro combina contexto largo, herramientas, varias interfaces de API y una ruta documentada de pesos MIT; su familia Flash cubre volumen y una opción visual experimental.
La elección defendible no sale de sumar benchmarks incompatibles. Selecciona la pareja adecuada, ejecuta tareas iguales, mide coste por resultado aceptado y aplica un límite explícito para fallos caros. Con ese procedimiento, «GLM o DeepSeek» deja de ser una disputa de marcas y se convierte en una decisión reproducible para tu sistema.