결론부터: 예산이 먼저면 DeepSeek, 실패 비용이 먼저면 GPT를 검증한다
2026년 8월 13일 현재 비교 대상은 DeepSeek-V4-Pro-0813과 GPT-5.6 Sol이다. DeepSeek API 모델명은 deepseek-v4-pro이고, OpenAI의 gpt-5.6 별칭은 GPT-5.6 Sol을 가리킨다. 예전 DeepSeek V4 Pro, Flash, GPT-5 또는 GPT-5.5 결과를 이 조합의 현재 성능으로 간주하면 안 된다.
첫 시험 대상을 하나 골라야 한다면 다음처럼 시작하는 것이 합리적이다.
- 호출량이 많고 토큰 비용이 가장 큰 제약이라면 DeepSeek V4 Pro 0813을 먼저 시험한다. 공식 정가 차이가 크고, 제3자 측정에서도 비용과 출력 속도 측면의 우세가 관측됐다.
- 복잡한 작업의 실패가 리뷰·롤백 비용으로 크게 이어진다면 GPT-5.6 Sol을 먼저 시험한다. 다만 이 판단은 제3자 종합 지표가 실제 업무에서도 재현되는지 확인하는 출발점이지, 한국어 코딩 업무의 승자 선언이 아니다.
- 이미지 입력이 필수라면 공식적으로 이미지 입력을 명시한 GPT-5.6 Sol부터 검증할 이유가 분명하다. 반대로 자체 호스팅이 전제라면 공개 가중치와 API 제공 모델의 동일성이 확인되기 전까지 이 API 비교로 결론 내리지 않는다.
두 모델을 같은 API 제공 조건, 추론 강도(reasoning effort), 테스트 하네스, 작업 묶음, 반복 횟수로 비교한 독립적인 최신 실험은 아직 확인되지 않았다. 따라서 이 글의 직접 답은 “누가 무조건 이긴다”가 아니라 어떤 조건에서 무엇을 먼저 시험하고, 어떤 수치로 결정을 확정할지다.
비교 전에 모델과 날짜를 고정해야 한다
OpenAI 모델 문서는 GPT-5.6 Sol을 GPT-5.6 계열의 최상위 모델로 설명하며, gpt-5.6 별칭이 Sol로 연결된다고 명시한다. 추론 강도는 none, low, medium, high, xhigh, max를 지원한다.
DeepSeek 업데이트에 따르면 DeepSeek V4 Pro는 2026년 8월 13일 App, Web, API에서 정식 출시됐다. API 이름은 deepseek-v4-pro이며, 가격·모델 표에서는 이 이름을 DeepSeek-V4-Pro-0813으로 연결한다. Responses API와 low, high, max 추론 강도도 지원한다.
이 날짜 고정은 형식적인 주의사항이 아니다. 8월 13일 이전의 짧은 비교는 구버전일 수 있고, DeepSeek 가격은 며칠 뒤 바뀔 예정이다. 검색 결과의 숫자를 그대로 모으면 서로 다른 모델과 가격 시점이 한 표 안에 섞인다.
| 확인 항목 | DeepSeek V4 Pro 0813 | GPT-5.6 Sol | 결정에 미치는 영향 |
|---|---|---|---|
| API 식별자 | deepseek-v4-pro | gpt-5.6 별칭 → GPT-5.6 Sol | 로그에 별칭과 실제 버전을 함께 남긴다 |
| 컨텍스트 | 100만 토큰 | 105만 토큰 | 둘 다 장문 작업 후보지만 비용 규칙은 다르다 |
| 최대 출력 | 38만 4천 토큰 | 12만 8천 토큰 | 매우 긴 생성은 실제 제한과 품질을 따로 시험한다 |
| 이미지 입력 근거 | 이번 공식 모델 표에서는 확인하지 못함 | text·image 입력, text 출력 | 이미지 입력이 필수면 GPT의 공식 지원이 명확하다 |
| 추론 강도 | low·high·max | none·low·medium·high·xhigh·max | 이름이 같아도 계산량이 동등하다고 가정하지 않는다 |
| API 기능 | thinking/non-thinking, JSON, tool calls, Responses API, Anthropic-format API | 모델 문서 기준 Responses 계열 사용 | 기존 에이전트 하네스와의 호환성을 먼저 확인한다 |
정가 차이는 크지만 ‘승인된 작업 1건의 비용’은 아직 모른다
8월 13일 공식 API 정가만 보면 DeepSeek가 훨씬 저렴하다. 단위는 모두 USD/100만 토큰이다.
| 가격 시점 | 캐시 적중 입력 | 캐시 미적중 입력 | 출력 |
|---|---|---|---|
| DeepSeek, 8월 13일 현재 | $0.003625 | $0.435 | $0.87 |
| DeepSeek, 8월 16일 16:00 UTC 이후 off-peak 예정 | $0.022 | $0.66 | $1.98 |
| DeepSeek, 8월 16일 16:00 UTC 이후 peak 예정 | $0.044 | $1.32 | $3.96 |
| GPT-5.6 Sol 표준 API | $0.50 | $5.00 | $30.00 |
DeepSeek의 새 가격은 한국시간으로 8월 17일 01:00 KST부터 적용될 예정이다. 공지된 peak 구간 01:00–04:00 UTC와 06:00–10:00 UTC는 각각 10:00–13:00 KST, 15:00–19:00 KST다. 예정 가격은 실제 적용 후 다시 확인해야 한다.
GPT-5.6 Sol은 입력이 272K 토큰을 넘으면 요청 전체에 입력 2배, 출력 1.5배 요율이 적용된다. 긴 컨텍스트를 쓸 수 있다는 사실과 그것이 경제적이라는 판단은 별개다. 세금, 게이트웨이 할증, 지역 결제 조건도 위 표에 포함되지 않는다.
예를 들어 캐시를 제외하고 한 번의 작업이 입력 100K, 출력 20K 토큰을 사용한다고 가정하면 정가 계산은 다음과 같다.
text작업 1회 토큰 비용
= 입력 토큰 / 1,000,000 × 입력 단가
+ 출력 토큰 / 1,000,000 × 출력 단가
- DeepSeek 8월 13일 가격:
0.1 × $0.435 + 0.02 × $0.87 = $0.0609 - DeepSeek 예정 off-peak:
0.1 × $0.66 + 0.02 × $1.98 = $0.1056 - DeepSeek 예정 peak:
0.1 × $1.32 + 0.02 × $3.96 = $0.2112 - GPT-5.6 Sol 표준 요율:
0.1 × $5 + 0.02 × $30 = $1.10
이 예시는 동일한 토큰 양을 썼다는 가정의 정가 계산일 뿐이다. 한 모델이 실패해서 세 번 재시도하거나 더 긴 추론 출력을 만든다면 실제 비용 순위가 달라질 수 있다. 그래서 최종 지표는 호출 1회의 가격이 아니라 다음 값이어야 한다.
text승인된 작업 1건당 비용
= 전체 실행과 재시도에 청구된 금액 / 수용 테스트를 통과한 작업 수
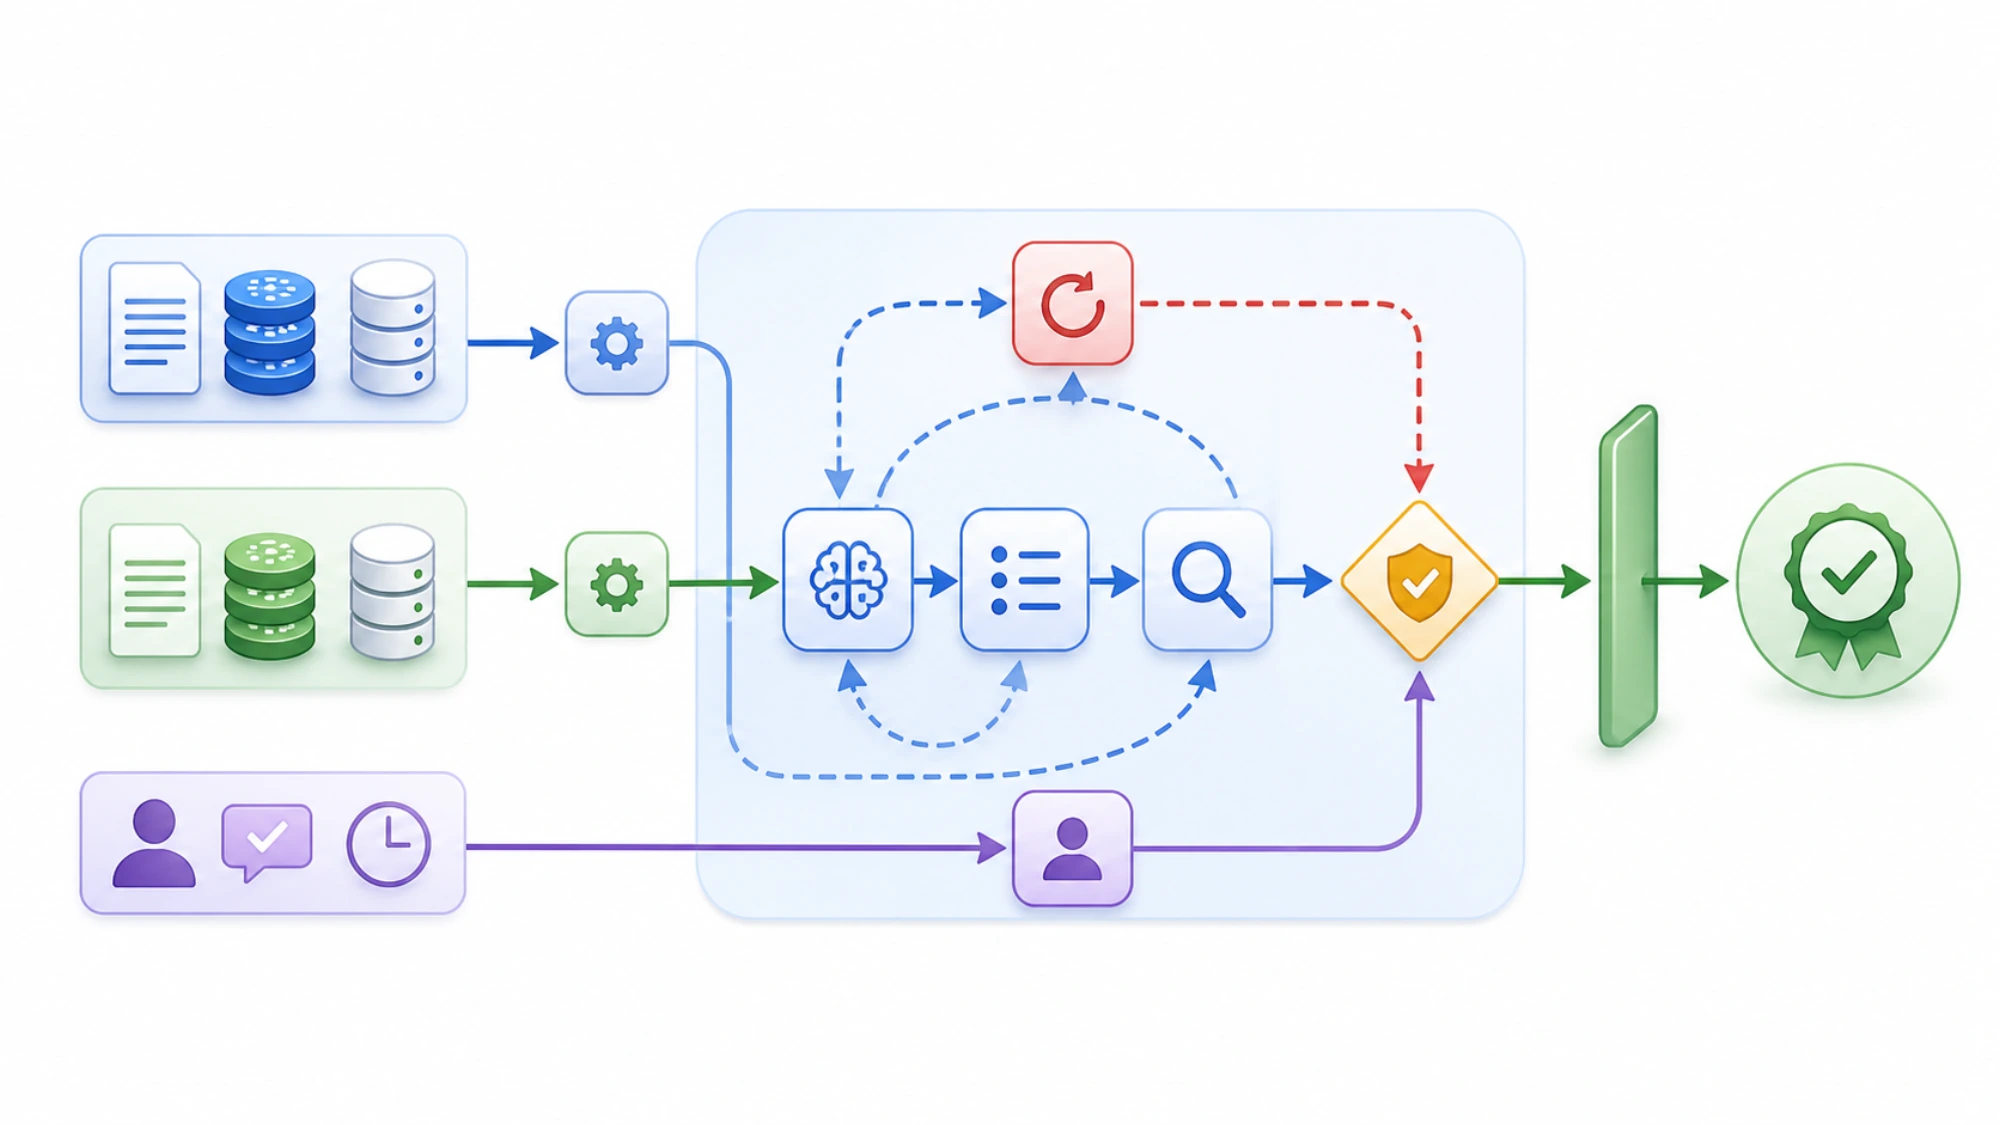
정가 비교는 출발점이다. 실패, 재시도, 사람이 수정한 시간까지 의사결정에 넣어야 한다.
공개 측정은 방향을 보여 줄 뿐, 한국어 업무의 승자를 증명하지 않는다
Artificial Analysis 비교는 DeepSeek V4 Pro 0813 Max Effort와 GPT-5.6 Sol high를 비교해 Intelligence Index 53 대 57, 혼합 가격 $0.18 대 $4.35, 출력 속도 약 83 대 56 tokens/s, 첫 토큰 도달 시간 1.63초 대 19.28초를 보고한다.
이 숫자에서 읽을 수 있는 방향은 분명하다. 해당 측정에서는 GPT-5.6 Sol의 종합 지능 지표가 더 높았고, DeepSeek V4 Pro는 혼합 가격과 출력 속도에서 유리했다. 하지만 다음 이유로 “GPT는 품질 승자, DeepSeek는 속도 승자”라고 일반화할 수는 없다.
- 추론 강도 표기가
Max와high로 다르고, 서로 다른 회사의 명칭이 같은 계산량을 뜻하지 않는다. - 혼합 가격은 cache/input/output을 7:2:1로 섞은 분석기관의 계산 방식이다. 각 팀의 실제 토큰 비율과 다를 수 있다.
- 종합 벤치마크는 저장소 수정, tool call 복구, 한국어 요구사항 준수 같은 개별 업무의 성공률을 대신하지 않는다.
- 네트워크 위치, API 제공 경로와 순간 부하가 지연 시간에 영향을 줄 수 있다.
따라서 공개 측정은 첫 후보를 정하는 초기 가설로만 쓰고, 운영 모델은 자신의 수용 테스트 결과로 선택해야 한다. 특히 “4점의 Intelligence Index 차이가 우리 업무의 실패율을 얼마나 줄이는가”와 “가격 차이가 재시도를 포함해도 유지되는가”가 실제 질문이다.
업무별 첫 시험 대상
DeepSeek V4 Pro 0813을 먼저 시험할 조건
다음 조건이 겹치면 DeepSeek부터 작은 운영 유사 테스트를 돌릴 가치가 크다.
- 대량 코드 변환, 문서 처리, 반복 에이전트 단계처럼 토큰 사용량이 커서 예산이 가장 먼저 제한된다.
- 결과를 단위 테스트, 스키마 검증기, 컴파일러, 정답 데이터처럼 자동 검증할 수 있다.
- 일부 실패를 재시도해도 낮은 정가가 유지되는지 확인하고 싶다.
- 매우 긴 출력을 요구하거나 Responses API·tool calls·Anthropic-format 호환을 기존 하네스에서 확인해야 한다.
- 8월 17일 KST 이후에는 peak/off-peak 가격을 실제 실행 시각과 함께 기록할 수 있다.
단, 싼 호출을 많이 성공시키는 것과 싼 호출을 많이 발생시키는 것은 다르다. 검증기가 약한 업무라면 낮은 가격 때문에 품질 확인 비용이 사람에게 전가될 수 있다.
GPT-5.6 Sol을 먼저 시험할 조건
다음 상황에서는 GPT부터 시험해 더 높은 비용이 실패 감소로 회수되는지 확인한다.
- 복잡한 코딩·에이전트 작업에서 한 번의 잘못된 변경이 리뷰와 롤백 비용을 크게 만든다.
- Artificial Analysis의 더 높은 종합 지능 지표가 자신의 어려운 작업에서도 재현되는지가 핵심 가설이다.
- text와 image를 함께 입력해야 하며, 공식 모델 문서에 명시된 이미지 입력 지원이 필요하다.
none부터max까지 더 세분화된 추론 강도가 비용·품질 조절에 실제로 도움이 되는지 시험하려 한다.- 272K를 넘는 입력의 추가 요율까지 감당하면서도 긴 컨텍스트가 검색 결합 또는 분할 실행보다 낫다는 가설을 검증할 수 있다.
GPT를 먼저 시험한다는 것은 운영 채택을 미리 정한다는 뜻이 아니다. 비용이 높은 만큼 동일한 수용 기준에서 실패율이나 수정 시간을 충분히 줄이는지가 통과 조건이어야 한다.
지금은 둘 다 운영 결정을 보류할 조건
한국 계정의 결제 수단, 세금, 할당량, 데이터 저장 위치, 지원 조건, 네트워크 지연이 필수 요건이라면 공개 글로벌 문서만으로 선택하지 않는다. 두 서비스에 실제 사용할 계정과 배포 위치에서 확인해야 한다.
자체 호스팅이 필수인 경우도 마찬가지다. 공개 DeepSeek V4 Pro 가중치와 API에서 제공되는 DeepSeek-V4-Pro-0813이 바이트 단위 또는 동작 면에서 동일하다는 공식 근거는 이번 비교에서 확인되지 않았다. API 측정을 자체 호스팅 결과로 이전해서는 안 된다.
운영 결정을 위한 수용 테스트 설계
1020개 작업을 두 모델에서 최소 세 번씩 실행하면 60120회 호출이 필요하므로 임의의 “90분 완주”를 약속할 수는 없다. 대신 실제 결정을 왜곡하는 차이를 기록하고, 반복 가능한 조건을 최대한 맞춘다.
1. 대표 작업과 통과 기준을 먼저 잠근다
최근 실제 업무에서 10~20개를 고른다. 쉬운 예제만 모으지 말고 다음처럼 실패 비용이 다른 작업을 섞는다.
- 기존 저장소의 작은 버그 수정과 회귀 테스트 통과
- 여러 파일을 건드리는 기능 변경
- tool call이 필요한 조사·수정·검증 흐름
- 긴 문서에서 근거가 있는 구조화 결과 생성
- 한국어 제약, JSON schema, 금지 조건을 동시에 지키는 요청
각 작업에는 모델 출력을 보기 전에 통과·실패 조건을 적는다. 예를 들어 “테스트 통과”만으로 부족하다면 변경 범위, 요구사항 누락, 보안 퇴행, 사람 수정 시간도 기준에 넣는다.
2. 실행 조건을 맞추되 추론 강도 차이를 숨기지 않는다
가능하면 공식 API를 사용하고 동일한 system prompt, tool schema, timeout, 최대 출력, 소스 스냅샷을 적용한다. 양쪽의 high를 한 번 맞춰 볼 수는 있지만, 같은 이름이 같은 계산량을 뜻한다고 쓰지 않는다. 실제 설정과 모델이 반환한 식별자, 실행 시각을 로그에 남긴다.
temperature 같은 공통 파라미터가 모델별로 다르게 동작하거나 지원되지 않는다면 억지로 같게 만들지 말고 차이를 기록한다. 컨텍스트가 272K를 넘는 GPT 요청은 추가 요율 여부를 별도 표시한다.
3. 최소 3회 반복하고 ‘첫 성공’과 ‘총 성공’을 분리한다
한 번의 실행은 우연에 취약하다. 작업별로 최소 3회 반복하고 다음을 기록한다.
| 기록값 | 이유 |
|---|---|
| 첫 시도 통과 여부 | 재시도 없는 신뢰도를 본다 |
| 최종 통과 여부 | 허용된 재시도 후 실제 완수율을 본다 |
| input·cached input·output tokens | 정가를 실제 청구량에 연결한다 |
| 첫 토큰 시간·전체 시간 | 대화형 에이전트와 일괄 처리 차이를 본다 |
| tool error·retry 횟수 | 싼 호출이 실패로 상쇄되는지 본다 |
| 사람 수정 시간 | 자동 평가가 놓친 운영 비용을 본다 |
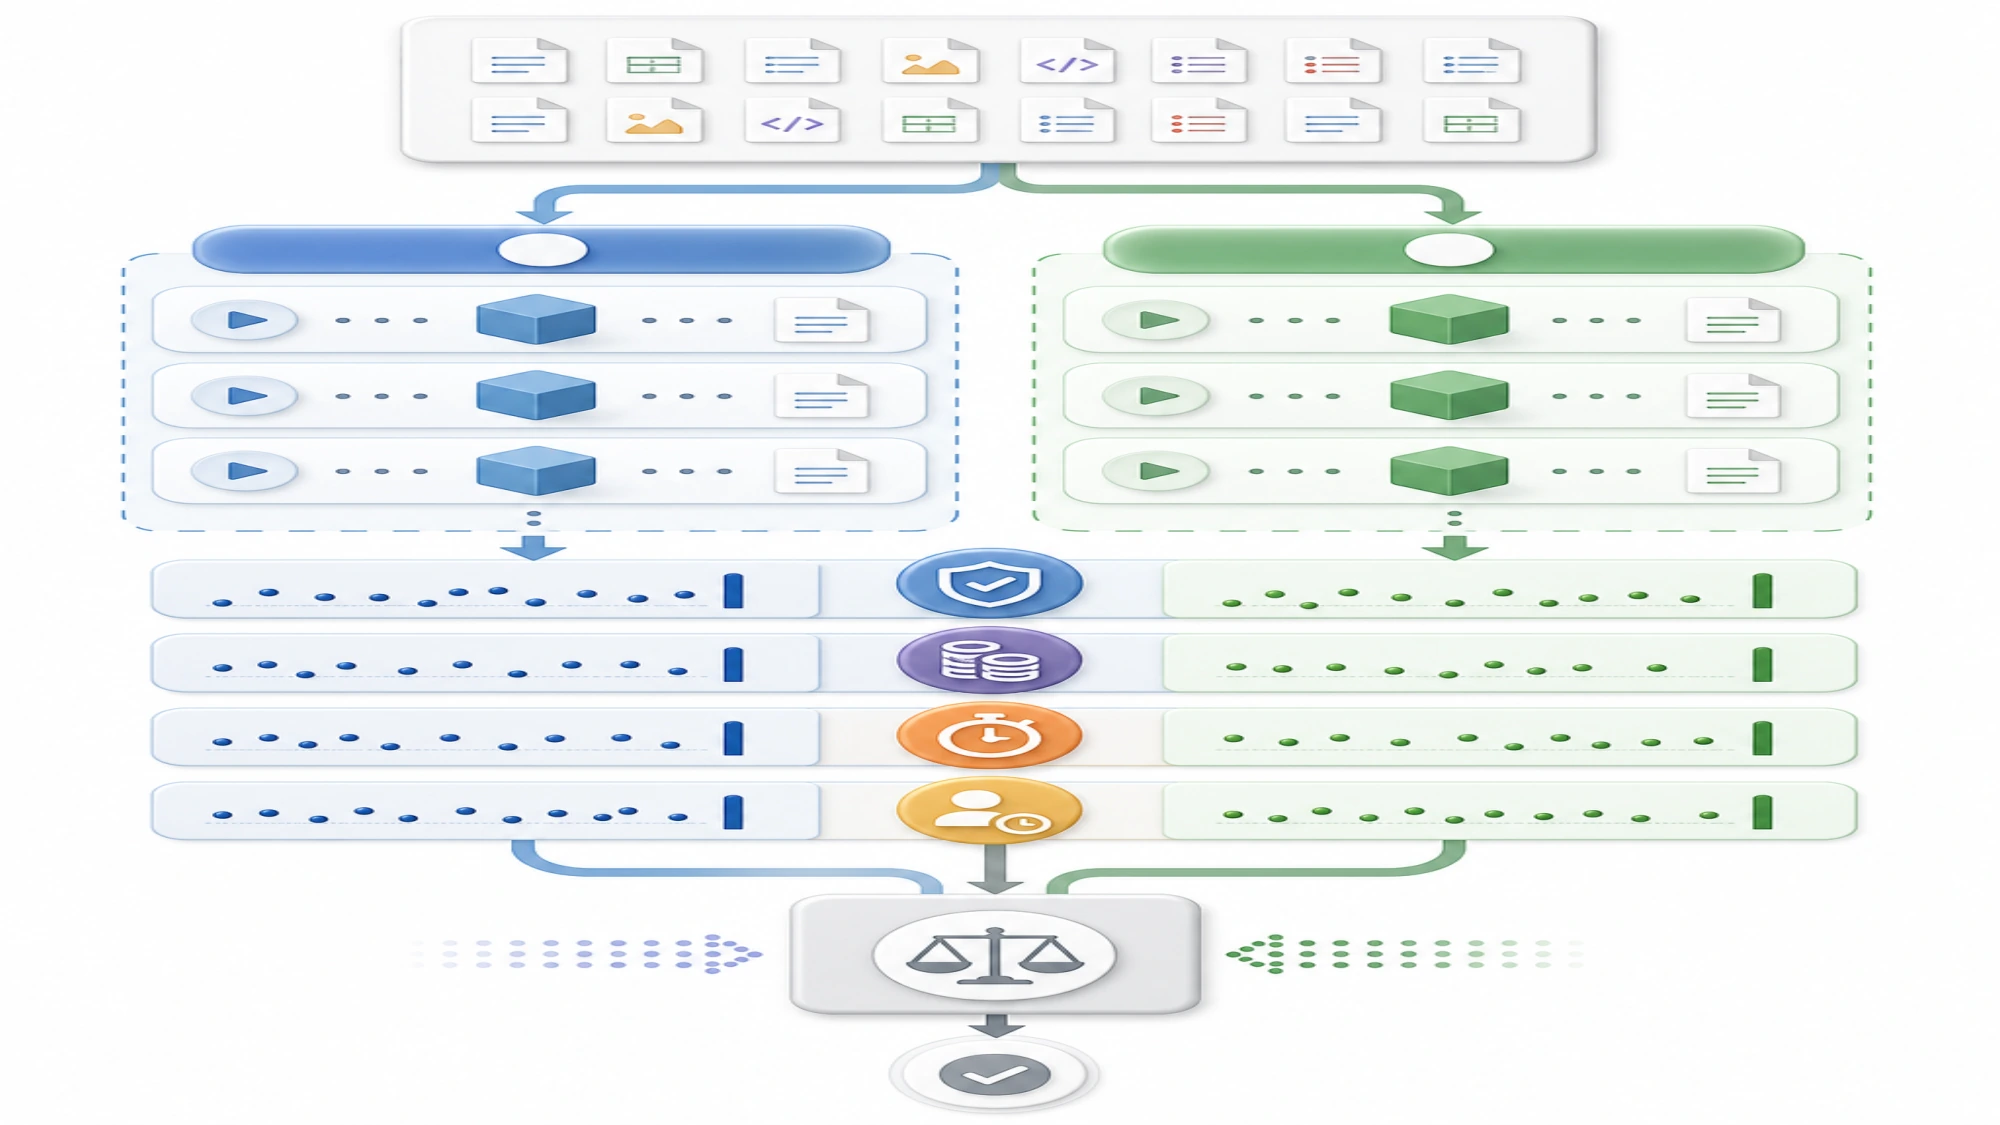
비교의 단위는 가장 멋진 출력 한 개가 아니라, 동일 기준으로 반복 측정한 업무 묶음 전체다.
4. 평균값 하나 대신 중단 기준으로 결정한다
배포 전 기준을 미리 정한다. 예시는 다음과 같다.
- DeepSeek가 첫 시도 성공률 목표를 충족하고 승인된 작업당 비용을 크게 낮추면 DeepSeek 채택
- GPT가 비용 차이보다 큰 폭으로 실패와 사람 수정 시간을 줄이면 GPT 채택
- 둘 다 통과하지만 업무별 강점이 갈리면 저비용 기본 경로와 고난도 작업 상향 경로로 라우팅
- 어느 쪽도 보안·정확성 기준을 충족하지 못하면 모델 선택이 아니라 작업 설계와 검증기를 먼저 수정
이 방식은 벤치마크 1등을 고르는 대신 팀이 실제로 감당할 수 있는 실패율과 비용을 고른다.
최종 선택 체크리스트
운영 후보를 확정하기 전에 다음 질문에 답할 수 있어야 한다.
- 로그의 실제 모델은
DeepSeek-V4-Pro-0813과 GPT-5.6 Sol인가? - DeepSeek 실행이 8월 16일 16:00 UTC 전인지 후인지, 이후라면 peak인지 off-peak인지 기록했는가?
- GPT 입력이 272K를 넘었을 때 전체 요청의 추가 요율을 계산했는가?
- 제3자 벤치마크와 우리 업무의 실측을 별도로 표시했는가?
- 토큰 단가가 아니라 승인된 작업 1건당 비용과 사람 수정 시간을 비교했는가?
- 한국 계정의 결제·세금·데이터·지연 조건을 실제 계정과 실행 위치에서 확인했는가?
- 자체 호스팅 결과와 API 결과를 동일하다고 가정하지 않았는가?
현재 공개 근거로 방어할 수 있는 선택은 여기까지다. 비용 제약이 먼저라면 DeepSeek V4 Pro 0813, 어려운 작업에서 실패를 줄일 가능성이 먼저라면 GPT-5.6 Sol을 첫 후보로 잡되, 운영 모델은 같은 수용 테스트로 정한다. 새 DeepSeek 가격이 적용되거나 동일 조건의 반복 비교가 공개되면 가격과 품질 판단을 다시 계산해야 한다.