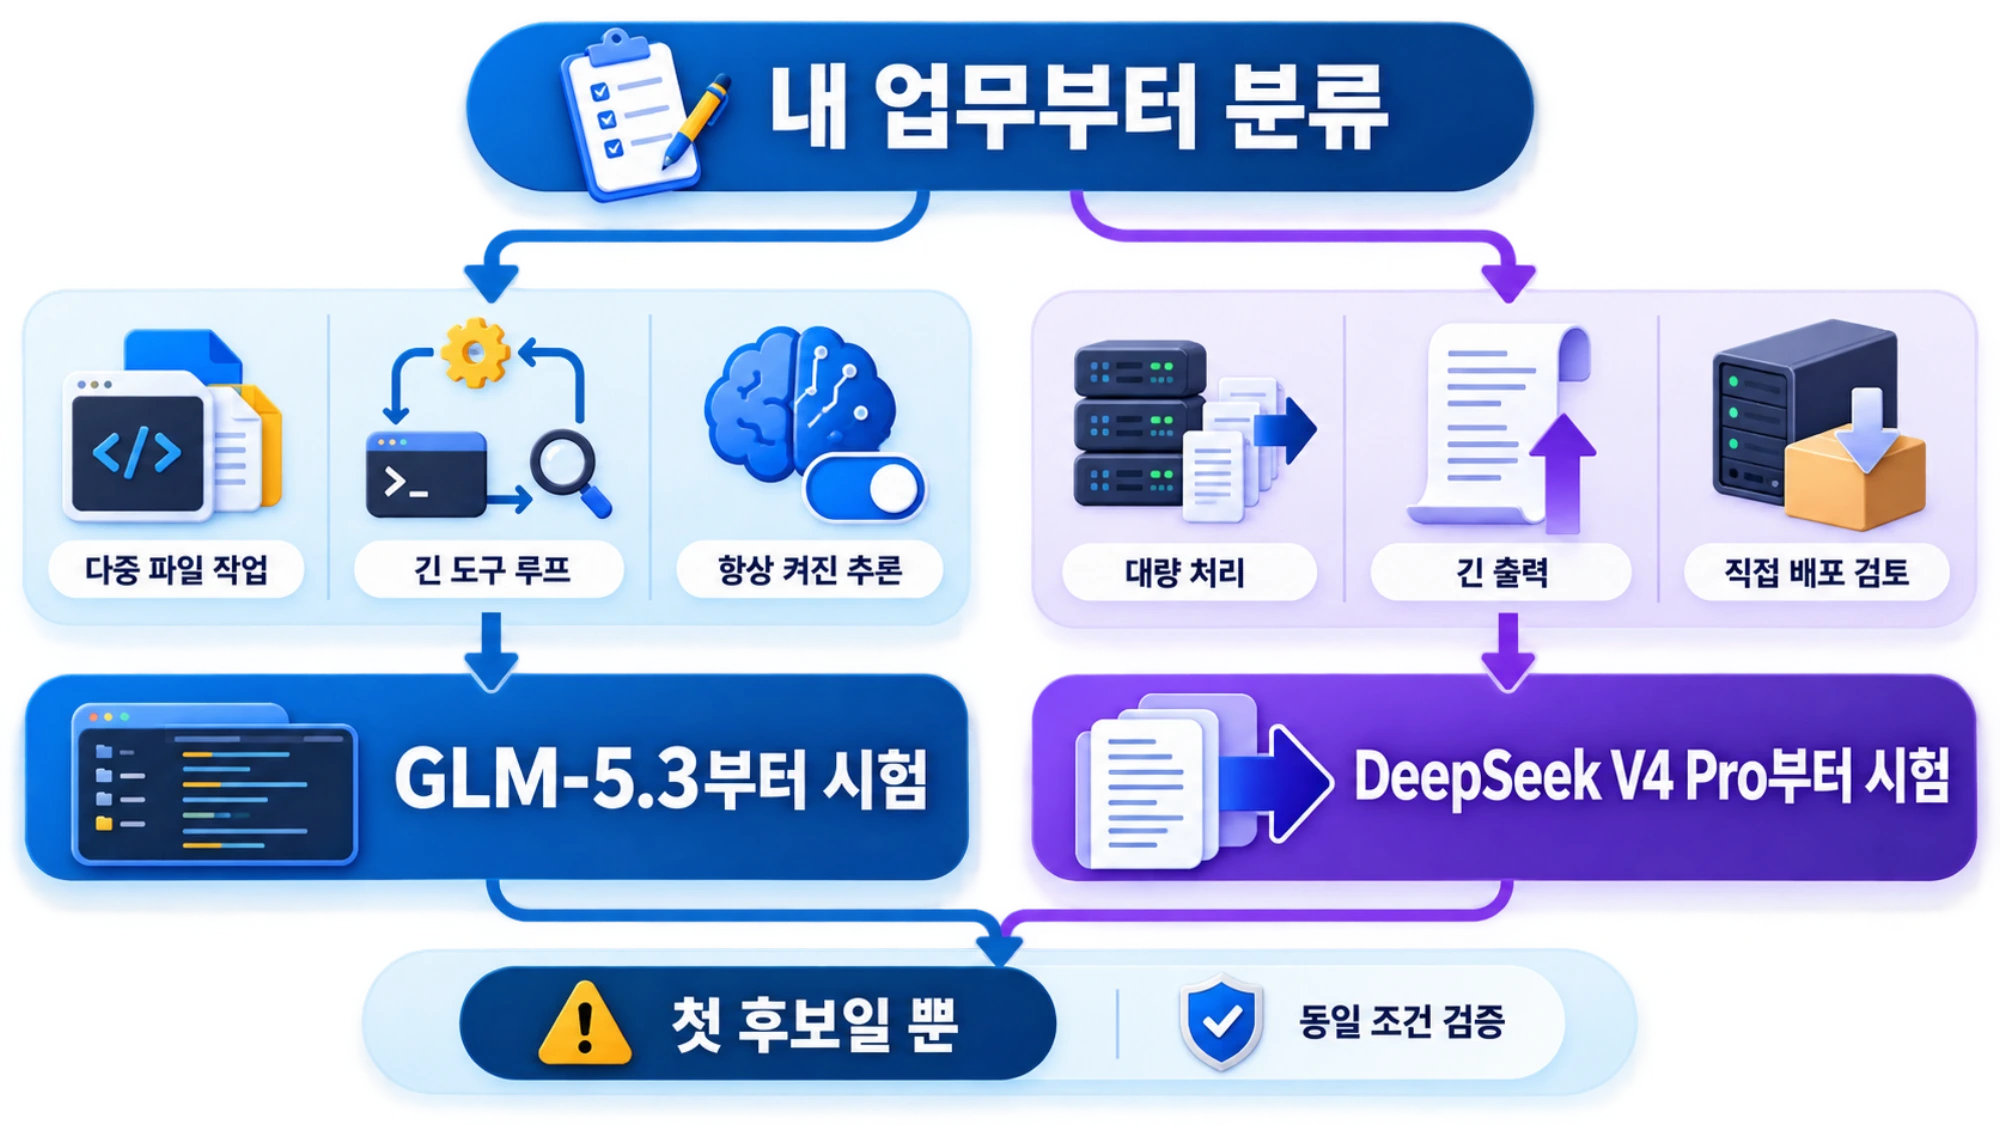
결론부터 말하면, 모든 작업에서 앞서는 한 모델은 아직 확인되지 않았다. 2026년 8월 27일 기준으로 대량 API 처리와 긴 출력, 오픈 가중치가 중요하다면 DeepSeek V4 Pro를 먼저 시험할 이유가 크다. 항상 켜지는 추론과 긴 도구 실행을 전제로 한 코딩·에이전트 작업이라면 GLM-5.3을 첫 후보로 둘 수 있다. 다만 후자는 공급사 설명만으로 우위를 확정할 수 없으므로, 실제 저장소와 도구를 사용한 동일 조건 평가가 필요하다.
두 모델 모두 100만 토큰 컨텍스트를 내세우지만, 이것이 100만 토큰짜리 작업을 정확히 끝낸다는 뜻은 아니다. 가격표 역시 토큰 단가만 보여줄 뿐 재시도, 도구 호출, 캐시 적중, 검수와 수정 비용까지 포함하지 않는다. 따라서 선택 순서는 현재 모델을 정확히 식별하고 → 운영 조건을 비교하고 → 내 작업으로 총비용을 재는 것이 안전하다.
먼저 비교 대상을 고정하자
검색 결과에는 GLM-5.2, DeepSeek V3.2와 V4 프리뷰가 여전히 섞여 있다. 현재 API를 평가한다면 다음 두 ID를 기준으로 요청과 로그를 남겨야 한다.
| 항목 | GLM-5.3 | DeepSeek V4 Pro |
|---|---|---|
| API 모델 ID | glm-5.3 | deepseek-v4-pro (현재 제공 버전: DeepSeek-V4-Pro-0813) |
| 공식 위치 | Z.ai의 최신 플래그십 모델 | 2026년 8월 13일 GA, 앱·웹 Expert Mode와 API 제공 |
| 입력 | 텍스트 | 텍스트 |
| 컨텍스트 | 100만 토큰 | 100만 토큰 |
| 최대 출력 | 12만 8천 토큰 | 최대 38만 4천 토큰 |
| 추론 제어 | 추론이 항상 켜짐, low·high·max | thinking/non-thinking 및 low·high·max |
| 주요 API 기능 | API와 Coding Plan 경로 | Tool Calls, JSON, Responses API, Anthropic API |
| 가중치 | GLM-5.3 가중치 공개 완료 여부는 확인되지 않음 | 공식 Hugging Face 저장소에 MIT 라이선스로 공개 |
사양은 출발점일 뿐이다. 긴 최대 출력은 대형 리팩터링 계획이나 장문 보고서에 여유를 주지만, 필요한 만큼만 출력하는 작업에서는 이점이 사라진다. 반대로 추론이 항상 켜지는 설계는 복잡한 작업에서 도움이 될 수 있지만, 짧고 반복적인 변환 작업에서는 지연과 비용을 별도로 확인해야 한다.
공식 기능은 Z.ai의 GLM-5.3 문서와 DeepSeek API 가격·모델 표에서 다시 확인할 수 있다. 배포 전에는 응답의 실제 served version도 로그에 기록하자. 별칭이 가리키는 버전은 바뀔 수 있기 때문이다.
작업별 1차 선택 규칙
GLM-5.3을 먼저 시험할 상황
- 여러 파일을 넘나들며 계획, 수정, 테스트를 반복하는 코딩 에이전트
- 도구 호출이 길게 이어지고 중간 상태를 유지해야 하는 업무
- 추론을 끄지 않고
reasoning_effort로 깊이만 조절하려는 팀 - Z.ai API 또는 Coding Plan이 기존 개발 환경과 더 잘 맞는 경우
Z.ai는 GLM-5.3이 이전 세대보다 코딩과 장기 에이전트 성능을 개선했다고 보고한다. 하지만 공급사가 선택한 벤치마크와 실행 조건이 포함된 결과다. “GLM이 장기 작업에서 반드시 이긴다”가 아니라, 장기 도구 루프를 포함한 자체 평가의 첫 후보로 해석하는 편이 정확하다.
DeepSeek V4 Pro를 먼저 시험할 상황
- 토큰 처리량이 크고 API 명목 단가가 중요한 배치 작업
- 하나의 응답에서 매우 긴 출력을 받아야 하는 작업
- thinking과 non-thinking을 작업별로 나눠 운영하려는 경우
- OpenAI Responses API 또는 Anthropic API 호환 경로가 필요한 경우
- 가중치를 직접 내려받아 배포 가능성을 검토해야 하는 경우
DeepSeek는 DeepSeek-V4-Pro-0813 가중치를 공식 Hugging Face 저장소에 MIT 라이선스로 공개했다. 이것은 자체 배포라는 선택지가 있다는 뜻이지, 필요한 GPU 수나 양자화 후 품질, 보안·컴플라이언스 비용이 작다는 뜻은 아니다.
이미지 입력이 필요하다면 주력 모델끼리 비교하지 말 것
glm-5.3은 텍스트 전용이다. Z.ai는 이미지·비디오·파일 입력을 받는 GLM-5.3-Flash를 별도로 문서화하고 있다. DeepSeek도 deepseek-v4-flash-vision-exp를 공개했지만 실험 모델이다. 이미지 이해가 필수라면 GLM-5.3 대 V4 Pro의 일반 비교가 아니라, 해당 멀티모달 변형의 엔드포인트 지원·안정성·출력 품질을 별도 평가해야 한다.
API 가격은 어떻게 비교해야 하나
2026년 8월 27일 공개 USD 정가를 100만 토큰당으로 맞추면 다음과 같다.
| 비용 항목 | GLM-5.3 | DeepSeek V4 Pro |
|---|---|---|
| 캐시 미적중 입력 | $1.40 | 비혼잡 $0.66 / 혼잡 $1.32 |
| 캐시 적중 입력 | $0.26 | 비혼잡 $0.022 / 혼잡 $0.044 |
| 출력 | $4.40 | 비혼잡 $1.98 / 혼잡 $3.96 |
예를 들어 캐시 미적중 입력 1,000만 토큰과 출력 200만 토큰만 계산하면 GLM-5.3은 $22.80, DeepSeek V4 Pro는 비혼잡 시간 $10.56, 혼잡 시간 $21.12다. 이 계산에는 세금, 환율, 도구 사용, 실패한 호출과 사람의 재작업이 없다.
그래서 “DeepSeek가 더 싸다”는 문장은 같은 토큰량을 처리할 때의 공개 정가로 범위를 좁혀야 한다. 한 모델이 더 많은 토큰이나 재시도를 사용하거나 결과 검수 시간이 늘면 실제 작업당 비용은 뒤집힐 수 있다. DeepSeek의 시간대별 구분과 가격도 바뀔 수 있으므로 대량 실행 직전에 공식 표를 다시 확인하는 것이 좋다.
참고로 GLM-5.3-Flash에는 2026년 9월 9일 24:00(UTC+8)까지 한시 할인이 표시되어 있다. 이를 주력 glm-5.3 가격과 섞거나, 종료 후에도 상시 가격처럼 계산하면 안 된다.
공개 벤치마크가 승자를 정하지 못하는 이유
양사는 새 모델의 코딩·에이전트 성능 향상을 각각 발표했다. 문제는 동일한 엔드포인트, 하니스, 추론 강도, 프롬프트, 도구 예산과 평가기를 공유한 정면 비교가 아니라는 점이다. 서로 다른 공급사 점수를 한 표에 붙이는 것만으로는 공정한 순위가 되지 않는다.
제3자 자료도 범위를 읽어야 한다. Aikido Security는 인터넷을 차단한 환경에서 최근 취약점 32개, 모델 10개, 사례별 3회 실행으로 사이버 보안 평가를 진행했다. 그 환경에서는 DeepSeek V4 Pro가 GLM-5.3보다 합산 취약점을 더 많이 찾았지만, 후보 결과와 잘못된 단서도 더 많이 냈다고 보고했다. 이는 해당 보안 하니스에서 재현할 가치가 있는 관찰이지 일반 코딩, 추론, 지연, 비용의 종합 우승 판정이 아니다.
현재 세대의 두 모델을 모든 조건이 같은 상태로 충분히 반복한 독립 비교는 이번에 확인한 공개 자료만으로 확립되지 않았다. 그러므로 실제 선택에는 작은 사내 평가가 벤치마크 순위보다 유용하다.
30개 업무 샘플로 공정하게 시험하는 법
먼저 지난 업무에서 대표 샘플 30개를 고른다. 단순 생성만 모으지 말고 짧은 수정, 다중 파일 리팩터링, 실패 복구, 도구 연속 호출, 장문 분석을 섞는다. 민감 정보는 제거하고, 모델마다 입력이 같도록 fixture로 고정한다.
각 샘플에는 사람이 느끼는 “좋음” 대신 관찰 가능한 완료 조건을 둔다.
yamltask_id: repo-refactor-07
fixture: fixtures/repo-refactor-07.tar.gz
acceptance:
  - test suite passes
  - public API remains backward-compatible
  - no new high-severity static-analysis finding
limits:
  reasoning_effort: high
  max_tool_calls: 30
  timeout_seconds: 900
  retries: 0
repeat: 3
record:
  - served_model_version
  - input_cached_tokens
  - input_uncached_tokens
  - output_tokens
  - tool_calls
  - wall_time
  - acceptance_result
  - reviewer_minutes
두 모델에는 같은 프롬프트, 도구 권한, 타임아웃, 추론 강도와 재시도 규칙을 적용한다. 한쪽은 전용 코딩 도구, 다른 쪽은 별도 하니스를 쓰면 모델 차이와 실행 환경 차이를 분리할 수 없다. 캐시는 두 모델 모두 끄거나, 같은 warm-up 정책으로 맞춘다.
평가는 최소 세 번 반복하고 다음 네 값을 함께 본다.
- 완료율: 객관적 acceptance를 통과한 비율
- 첫 시도 성공률: 재시도 없이 끝난 비율
- 작업당 총비용: API 비용 + 도구 비용 + 리뷰·수정 시간
- 꼬리 지연: 평균보다 실제 운영 장애를 잘 드러내는 p95 완료 시간
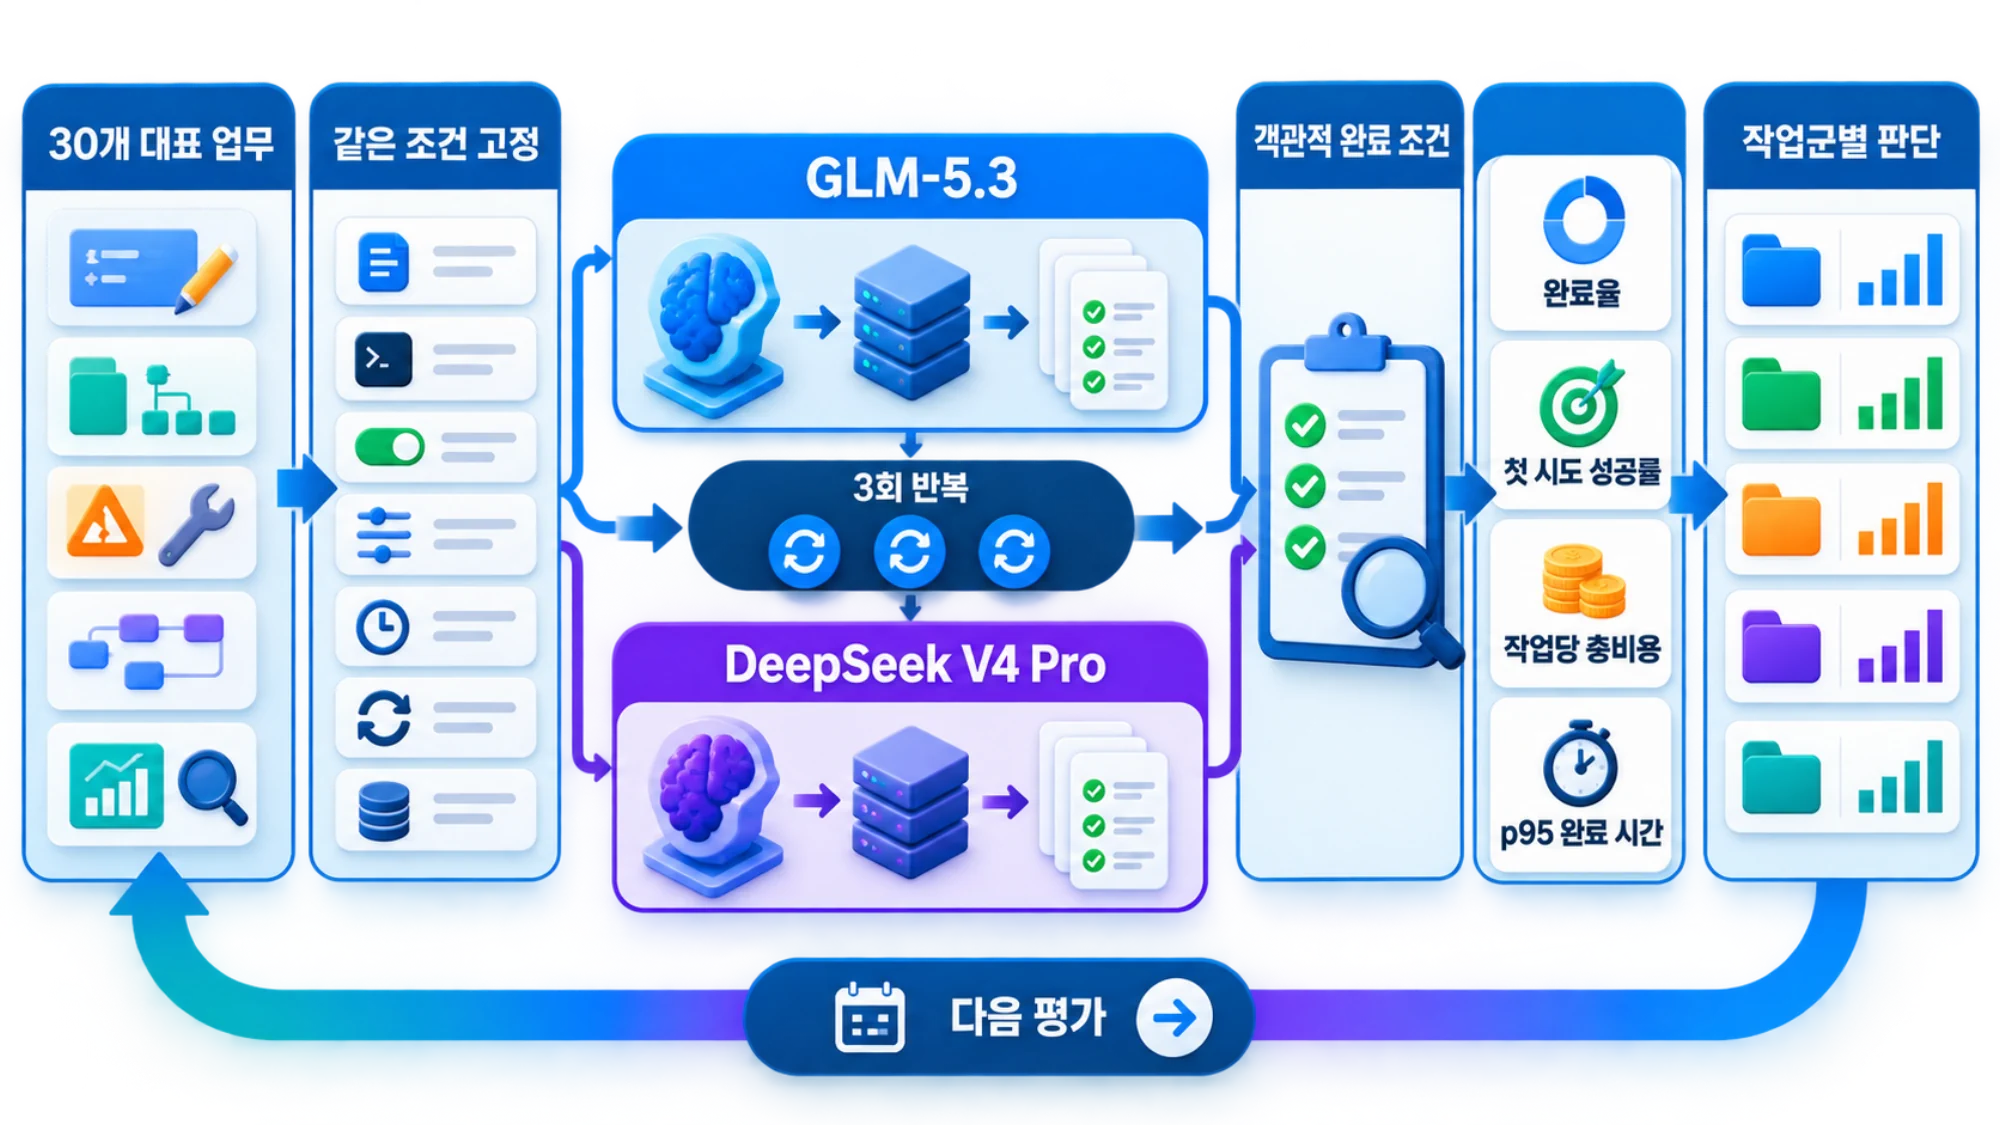
평균 점수 하나로 합치기보다 작업군별 결과를 유지하자. 배치 변환에는 DeepSeek를, 장기 에이전트에는 GLM을 쓰는 혼합 운영이 단일 모델 표준화보다 합리적일 수 있다. 차이가 작다면 가격 변동, 장애 시 대체 경로와 팀의 통합 비용까지 포함해 결정한다.
한국에서 도입하기 전에 확인할 운영 항목
공개 문서에 접속할 수 있다는 사실은 대한민국 계정으로 즉시 가입·결제할 수 있다는 증거가 아니다. 양쪽 모두 실제 조직 계정에서 다음 항목을 확인한 뒤 파일럿 예산을 승인하는 편이 안전하다.
- 한국 발급 결제수단 지원, 청구 통화, 부가세와 세금계산·증빙 방식
- 요청 데이터의 저장 기간, 학습 사용 여부, 데이터 위치와 삭제 절차
- 조직용 권한, 감사 로그, 사용량 한도와 키 회수 기능
- 대한민국에서 호출했을 때의 평균·p95 지연, 오류율과 rate limit
- SLA, 지원 채널, 조달 계약과 규제 요건 충족 여부
특히 소스 코드나 고객 데이터를 보낼 때는 무료 콘솔 테스트와 회사의 운영 승인을 같은 것으로 취급하지 말아야 한다. 지역 가용성, 결제, 법적 적합성은 공개 가격 페이지에서 확정되지 않았다.
자주 묻는 질문
코딩은 GLM-5.3과 DeepSeek V4 Pro 중 누가 더 좋은가?
현재 공개 근거만으로 보편적인 승자를 정할 수 없다. 양사 벤치마크는 실행 조건이 같지 않고, 제3자 보안 평가는 한정된 업무다. 다중 파일 수정, 테스트 통과, 재시도와 리뷰 시간을 포함한 자체 샘플로 판단해야 한다.
가장 저렴한 모델은 DeepSeek인가?
현재 공개된 동일 토큰 기준 정가는 DeepSeek V4 Pro가 GLM-5.3보다 낮다. 하지만 실제 작업당 비용에는 시간대, 캐시 적중, 토큰 사용량, 재시도, 도구 호출과 사람의 수정 시간이 들어간다. 대량 도입 전에는 실제 로그로 다시 계산해야 한다.
100만 토큰을 넣으면 저장소 전체를 한 번에 이해하나?
아니다. 100만 토큰은 입력 상한에 관한 공개 사양이다. 긴 문맥에서 중요한 요구를 유지하는 능력이나 수정 성공률을 보장하지 않는다. 저장소 규모별로 검색 전략, 컨텍스트 구성과 테스트 결과를 함께 검증해야 한다.
자체 서버에 배포하려면 어느 쪽이 분명한가?
DeepSeek V4 Pro는 공식 가중치와 MIT 라이선스가 확인된다. GLM-5.3의 현재 가중치 공개 완료 여부는 확인되지 않았다. 다만 오픈 가중치도 필요한 하드웨어, 양자화 품질, 보안 패치와 운영 인력까지 검토해야 실제 배포 가능성을 판단할 수 있다.
최종 선택: 승자보다 전환 규칙을 정하자
첫 파일럿은 간단하다. 비용 민감형 대량 처리와 긴 출력은 DeepSeek V4 Pro부터, 긴 도구 루프와 항상 켜진 추론을 시험하려면 GLM-5.3부터 시작한다. 그리고 같은 30개 샘플에서 완료율, 총비용, 리뷰 시간과 p95 지연을 기록한다.
한 모델이 핵심 작업군에서 명확히 앞서면 그곳에만 우선 적용하고, 결과가 비슷하면 더 저렴하거나 운영이 쉬운 쪽을 기본값으로 둔다. 가격이나 served version이 바뀌면 다시 30개 평가를 돌릴 수 있도록 fixture와 로그를 남겨 두자. 이 방식이면 새로운 모델 발표가 나올 때마다 홍보 문구에 따라 도구를 바꾸지 않고, 실제 업무 결과로 전환 여부를 결정할 수 있다.