Если нужен дешёвый первый прогон большого набора текстовых задач, задач по коду или сценариев с инструментами, начните с DeepSeek V4 Pro 0813. Если цена ошибки высока и вы готовы дороже заплатить за проверку потенциально более сильного результата, добавьте GPT-5.6 Sol как второй кандидат — либо начните с него на небольшой критичной выборке.
Это не объявление победителя. На 13 августа 2026 года нет независимого воспроизводимого теста текущей пары в одинаковых условиях: с одним провайдером, сопоставимым бюджетом рассуждений, одинаковыми инструментами, повторами и способом расчёта цены. Поэтому практичный ответ состоит из двух частей: сначала корректно определить модели, затем сравнить не цену токена, а стоимость принятой задачи.
Сначала исключите сравнение не тех вариантов
Запрос «DeepSeek V4 Pro против GPT-5.6» неоднозначен. В сравнительных сервисах GPT-5.6 может означать Sol или Luna, а рядом с DeepSeek V4 Pro встречается Flash. Числа для таких пар нельзя переносить на текущую пару.
В этой статье сравниваются только:
- GPT-5.6 Sol — официальная модель OpenAI; псевдоним
gpt-5.6в API ведёт на Sol; - DeepSeek-V4-Pro-0813 — версия, которой, согласно таблице DeepSeek, соответствует API-имя
deepseek-v4-pro.
Имена важны не только для аккуратности. Другая ветка модели, другой уровень глубины рассуждений или маршрут через посредника могут изменить качество, задержку и счёт. Перед тестом сохраните в журнале точный идентификатор модели, поставщика API и настройки каждого запуска.
Выберите первый тест по цене ошибки
| Ваша исходная ситуация | Первый кандидат | Почему это лишь гипотеза |
|---|---|---|
| Много недорогих прогонов, пакетная обработка, ранний отбор вариантов | DeepSeek V4 Pro 0813 | Официальная цена существенно ниже, но дешёвый ответ может не пройти ваш критерий приёмки |
| Небольшое число дорогих по последствиям задач | GPT-5.6 Sol | Сторонний агрегат показывает более высокий индекс качества, но это не доказывает победу на ваших задачах |
| Нужен вход с изображением | GPT-5.6 Sol в первом тесте | У Sol официально заявлены текстовые и графические входные данные; поддержку и качество нужного формата у альтернативы следует проверять отдельно |
| Длинный текстовый контекст и строгий бюджет | Тестировать оба на реальном размере запроса | У обеих моделей заявлено около 1 млн токенов контекста, но у Sol запросы свыше 272K входных токенов тарифицируются с повышающими коэффициентами |
| Нужна совместимость с Anthropic-форматом | DeepSeek V4 Pro 0813 в первом тесте | DeepSeek официально заявляет такой формат API, но совместимость интерфейса не гарантирует одинаковое поведение модели |
| Доступ, оплата или задержка из России критичны | Сначала проверить аккаунт и провайдера | Глобальная документация не подтверждает региональные способы оплаты, налоги, квоты, место обработки данных и поддержку |
Условный выбор полезнее общего рейтинга: он говорит, какое предположение проверить первым, а не подменяет вашу проверку чужим результатом.
Что подтверждено официально — и чего это не доказывает
По документации OpenAI, GPT-5.6 Sol поддерживает уровни глубины рассуждений (reasoning effort) none, low, medium, high, xhigh и max, контекст 1 050 000 токенов, максимум 128 000 выходных токенов, текстовые и графические входные данные и текстовый вывод.
В обновлениях DeepSeek указано, что DeepSeek V4 Pro стала общедоступной (GA) 13 августа 2026 года в приложении, веб-интерфейсе и API. API-имя осталось deepseek-v4-pro, появился нативный Responses API, а глубина рассуждений (thinking effort) поддерживает значения low, high и max. Таблица моделей и цен DeepSeek связывает это имя с DeepSeek-V4-Pro-0813 и указывает контекст 1 млн токенов, максимум 384K выходных токенов, режимы с рассуждением и без него, вывод JSON, вызовы инструментов, Responses API и Anthropic-формат.
Это подтверждает контракт интерфейса, но не сравнительное качество. Также нельзя автоматически переносить результаты API-модели на публичные веса: первичного подтверждения их полной идентичности в доступных материалах нет.
Цена API: сравнивайте на одной базе и с датой
Официальные цены ниже указаны за 1 млн токенов в долларах США и проверены 13 августа 2026 года.
| Модель и период | Некэшированный вход | Кэшированный вход | Выход |
|---|---|---|---|
| GPT-5.6 Sol, стандартный API | $5.00 | $0.50 | $30.00 |
| DeepSeek V4 Pro, тариф 13 августа 2026 | $0.435 | $0.003625 | $0.87 |
| DeepSeek V4 Pro, вне пиковых часов с 16 августа 16:00 UTC | $0.66 | $0.022 | $1.98 |
| DeepSeek V4 Pro, в пиковые часы с 16 августа 16:00 UTC | $1.32 | $0.044 | $3.96 |
Для GPT-5.6 Sol запросы более чем с 272K входных токенов стоят дороже: OpenAI применяет коэффициент 2× к входу и 1,5× к выходу для всего запроса. У DeepSeek новый тариф для пиковых и непиковых часов на момент проверки ещё не действовал, поэтому после 16 августа его нужно перепроверить. Указанные DeepSeek пиковые окна — 01:00–04:00 и 06:00–10:00 UTC; это 04:00–07:00 и 09:00–13:00 по московскому времени.
Цены посредников в рублях нельзя подставлять в эту таблицу без отдельной подписи: они могут включать собственную наценку, курс, способ кэширования и условия доступа.
Один расчёт показывает разрыв, а не победителя
Допустим, один запуск использует 100 000 некэшированных входных и 20 000 выходных токенов. Без налогов, повторов и инструментальных вызовов получится:
- GPT-5.6 Sol:
0,1 × $5 + 0,02 × $30 = $1,10; - DeepSeek V4 Pro по тарифу 13 августа:
0,1 × $0,435 + 0,02 × $0,87 = $0,0609; - DeepSeek V4 Pro по будущему непиковому тарифу:
$0,1056; - DeepSeek V4 Pro по будущему пиковому тарифу:
$0,2112.
Разрыв большой, но это стоимость одного запуска, а не готового результата. Если дешёвая модель требует больше повторов, ручной правки или исправлений после вызовов инструментов, разница на уровне принятой задачи сократится. Если оба ответа проходят критерий с первой попытки, более дорогой токен не создаёт дополнительной ценности.
Почему сторонний бенчмарк не даёт окончательного ответа
Artificial Analysis сообщает для DeepSeek V4 Pro 0813 Max Effort и GPT-5.6 Sol high следующие значения: Intelligence Index 53 против 57, расчётная смешанная цена $0,18 против $4,35, скорость выхода около 83 против 56 токенов/с и время до первого токена 1,63 против 19,28 секунды.
Эти числа полезны как ориентир: они показывают возможный обмен между агрегатным качеством, ценой и задержкой. Но они не отвечают, какая модель лучше именно для вашего репозитория или агентного контура, потому что:
- сравниваются разные режимы —
Max Effortиhigh, которые нельзя считать автоматически равными; - смешанная цена рассчитана сторонней организацией по пропорции кэш/вход/выход 7:2:1, а не по вашему фактическому профилю токенов;
- агрегатный индекс скрывает провалы на отдельных типах задач;
- измерение не фиксирует ваш провайдер, набор инструментов, формат патча, правила проверки и долю результатов, принятых без доработки.
Поэтому корректная формулировка звучит так: стороннее измерение даёт Sol небольшой перевес по агрегатному индексу, а DeepSeek — заметный перевес по цене и измеренным задержкам в той конфигурации. Превращать это в «Sol умнее всегда» или «DeepSeek быстрее и выгоднее для любой задачи» нельзя.
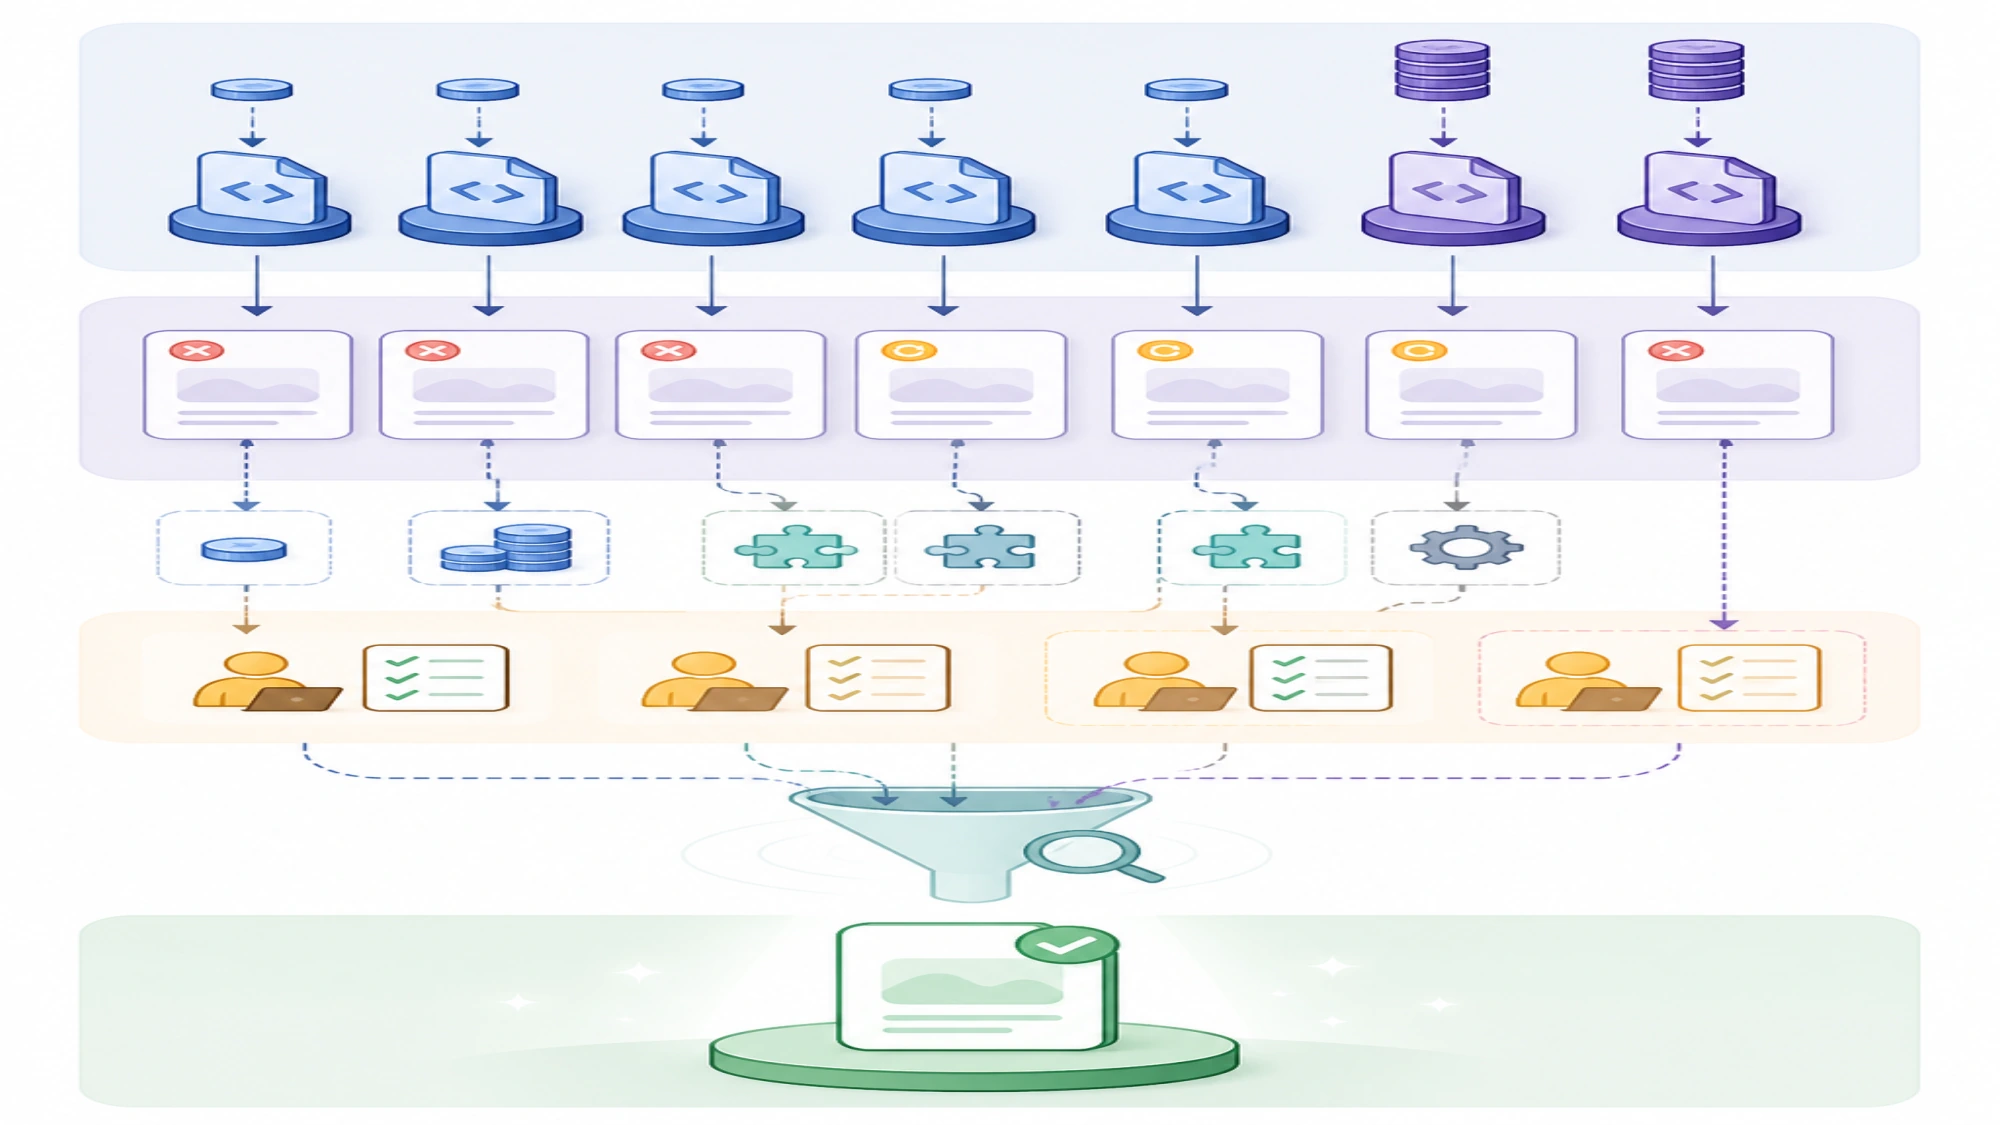
Считайте результат, который прошёл приёмку
Для рабочего выбора используйте показатель:
стоимость принятой задачи = все расходы на запуски / число результатов, прошедших критерий приёмки
В числитель входят основной запрос, повторы, продолжения после ошибок, вызовы инструментов и генерация ответа, который пришлось отбросить. Работу человека можно вести отдельной метрикой — например, минуты проверки на принятую задачу, — чтобы не маскировать её условной денежной ставкой.
Для каждого кандидата сохраните минимум пять показателей:
- долю задач, принятых с первой попытки;
- долю задач, принятых после разрешённого повтора;
- общую стоимость всех попыток;
- медиану и p95 времени до принятого результата;
- число критических ошибок: неверные изменения, сломанные тесты, пропущенные ограничения или невалидные tool calls.
Так цена становится частью качества решения, а не отдельной красивой колонкой.
Минимальный парный тест для задач по коду и с инструментами
Не нужно сразу строить большой бенчмарк. Достаточно 10–20 типичных задач, если они отражают реальные причины, по которым команда вызывает модель.
1. Зафиксируйте задачи и критерий приёмки
Возьмите обезличенные задачи из своего процесса: исправление ошибки, небольшой рефакторинг, анализ журнала, изменение API-клиента, написание теста. Для каждой заранее запишите проверяемый результат: проходят конкретные тесты, изменения не выходят за разрешённые файлы, формат ответа валиден, а обязательные ограничения соблюдены.
Не оценивайте стиль до функциональной проверки. Если результат нельзя проверить автоматически, используйте слепую оценку без названия модели и заранее заданную рубрику.
2. Уравняйте среду, а не названия effort
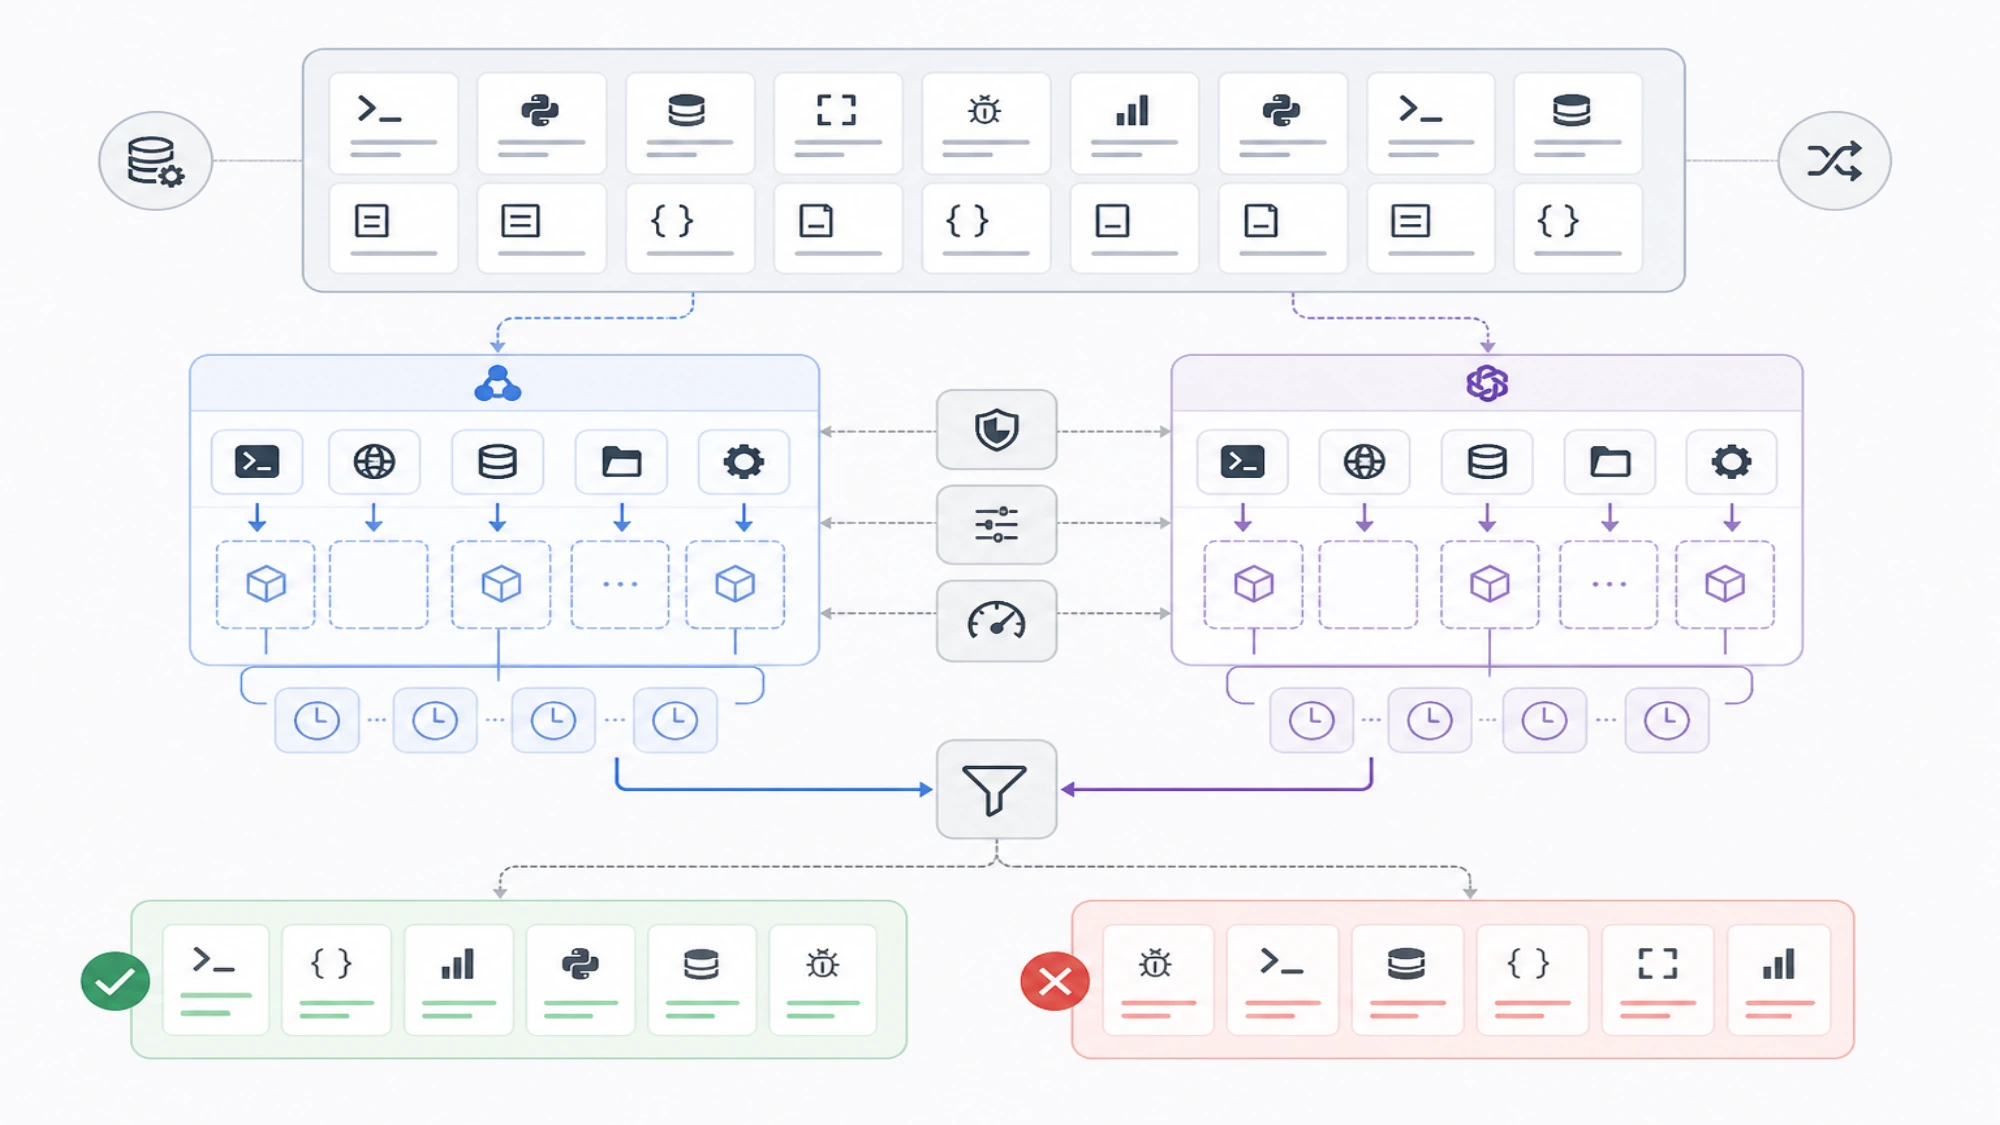
Обеим моделям передавайте один и тот же контекст, одинаковые инструкции, инструменты, лимит времени и число допустимых повторов. high у одного поставщика не обязан соответствовать high у другого. Поэтому проведите два среза:
- фиксированный бюджет — одинаковый денежный лимит на задачу;
- фиксированная попытка — по одному запуску в практически разумной конфигурации каждой модели.
Первый показывает экономическую эффективность, второй — качество привычного одиночного вызова. Не смешивайте их в один процент побед.
3. Повторите задачи и перемешайте порядок
Сделайте хотя бы три прогона каждой задачи, если бюджет позволяет. Случайность одного ответа особенно опасна на небольшом наборе. Перемешайте порядок и не меняйте запрос после того, как увидели неудачу одной из моделей: иначе тест превратится в ручную подгонку.
4. Запишите токены, задержку и причины отказа
Сохраняйте входные и выходные токены, попадание в кэш, цену, время до первого полезного события, полное время и код результата. Причина отказа должна быть конкретной: «не прошёл тест X», «изменён запрещённый файл», «неверный JSON», а не «ответ показался хуже».
5. Выберите по порогу, а не по среднему впечатлению
Сначала исключите модель, которая не проходит обязательный порог качества или безопасности. Если обе проходят, сравните стоимость принятой задачи и задержку. Если результат различается по типам задач, не обязательно выбирать одну модель для всего: дешёвая может выполнять первичный прогон, а более дорогая — проверять узкий класс критичных случаев.
Что проверить отдельно для работы из России
Параметр gl=ru в поиске, русская страница посредника или обещание «без VPN» не доказывают доступность официального аккаунта. До архитектурного решения проверьте на своём юридическом лице или аккаунте:
- возможность регистрации и фактический способ оплаты;
- валюту списания, курс, налоги и документы;
- квоты, ограничения частоты запросов и доступность нужного идентификатора модели;
- регион обработки данных и условия хранения;
- сетевую задержку, поддержку и порядок возврата средств.
Если используется посредник, повторите ценовой расчёт по его тарифу и подпишите его как тариф конкретной платформы. Качество маршрута через посредника также нельзя без проверки считать идентичным официальному API.
Итог: первый кандидат зависит от цены ошибки
DeepSeek V4 Pro 0813 стоит тестировать первым, когда нужен массовый недорогой прогон и команда готова измерить долю принятых результатов. Его официальная цена на 13 августа 2026 года существенно ниже, а API поддерживает режимы с рассуждением и без него, вызовы инструментов, JSON и несколько форматов интеграции.
GPT-5.6 Sol стоит тестировать первым на критичной выборке, когда возможное улучшение результата важнее стоимости вызова, нужен официально заявленный вход с изображением или цена неудачной автоматизации высока. Сторонний агрегат даёт повод включить Sol в короткий список, но не освобождает от теста.
Не переносите выводы с Luna на Sol, с Flash на Pro, с посредника на официальный API или с публичных весов на API-модель. Зафиксируйте точные ID, проверьте 10–20 своих задач и выберите модель, которая проходит ваш порог с меньшей стоимостью принятого результата.