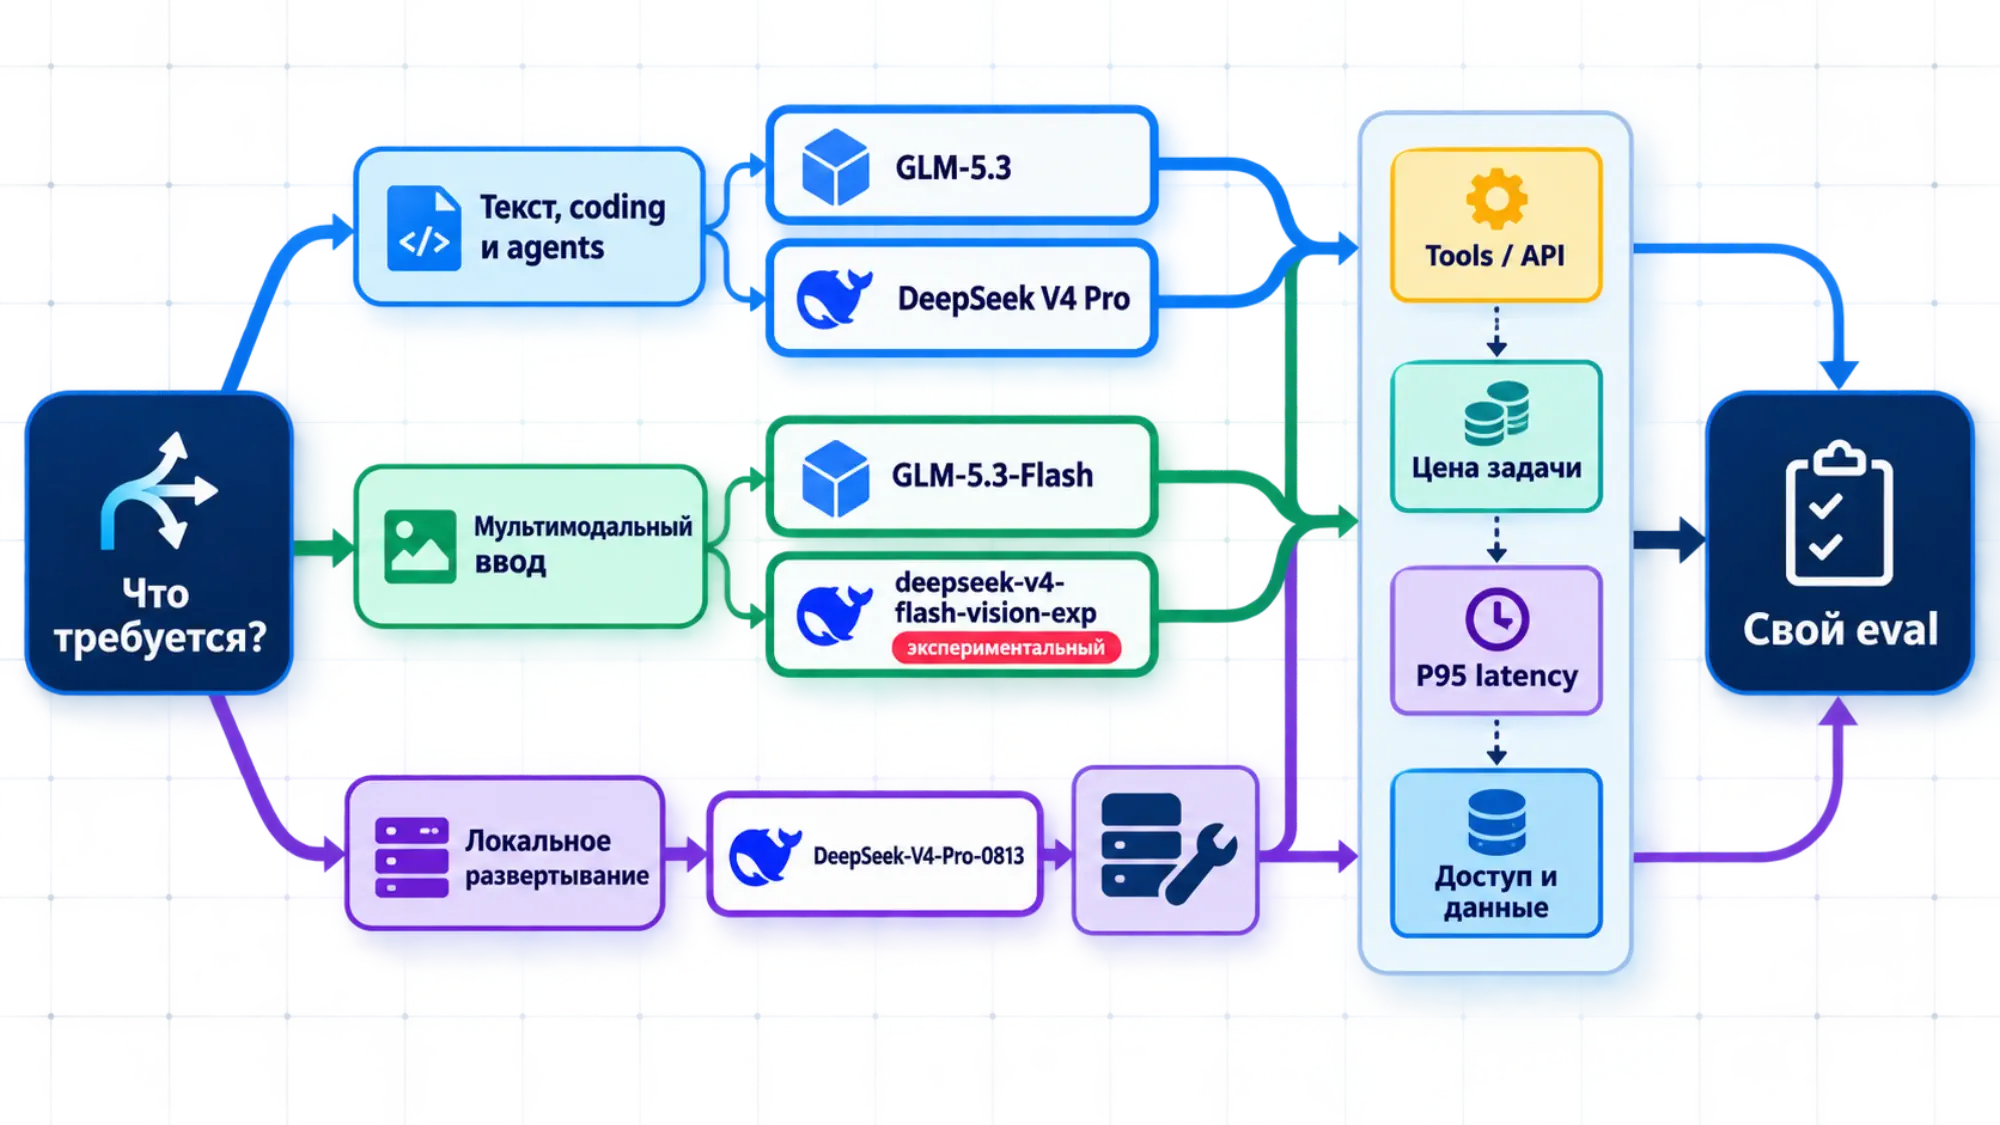
Короткий ответ: универсального победителя между GLM и DeepSeek сейчас нет. Для текстового coding- или agent-сценария разумно начать с GLM-5.3 и DeepSeek V4 Pro, а затем прогнать одинаковый набор собственных задач. Если нужен мультимодальный ввод, сравнивайте GLM-5.3-Flash с экспериментальным deepseek-v4-flash-vision-exp, заранее решив, допустим ли экспериментальный статус. Если критичны открытые веса и локальное развертывание, отдельным кандидатом становится DeepSeek-V4-Pro-0813.
Это сравнение зафиксировано на 27 августа 2026 года. Оно не переносит выводы старых пар вроде GLM 5.1 и DeepSeek V3.2 на текущие поколения.
Какие модели действительно актуальны
У названий семейств есть ловушка: поисковые сравнения и агрегаторы часто смешивают разные поколения. Перед тестом сохраняйте не только бренд, но и точный API model ID и served version.
| Семейство | Актуальный кандидат | Что подтверждено официально | Важная граница |
|---|---|---|---|
| Z.ai GLM | glm-5.3 | Текстовый ввод, контекст 1 млн токенов, максимум вывода 128K, постоянно включенный reasoning с low, high, max | Характеристики API не доказывают качество на вашей задаче |
| Z.ai GLM | glm-5.3-flash | Текст, изображения, видео и файлы; контекст 1 млн; function calling, structured output и context caching | Поддержка может различаться между endpoint и интеграциями |
| DeepSeek | deepseek-v4-pro (DeepSeek-V4-Pro-0813) | Контекст 1 млн, вывод до 384K, JSON, tool calls, Responses API и Anthropic API | Максимальный лимит не означает, что модель надежно решит задачу такого размера |
| DeepSeek | deepseek-v4-flash (DeepSeek-V4-Flash-0731) | Вариант линии V4 с тем же опубликованным контекстом 1 млн | Сравнивать нужно на вашем балансе скорости, качества и стоимости |
| DeepSeek | deepseek-v4-flash-vision-exp | Смешанный текстовый и графический ввод | Это экспериментальная модель, а не автоматический выбор для production |
Источники спецификаций: GLM-5.3, GLM-5.3-Flash, таблица моделей и цен DeepSeek и обновления DeepSeek.
Быстрая матрица выбора
| Если главное требование | Кандидат для первого теста | Почему это только отправная точка |
|---|---|---|
| Длинный текстовый coding/agent workflow | glm-5.3 и deepseek-v4-pro параллельно | Обе модели заявляют 1M context, но нет установленного независимого head-to-head с полностью одинаковыми условиями |
| Мультимодальный вход в стабильном продукте | Сначала проверить glm-5.3-flash | У DeepSeek vision-вариант на дату сравнения обозначен как experimental; интеграционную стабильность все равно нужно подтвердить |
| OpenAI Responses API как обязательное условие | deepseek-v4-pro в коротком smoke test | Нативная поддержка официально заявлена, но совместимость конкретных событий, tools и streaming проверяется на вашем клиенте |
| Локальное развертывание или аудит весов | DeepSeek-V4-Pro-0813 | Веса опубликованы под MIT, но это ничего не говорит о доступном вам железе, стоимости и паритете с hosted API |
| Минимальная цена запроса | Считать на своем token trace | Итог меняют cache hit, временная зона тарифа, reasoning, retries и доля выходных токенов |
| Лучшее качество на репозитории | Одинаковый eval для обеих моделей | Производительские и узкие сторонние бенчмарки не заменяют ваши репозитории, инструменты и критерии приемки |
Где различия влияют на архитектуру
Reasoning и управляемость бюджета
У glm-5.3 reasoning включен постоянно, а усилие задается как low, high или max. DeepSeek V4 Pro и Flash также поддерживают эти уровни. Поэтому тест «с настройками по умолчанию» мало что объясняет: одна модель может потратить больше скрытого рассуждения и времени.
Для честного сравнения фиксируйте одновременно:
- reasoning effort;
- максимальный output budget;
- timeout и число retries;
- доступные tools и их схемы;
- правила остановки агента;
- полный token usage и wall-clock latency.
Если модель не поддерживает идентичную настройку в выбранном клиенте, это не повод молча подменять условие. Запишите различие как часть результата: интеграционная управляемость тоже влияет на выбор.
Контекст: 1M — это лимит, а не обещание качества
Обе актуальные линии публикуют контекст до 1 млн токенов. DeepSeek дополнительно указывает вывод до 384K, а GLM-5.3 — до 128K. Эти числа отвечают на вопрос «может ли endpoint принять такой объем», но не на вопросы «найдет ли модель нужную деталь», «не потеряет ли ограничения» и «сколько будет стоить повторный проход».
Для работы с большим репозиторием полезнее проверить три режима:
- только минимально отобранные файлы;
- широкий контекст с тем же заданием;
- широкий контекст плюс поиск или навигационные tools.
Победитель по максимальному окну может проиграть по точности патча, времени или стоимости всего agent loop.
Tools и протоколы
DeepSeek перечисляет tool calls, Responses API и Anthropic API, а для V4 Pro заявлена нативная поддержка OpenAI Responses API. Для glm-5.3-flash Z.ai документирует function calling и structured output. Возможности базового glm-5.3 и конкретного SDK нужно сверять по выбранному endpoint перед тестом. Название протокола само по себе не гарантирует, что библиотека одинаково обработает streaming events, parallel calls, structured output или восстановление после ошибки.
Минимальный интеграционный smoke test должен включать:
- обычный текстовый ответ;
- один обязательный tool call с проверкой аргументов по schema;
- цепочку из двух инструментов;
- принудительный JSON-ответ;
- отмену по timeout и повтор;
- сохранение usage и finish reason.
Мультимодальность
Базовый glm-5.3 принимает только текст. Для изображений, видео и файлов у Z.ai выделен glm-5.3-flash. У DeepSeek на дату сравнения есть deepseek-v4-flash-vision-exp для текста и изображений, причем exp — существенная часть статуса.
Если изображения нужны лишь на одном шаге, не обязательно переводить весь pipeline на мультимодальную модель. Можно разделить распознавание и последующий текстовый agent loop, а затем сравнить качество, задержку и стоимость обеих архитектур.
Цена: сравнивайте счет за завершенную задачу
По официальным прайс-листам на 27 августа 2026 года:
| Модель | Вход за 1 млн токенов | Кэшированный вход | Выход за 1 млн токенов |
|---|---|---|---|
| GLM-5.3 | $1.40 | $0.26 | $4.40 |
| DeepSeek V4 Pro, off-peak | $0.66 при cache miss | $0.022 при cache hit | $1.98 |
| DeepSeek V4 Pro, peak | $1.32 при cache miss | $0.044 при cache hit | $3.96 |
Z.ai также показывал для GLM-5.3-Flash временную скидку 50% до 9 сентября 2026 года, 24:00 UTC+8: $0.075 за вход, $0.015 за кэшированный вход и $0.25 за выход. Временную акцию нельзя закладывать в долгосрочную архитектуру без повторной проверки.
Пример только для масштаба: 1000 запросов по 20 000 входных и 5000 выходных токенов дают 20 млн input и 5 млн output. Без учета кэша, tools, retries, налогов и скидок это около $50 для GLM-5.3, $23.10 для DeepSeek V4 Pro off-peak или $46.20 в peak. Это не прогноз вашего счета: agent, который чаще ошибается и повторяет шаги, может оказаться дороже при более низкой цене токена.
Практичная метрика:
textстоимость успешной задачи =
  все входные токены + все выходные токены
  + повторные вызовы + tool/API costs
  + стоимость проверок и ручных исправлений
Перед оплатой проверьте актуальный прайс Z.ai и прайс DeepSeek. Публичная страница не подтверждает регистрацию, оплату, налоговые документы или отсутствие региональных ограничений для пользователя в России.
Что говорят бенчмарки — и чего они не говорят
Z.ai сообщает об улучшениях GLM-5.3 в coding и long-horizon agent-задачах относительно GLM-5.2. DeepSeek публикует собственные результаты V4 Pro и условия части agent-тестов. Эти данные полезны для выбора кандидатов, но методики, effort, бюджеты и сравниваемые версии у производителей не образуют единого контролируемого эксперимента.
Есть и более узкие сторонние наблюдения. Например, Aikido Security описывает замороженный cyber-бенчмарк без интернета: 32 недавно раскрытые уязвимости, 10 моделей и три прогона на случай. В этом harness DeepSeek V4 Pro нашел больше уязвимостей в объединенном результате, чем GLM-5.3, но одновременно создал больше кандидатов и ложных направлений. Это интересный сигнал для vulnerability research, а не вердикт о reasoning, обычной разработке, скорости, цене или безопасности вообще.
Следовательно, фразы «модель X лучше пишет код» недостаточно. Нужны задача, harness, endpoint, model version, effort, tools, token budget, evaluator и дата.
Как провести собственный GLM vs DeepSeek eval
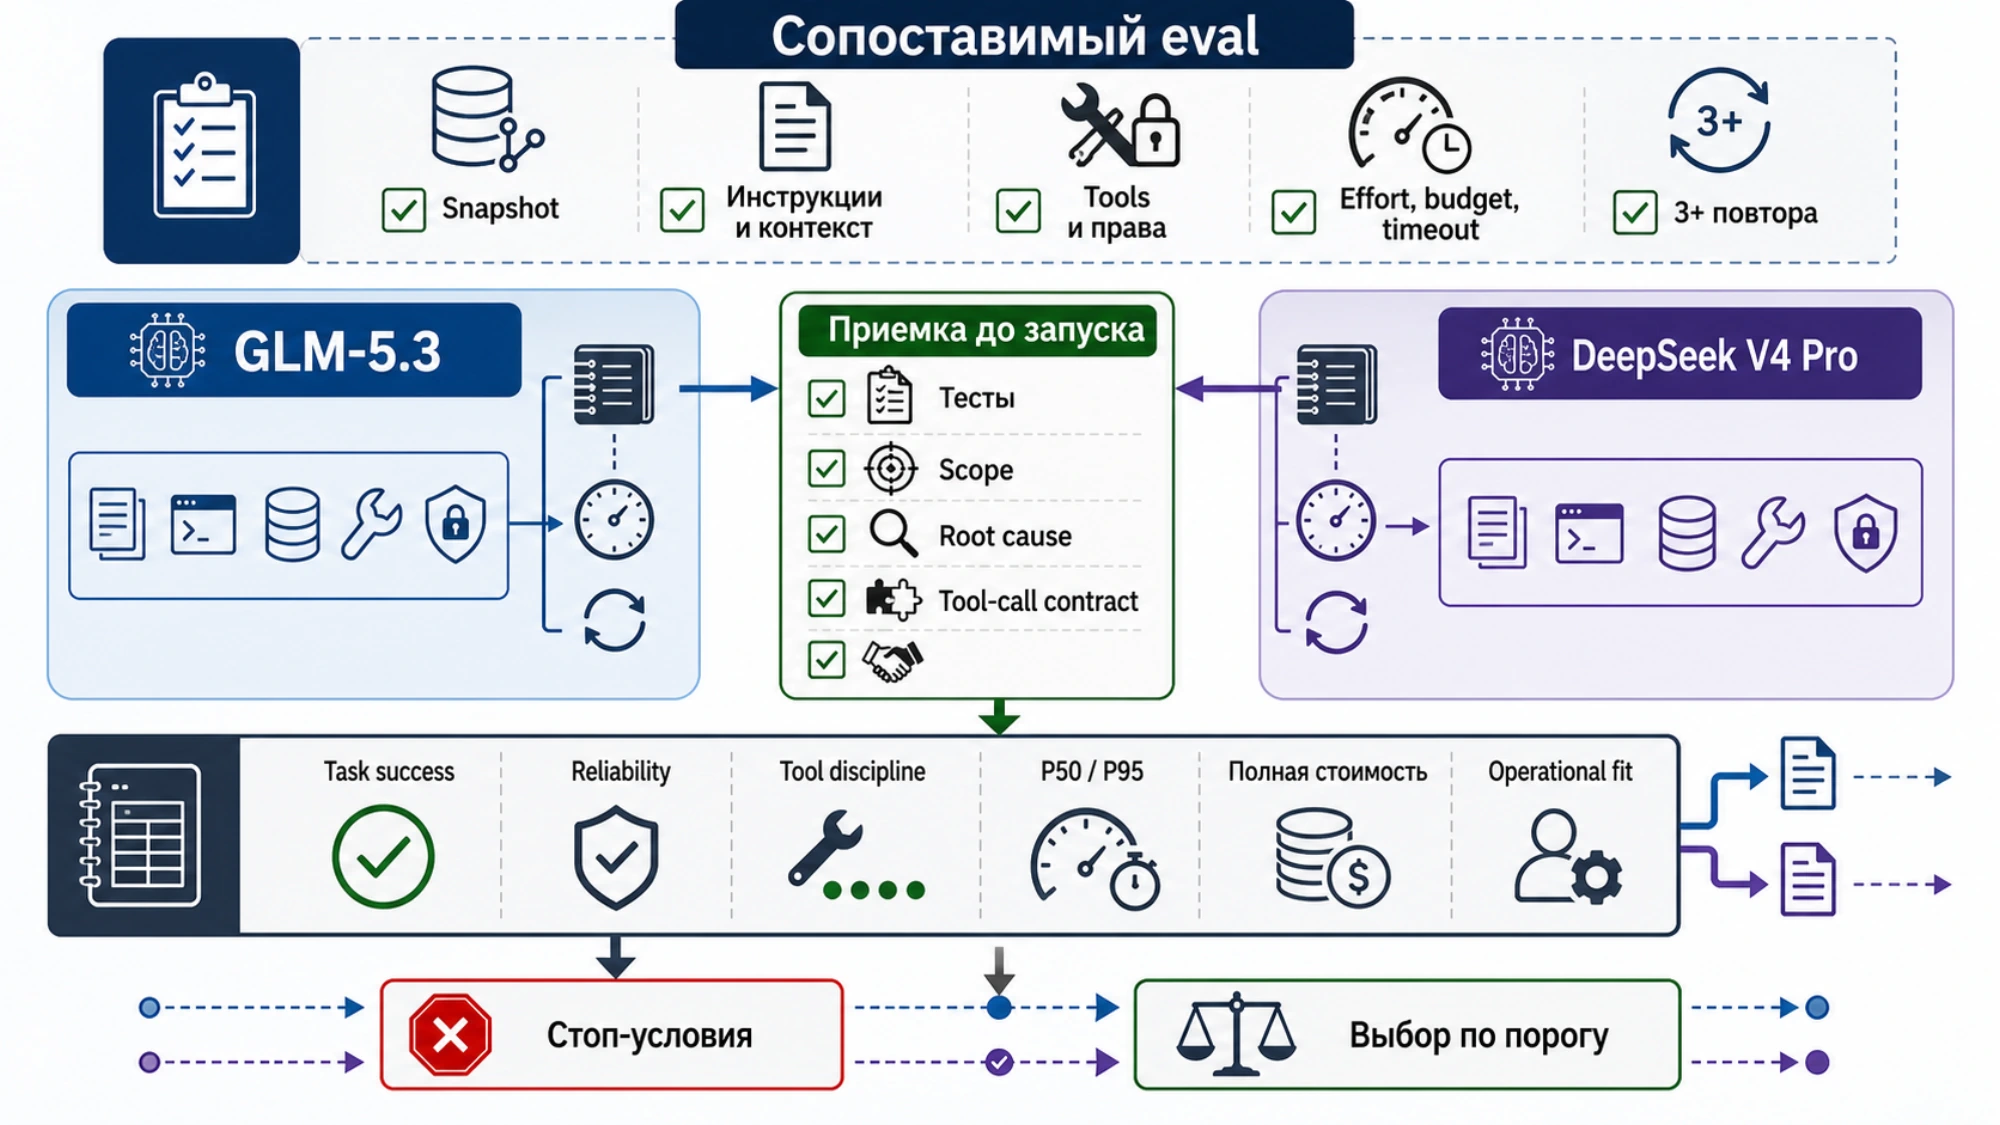
Возьмите 20–50 реальных задач, достаточно дорогих, чтобы выбор модели имел значение. Не используйте только успешные демонстрации. В наборе должны быть типичные случаи, пограничные условия и несколько прошлых инцидентов.
1. Зафиксируйте вход и среду
- один snapshot репозитория и зависимостей;
- одинаковые инструкции и контекст;
- одинаковый набор tools и права;
- точные model ID и served version;
- равные effort, token budget и timeout, где это возможно;
- минимум три повтора для задач с заметной вариативностью.
2. Определите приемку до запуска
Для coding agent это могут быть:
- проходят целевые тесты;
- не изменены файлы вне scope;
- устранена исходная причина, а не только симптом;
- нет нового security или compatibility regression;
- число tool calls и ручных исправлений остается в лимите.
Для задач без детерминированных тестов используйте слепое сравнение и rubric. Не позволяйте красивому стилю ответа перекрыть фактическую ошибку.
3. Считайте полный результат
| Метрика | Что записывать |
|---|---|
| Task success | Доля задач, прошедших заранее заданную приемку |
| Reliability | Разброс между повторами и доля фатальных сбоев |
| Tool discipline | Неверные аргументы, лишние вызовы, восстановление после ошибок |
| Latency | P50/P95 всего сценария, а не одного ответа |
| Cost | Все токены, retries, tools и ручной rework на успешную задачу |
| Operational fit | Streaming, логирование, rate limits, SLA и удобство интеграции |
4. Выбирайте по порогу, а не по среднему баллу
Заранее задайте стоп-условия. Например: модель исключается, если меняет файлы вне scope более чем в 2% прогонов или не проходит обязательный tool-call contract. Среди оставшихся выбирайте по стоимости успешной задачи и P95 latency. Такой порядок не даст дешевому, но нестабильному варианту выиграть за счет среднего числа.
Доступ из России и требования к данным
Официальные страницы подтверждают модели и публичные тарифы, но не подтверждают для каждого читателя возможность зарегистрироваться, оплатить API, получить закрывающие документы или выполнить требования к хранению и обработке данных. До технического eval отдельно проверьте:
- регистрацию и MFA из вашей фактической локации;
- доступный способ оплаты и валюту списания;
- договор, налоги и документы для компании;
- retention, training use и удаление данных;
- data residency, SLA и процедуру инцидентов;
- допустимость передачи исходного кода и персональных данных.
Не обходите региональные или договорные ограничения через случайный marketplace. Если используете посредника, его цена, политика данных, served version и ограничения становятся частью сравнения.
Частые вопросы
GLM-5.3 лучше DeepSeek V4 Pro для программирования?
Публичных данных недостаточно для общего вывода. Оба производителя заявляют сильные coding/agent-возможности, но их результаты не получены в одном полностью совпадающем harness. На практике сравните модели на своих репозиториях и считайте task success, нарушения scope, retries, latency и стоимость успешной задачи.
Что дешевле: GLM или DeepSeek?
По указанным тарифам DeepSeek V4 Pro может стоить меньше за токены, особенно off-peak, но разница зависит от cache hit, времени запроса, доли output и числа повторов. Временная скидка GLM-5.3-Flash способна изменить картину лишь до окончания акции. Пересчитывайте цены в день запуска.
Какая модель подходит для изображений?
У Z.ai это glm-5.3-flash; базовый glm-5.3 — text-only. У DeepSeek доступен экспериментальный deepseek-v4-flash-vision-exp. Для production учитывайте экспериментальный статус и проверяйте качество на своих типах изображений.
Можно ли развернуть DeepSeek V4 Pro локально?
DeepSeek опубликовал веса DeepSeek-V4-Pro-0813 под MIT и инструкции по локальному развертыванию. Это подтверждает доступность весов, но не гарантирует приемлемую стоимость железа, скорость, паритет с hosted API или соответствие требованиям вашей организации.
Достаточно ли сравнить ответы в чате?
Нет, если модель будет работать через API или как агент. Чат не проверяет ваши tools, системные инструкции, structured output, retries, latency и реальную стоимость цепочки. Нужен тест через тот endpoint и client stack, которые пойдут в production.
Итог
Начните не с бренда, а с ограничений. Для text-first coding и agents поставьте glm-5.3 и deepseek-v4-pro в одинаковый eval. Для мультимодальности добавьте glm-5.3-flash и, если допустим экспериментальный статус, deepseek-v4-flash-vision-exp. Для self-hosting отдельно оцените опубликованные веса DeepSeek.
Финальное решение принимайте по заранее заданным порогам надежности, затем по стоимости успешной задачи и P95 latency. И перед интеграцией повторно проверьте served model ID, цену, доступность аккаунта и условия работы с данными: именно эти детали устаревают быстрее любого сравнительного обзора.