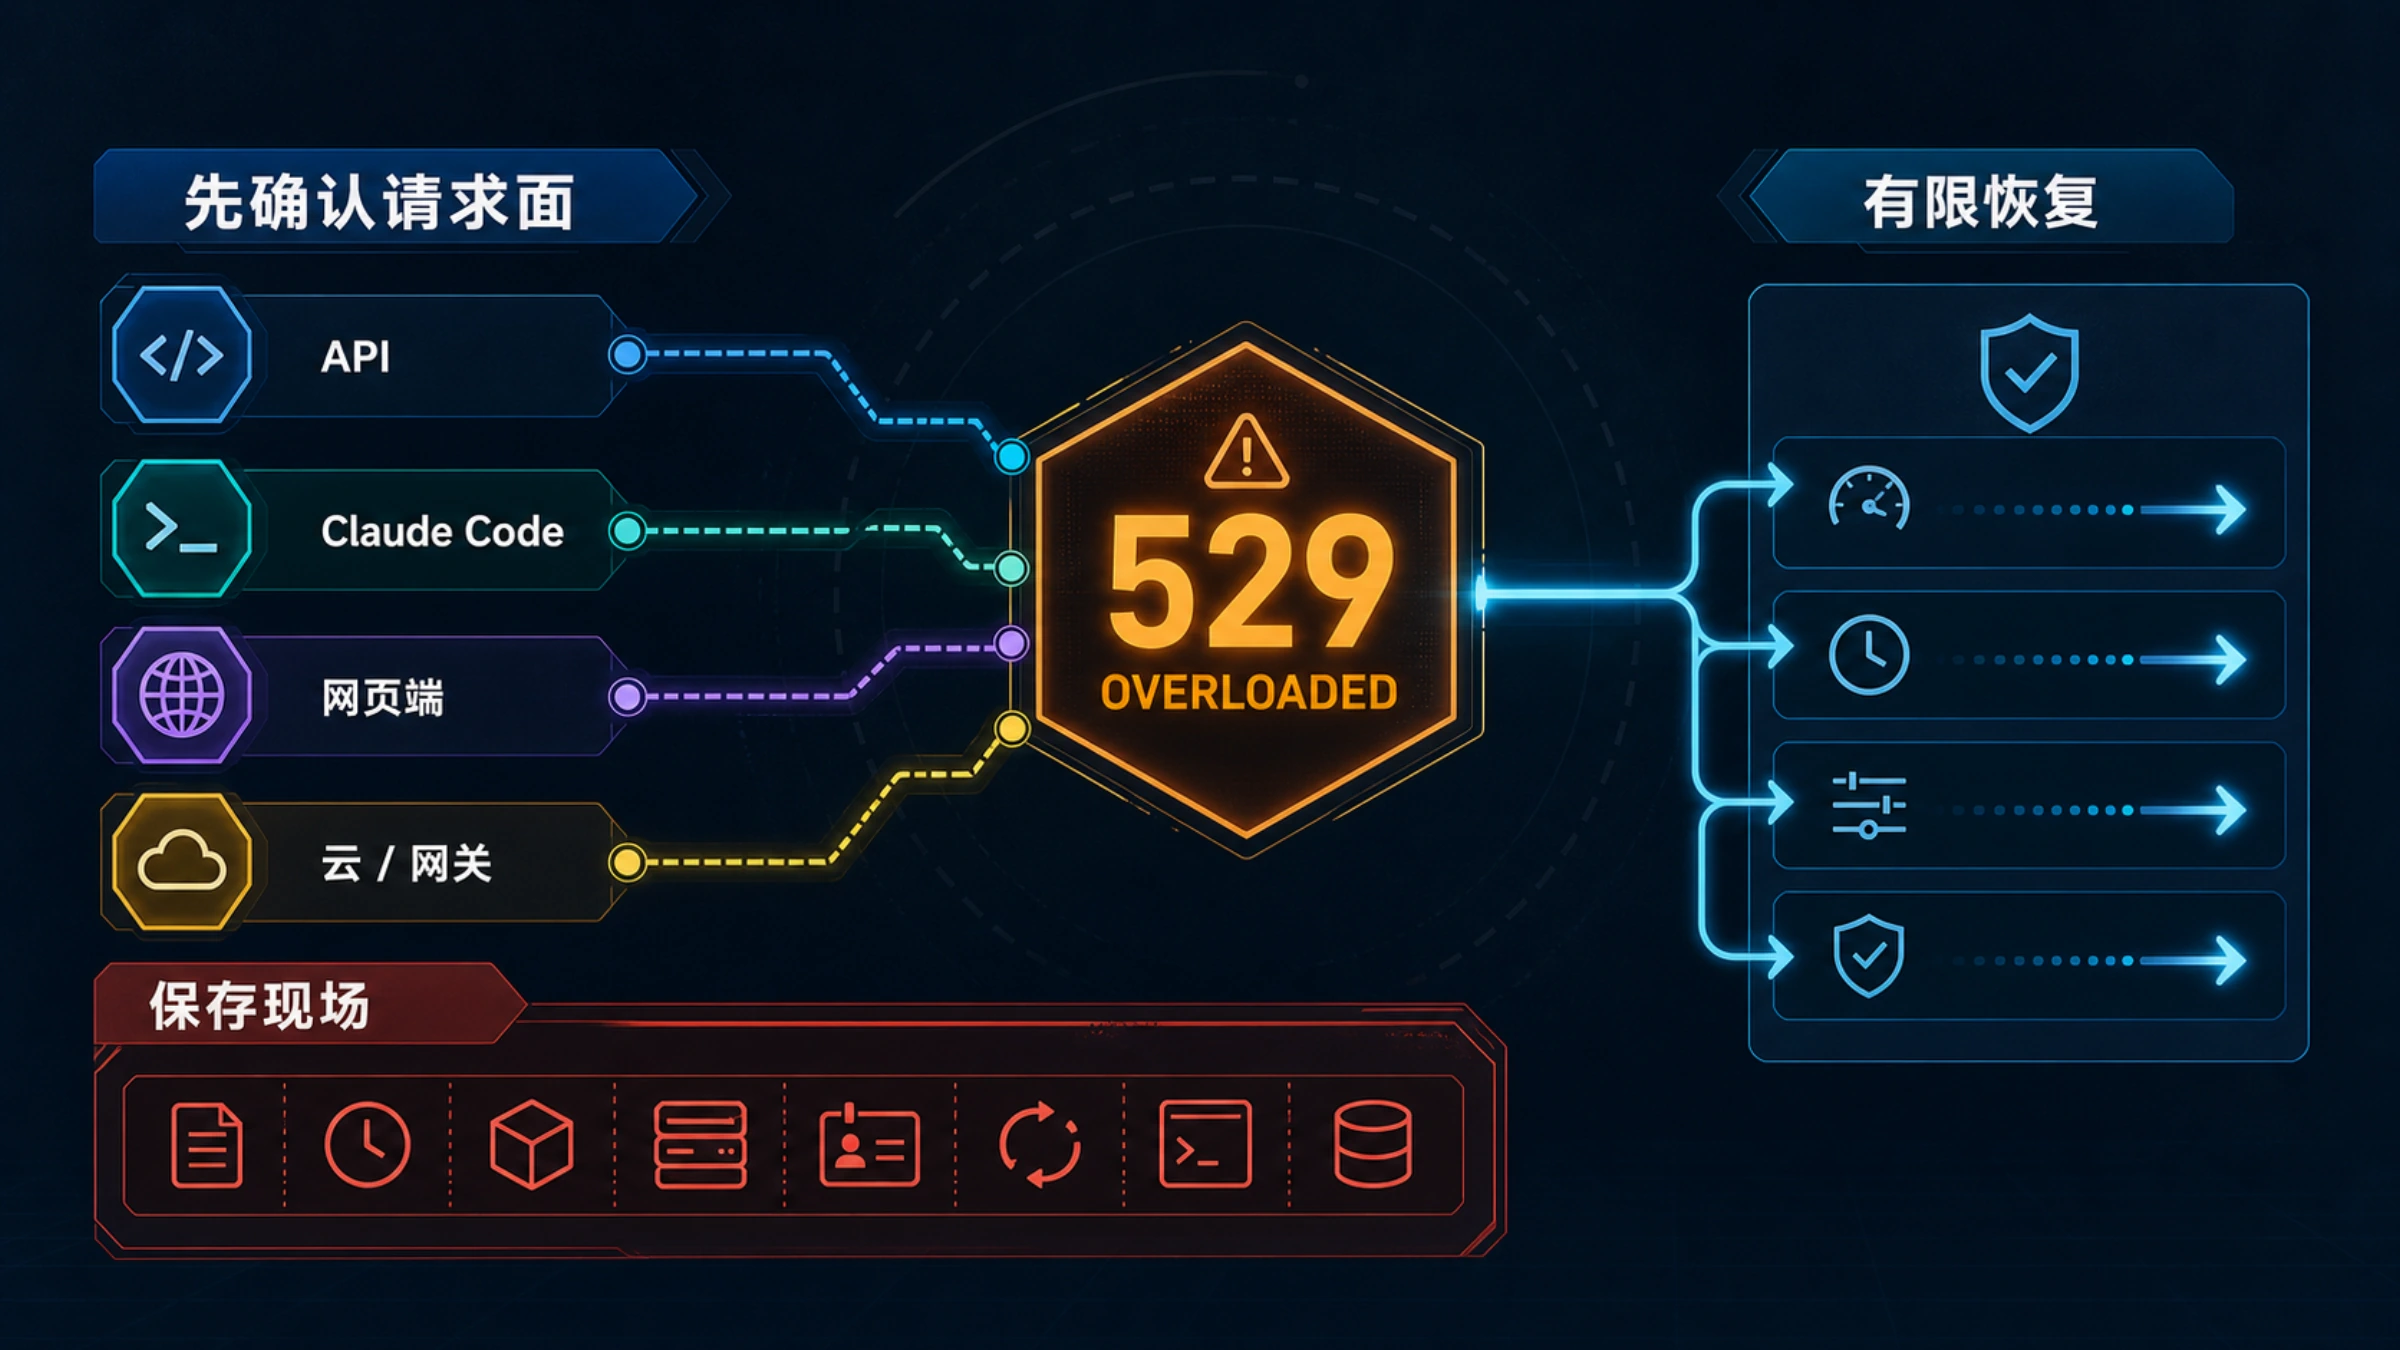
Claude 返回 529 overloaded_error,通常表示处理这次请求的服务暂时过载。它不是让你立刻无限重试的信号,也不能仅凭错误码断定 Claude 正在全面宕机。
真正决定下一步的,是这次请求从哪里发出、由谁返回错误,以及在你看到 529 之前已经发生了多少次自动重试。Anthropic 官方 SDK 默认会对瞬时失败做 2 次指数退避重试;Claude Code 对符合条件的瞬时失败最多会重试 10 次。如果屏幕上已经出现 Repeated 529,继续在外层套重试很容易把一次临时容量问题放大成重试风暴。
先不要关闭终端、刷新页面或重发整轮任务。保存以下信息:
- 完整错误体与错误类型,而不是只截取“529”;
- 发生时间和时区;
- 使用的产品、客户端版本、模型、provider 与 endpoint;
request_id或request-id响应头;- 已尝试次数、SDK/CLI/网关的重试配置;
- 已收到的部分输出,以及工具调用、文件写入、消息发送、付款等副作用是否可能已经发生。
先用 30 秒判断:你遇到的是哪一种 529
同样写着 529,不同请求面的恢复方法并不相同。
| 请求面 | 先确认什么 | 已知的自动重试边界 | 下一步 |
|---|---|---|---|
| Anthropic direct API + 官方 SDK | SDK 语言、版本、max_retries/maxRetries、是否还有队列或代理 | 官方 SDK 默认额外重试 2 次,可配置或关闭 | 查 Claude API 状态;把所有层的总尝试数合并计算 |
| Claude Code | 屏幕是否显示 Repeated 529、实际 provider、模型、工具是否已经执行 | 对符合条件的瞬时失败最多重试 10 次 | 不要下意识再跑整条命令;先查 provider 状态和副作用 |
| claude.ai 网页端 | 页面、账号、会话及发生时间 | 当前证据不能用 API SDK 或 Claude Code 的数字外推 | 保存页面错误并查 claude.ai 状态;短暂等待后只重试一次低风险操作 |
| Amazon Bedrock、Google Cloud 或其他云路线 | 云 provider、区域、模型标识、其错误体与状态页 | 以对应云客户端和 provider 文档为准 | 查对应 provider/区域状态,不要只查 Anthropic 总状态 |
自定义 ANTHROPIC_BASE_URL 或第三方网关 | 谁真正返回 529、是否改写 request_id、网关是否自带重试 | 未知,必须查网关配置与日志 | 先核对网关状态、重试和账单语义,再决定是否重发 |
如果你还不能确认请求面,就先查看 endpoint、客户端配置和错误体来源。一个由网关包装的 529,不足以证明上游 Anthropic 就是故障源。
529 不是 429,也不是所有“请求失败”的统称
Anthropic 的 API 错误参考 将几类错误明确分开:
529 overloaded_error:API 暂时过载,可能发生在所有用户流量较高时;429 rate_limit_error:限流,也可能与月度消费上限或 Claude Code workspace 消费限制有关;500 api_error:内部服务器错误;504 timeout_error:网关超时;- 连接失败、代理错误或本地超时:甚至可能没有收到 Anthropic 返回的 HTTP 错误。
因此,“换 key”“升级套餐”不是 529 的默认解法;“等几秒必定恢复”也没有通用保证。先保留原始错误类型、响应头和请求路径,才能避免沿着错误分支排查。
还有一个容易漏掉的情况:流式请求可能先返回 HTTP 200,随后才在 SSE 流中发出错误。只记录初始状态码,会把中途失败误判成完整成功。
在再次请求前,先算清楚谁已经替你重试
一次用户操作可能穿过多层重试器:业务代码、任务队列、官方 SDK、反向代理、云 provider 和第三方网关。每层都“再试 3 次”,最坏情况不是 3 次,而是层层相乘。
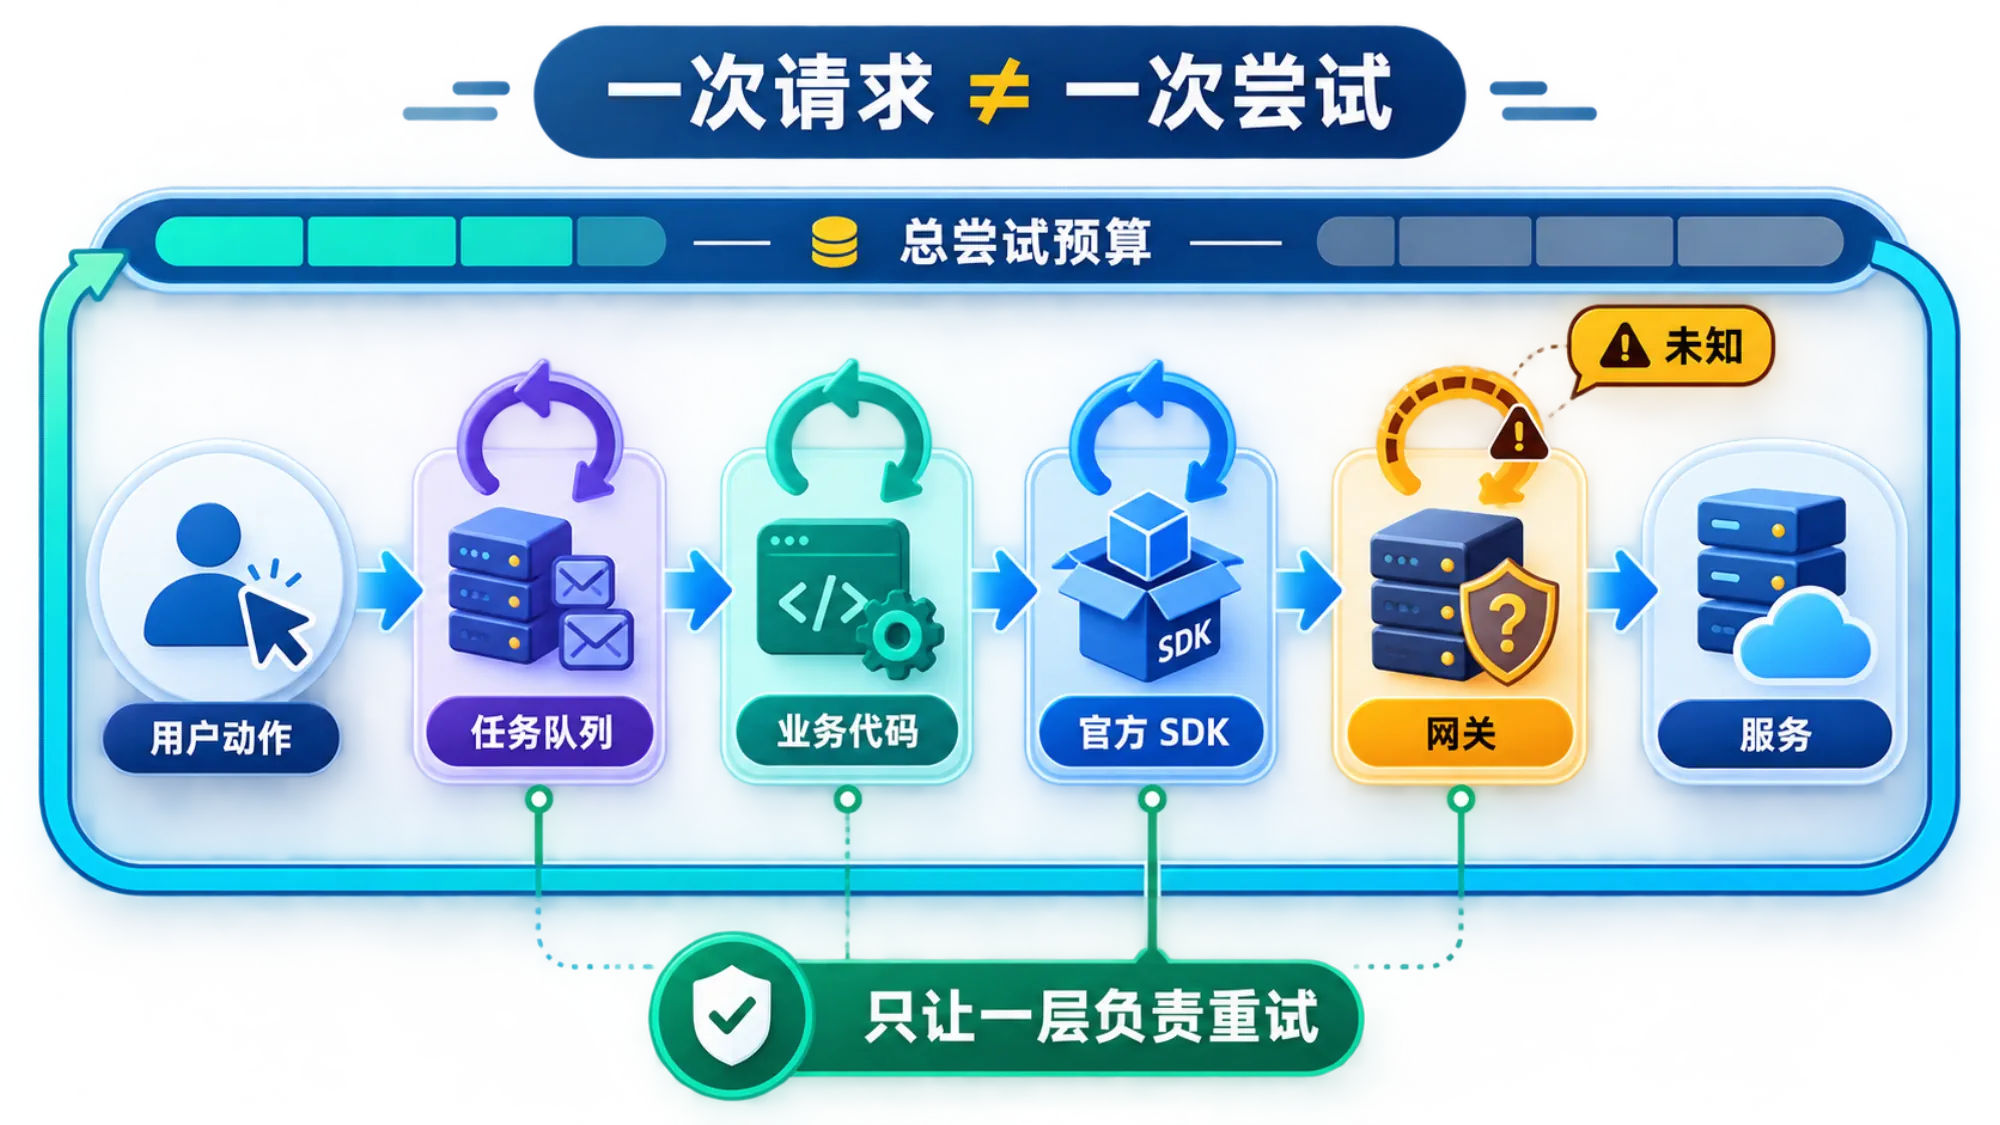
可以把总预算写成一张显式清单:
text用户动作:              1 次
任务队列最大投递:      2 次
业务代码每次尝试:      2 次
官方 SDK 默认额外重试: 2 次
网关重试:              未知,待核对
这里最危险的不是某个数字,而是“未知”。在确认网关是否重试之前,不要再叠加一个无上限循环。
direct API:让一个层负责重试
官方 SDK 默认会对连接错误、限流和 5xx 等瞬时失败做 2 次指数退避重试,并在服务返回 retry-after 时遵循它。若你的队列已经统一管理重试,可关闭 SDK 自动重试;若保留 SDK 默认值,外层就应把这两次计入总预算。
下面是一个策略示意,不是可直接复制到所有 SDK 版本的固定接口:
tsconst policy = {
  maxTotalAttempts: 3,
  maxElapsedMs: 90_000,
  maxConcurrentRetries: 2,
  jitter: "full",
  retryable: [429, 500, 504, 529],
};

// 只选择一层负责退避:
// A. 保留官方 SDK 重试,业务层不再重试;或
// B. SDK maxRetries = 0,由队列按 policy 统一处理。
一个安全的批处理策略至少要同时限制:总尝试次数、总时长、重试并发和队列积压。只做指数退避,却不收敛并发,仍可能让大量任务在同一时间醒来。应加入随机抖动,并在 529 比例持续升高时暂停新请求或打开熔断器。
Claude Code:看到 Repeated 529 时,重试并不是刚开始
根据 Claude Code 错误参考,Claude Code 对符合条件的瞬时失败最多会做 10 次指数退避重试。出现 Repeated 529 时,客户端已经尝试过多次;它不是“现在开始手动重试十次”的建议。
官方文档还说明,Claude Code 中的 529 不是 usage limit,也不计入 Claude Code quota。这个结论只适用于 Claude Code 配额,不能扩写成“direct API 失败请求一定不收费”或“第三方网关绝不会重复计费”。后两者需要各自的用量记录、账单规则和关联日志来确认。
CLAUDE_CODE_RETRY_WATCHDOG=1 更不适合当作普通修复开关:它会让无人值守会话对 429/529 无限重试,并把其他瞬时错误的默认重试次数提高到 300 次,约覆盖三小时退避。只有在并发、预算、幂等与停止条件都由外部系统严格控制时,才应考虑这种模式。
部分输出或工具调用发生后,不要重发整轮
最需要谨慎的不是“还没收到任何结果”的 529,而是请求已经产生部分结果:模型输出了一段文本、创建了文件、调用了工具,或外部系统已经接收了写操作。
Claude Code 不会自动重跑“已完成文本块或工具调用之后”的中途失败,因为重跑可能让同一个工具执行两次。这个保护是 Claude Code 特定行为,不能假设所有 SDK、代理或网关都有同样保护。
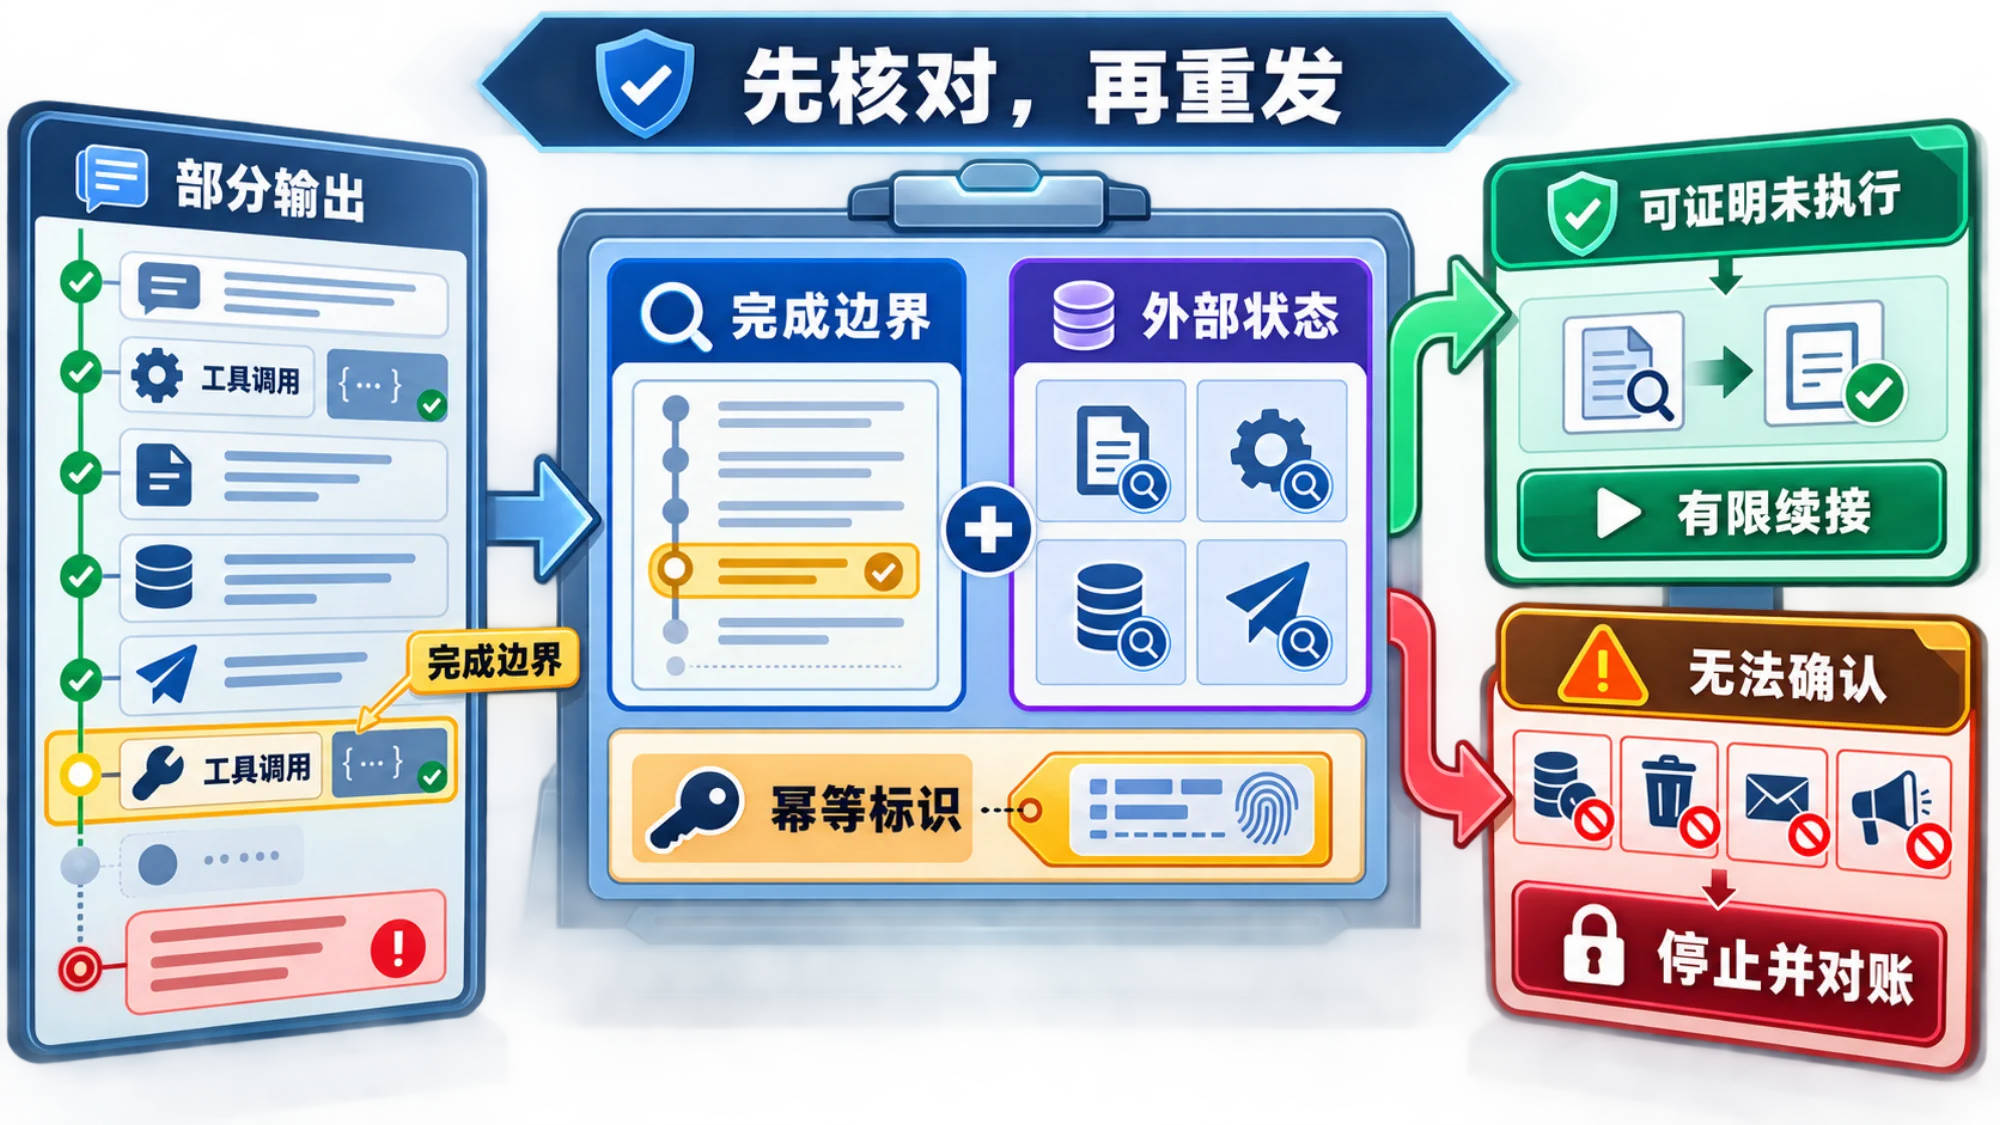
再次请求前按这个顺序检查:
- 确认完成边界。 最后一个完整文本块、工具结果或流事件是什么?错误发生在调用前、调用中还是调用后?
- 核对外部状态。 文件是否已写入、工单是否已创建、消息是否已发送、数据库是否已更新?不要只看本地超时。
- 使用业务幂等标识。 如果目标系统支持幂等键、唯一业务 ID 或条件写入,就用同一个标识查询结果,而不是生成一个全新操作。
- 优先续接只读工作。 对纯文本任务,可携带最后确认的完成位置继续;对有副作用的任务,先人工或程序化对账。
- 无法证明未执行时停止。 付款、删除、发信、发布等动作不要凭猜测重放,转入人工核验或对应系统的恢复流程。
request_id 很重要,但它只是关联线索,不等于“请求未完成”“未计费”或“天然幂等”。第三方网关还可能替换或省略上游 ID,所以要同时保存上下游日志与业务操作 ID。
一条不会制造重试风暴的恢复路径
1. 保存现场,不要先刷新
复制完整错误、时间、模型、endpoint、provider、客户端版本、request_id、已有重试次数和部分输出。若是 Claude Code,记录最后完成的工具调用及其结果。
2. 查正确的状态页
direct API、Claude Code 和 claude.ai 可先查 Claude Status 中对应组件。使用 Bedrock、Google Cloud 或第三方网关时,还要查对应 provider、区域或网关状态。
状态页是时间点快照。绿色只能说明聚合监控当时没有公开事故,不能排除单模型、单区域、单账号、单网关或短暂波动;历史事故也不能证明此刻的 529 与它同源。
3. 只做一次低风险、有限的探测
如果没有任何部分输出或外部副作用,且现有自动重试预算已明确,可以在等待并加入抖动后做一次低并发重试。不要用完整生产批次探测恢复;选一个可丢弃、只读、成本可控的请求。
如果 provider 文档允许、任务不依赖特定模型能力,可以考虑切换模型。Claude Code 文档指出模型容量分别跟踪,但切换是否可用仍取决于请求路线、权限、区域、策略和任务要求,不能当作必然成功的通用按钮。
4. 恢复时缓慢放量
探测成功不代表容量已经完全恢复。先降低并发,逐步放量,同时观察 529 比例、延迟、队列深度和重复副作用。若错误再次升高,立即停止扩容并重新打开熔断。
5. 达到停止条件就升级,不再盲试
满足任一条件就停止自动重试:
- 已达到总尝试次数或总时长;
Repeated 529后仍持续失败;- 已出现部分输出、工具调用或不可逆外部写入;
- 无法确认 provider、重试层或账单语义;
- 只有某个模型、区域、账号或网关路径失败;
- 状态页与实际错误持续不一致。
升级支持时,提交一份可关联的证据包
不要只写“Claude 一直 529”。一份能推进排查的报告应包含:
text发生时间(含时区):
产品/请求面:direct API / Claude Code / claude.ai / provider / gateway
provider、endpoint 与区域:
模型:
客户端与版本:
完整错误体和响应头:
request_id / request-id:
已有重试层及各自次数:
是否收到部分输出:
已发生的工具调用或外部副作用:
对应状态页及查看时间:
同一账号/区域/模型之外的对照结果:
用量与账单记录(如问题涉及计费):
对于网关路径,同时提供网关请求 ID 与上游请求 ID;若网关只暴露自己的 ID,也要明确说明。对于计费争议,不要从 HTTP 状态码直接推断结果,应使用同一时间窗口内的用量记录、账单条目和关联日志。
常见问题
Claude 529 是我的额度用完了吗?
通常不是。Anthropic 将 529 定义为暂时过载;429 才是 rate limit,且可能涉及消费上限。Claude Code 文档明确说其 529 不计入 Claude Code quota,但这不能证明 direct API 或第三方网关的具体账单结果。
529 一般多久恢复?
没有适用于所有模型、区域和 provider 的固定时间。用状态页、有限探测和自己的错误率判断恢复,不要依赖一个保证分钟数。
状态页全绿,为什么我仍然收到 529?
公共状态页展示的是聚合状态,可能看不到短暂、局部或路径特定的问题。核对模型、区域、账号、provider、endpoint 与网关日志,并用 request_id 关联支持记录。
可以不断切换模型直到成功吗?
不建议。模型切换可能绕开单模型容量问题,但也会改变能力、输出和成本,并受路线、权限与区域限制。先确认任务允许降级,再做一次受控探测。
超时后重发会不会重复扣费或重复执行?
不能仅凭 529 或超时判断。当前第一方错误页面没有给出适用于 direct API、所有网关与所有中途失败的统一计费和幂等规则。先核对用量、上下游日志与外部副作用;高风险写操作无法确认时不要重发。
最后记住这条顺序
遇到 529 overloaded_error 时,安全顺序是:识别请求面 → 保存现场 → 计算已有重试 → 核对部分结果与副作用 → 查对应状态 → 做有限探测 → 缓慢恢复或带证据升级。
如果你现在只能做一件事,就先把完整错误体、时间、provider、模型、request_id 和已经发生的动作保存下来。它们比再点一次“重试”更可能让问题真正结束。