Claude Code 的“5 小时限制用得太快”,不能只凭体感判断是 bug、统一降额或套餐不够。先打开 Settings > Usage,确认正在增长的是五小时会话用量还是周用量;再用 /usage、/context、/model 和认证路线记录当前状态。只有基线清楚后,才做一次只改变一个变量的核对。
最先做的不是清空会话,也不是立刻换套餐。请先保存这组现场信息:
- 当前时间、账号计划,以及 Settings > Usage 中五小时会话和周用量的当前进度;
- Claude Code 的
/usage输出; /context显示的已加载内容;/model显示的当前模型;- 是否存在
ANTHROPIC_API_KEY,以及当前会话究竟使用订阅额度还是 API 计费。
截图或复制这些结果时,隐藏账号信息,并且不要保存或发送 API key 的值。有了这份快照,你未必马上知道根因,但至少不会把不同计数器混成同一个“额度”。
先分清:快掉的到底是哪一条限制
Pro 和 Max 的会话用量按五小时窗口重置,同时还有跨模型计算的周限制。官方没有给出一个适用于所有人的固定消息数;实际可用量会受消息和文件长度、对话长度、模型与所用功能影响。因此,“同样聊了 20 轮”并不等于“应该消耗相同额度”。
Settings > Usage 是判断账号计数器的起点。支持的 Pro、Max、Team 和按席位 Enterprise 账号可在这里看到五小时会话与周用量进度,以及剩余会话时间或重置信息;实际标签可能随计划和账号而不同。Claude Code 内的 /usage 则提供当前会话成本、计划限制与活动统计,具体字段以你本机版本和账号输出为准。
| 你观察到的现象 | 当前能下的结论 | 下一步 |
|---|---|---|
| 五小时会话进度增长快,周进度仍有余量 | 当前先处理会话窗口,不代表周额度异常 | 记录 /usage、模型和上下文,再做一次单变量观察 |
| 周进度已经接近上限 | 等待五小时窗口重置也未必解决周限制 | 以 Usage 页面显示的周重置信息为准 |
/context 显示已加载内容很多 | 上下文是合理候选原因,但还不能证明它就是根因 | 记录当前值,谨慎使用 /compact 后再比较 |
| 订阅进度与预期不一致,同时环境中存在 API key | 需要先确认认证与计费路线 | 不要在没确认费用边界时盲目切换 |
| 这些信息都解释不了变化 | 仍属于未知,不等于已证实事故或统一降额 | 保留时间戳和输出,再查状态或向支持方提供证据 |
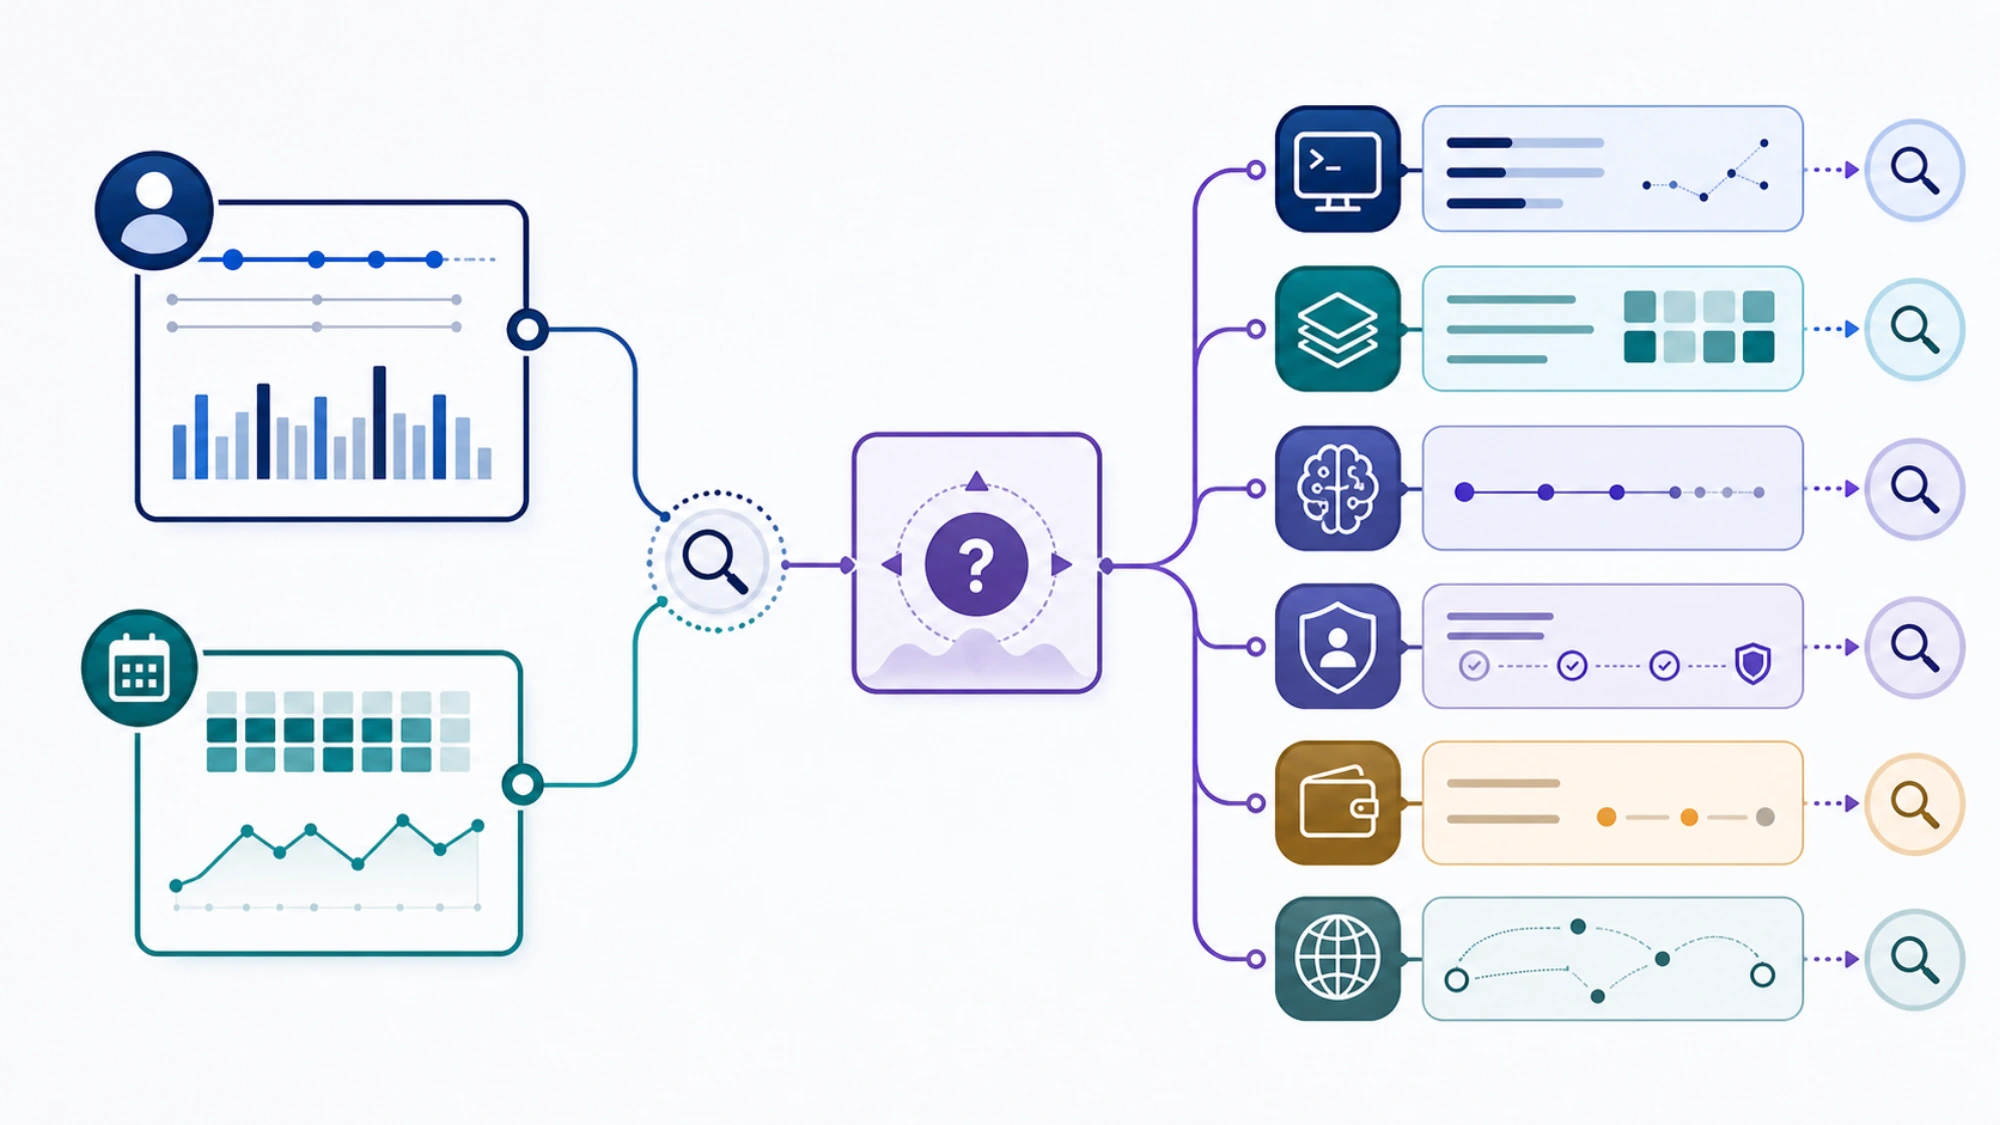
再查认证路线:订阅用量和 API 账单不是一回事
使用 Pro 或 Max 登录 Claude Code 时,Claude 与 Claude Code 会共享订阅用量。另一方面,环境中的 ANTHROPIC_API_KEY 可能让 Claude Code 走 API 计费;API credits 是一套独立的付费系统。
所以,“订阅额度掉得快”和“API 产生费用”不能互相替代解释。先核对当前认证方式,再决定是否调整。不要为了绕过五小时窗口,未经确认就切换到 API;这可能把限额问题变成额外账单。也不要仅凭订阅 Usage 页面的一条进度条推断本机所有请求都走同一路线。
如果你同时在 Claude 网页端、桌面端或 Claude Code 中工作,也要把并行活动记进时间线。共享用量意味着另一处活动可能与 Claude Code 一起消耗订阅额度,但公开资料无法替你确认某个账号当时究竟由哪处活动贡献了多少。
上下文为什么值得查,但不能直接判定为根因
Claude Code 的每一轮都会带上此前对话、项目上下文(例如 CLAUDE.md 和已读取文件)以及新的提示。会话持续变长时,后续轮次处理的上下文也可能增大。
先运行 /context 看当前加载了什么,再决定是否调整:
/compact会把会话压缩成摘要,适合在仍需保留任务脉络时尝试;/clear会开始一个全新会话,而且不可逆,不应作为没有记录现场时的第一反应;- 清理上下文不会恢复已经消耗的额度,它只可能改变后续轮次的输入规模。
因此,正确表述是“上下文可能推动后续用量”,而不是“上下文大就是这次快速耗尽的确定原因”。
模型也会影响用量,但没有通用节省倍数
Anthropic 将 Sonnet 描述为多数编码工作的默认选择;Opus 会使用明显更多的配额。先用 /model 确认当前模型和账号可用选项,再判断任务是否真的需要更高能力的模型。
可以在适合的任务上把模型作为一个观察变量,但不要承诺固定倍数或保证节省。模型之外的对话长度、文件、工具和具体工作量仍会改变结果。一次同时切换模型、清理上下文、关闭工具,最后即使消耗下降,也无法知道是哪项起作用。
先保存基线,再做一次单变量核对
把第一次快照作为基线,然后只选择一个与你现场证据最相关、且后果可控的变量:
- 记下开始时间、Usage 页面进度、
/usage、/context与/model。 - 选择一段规模相近、风险较低的真实工作作为观察任务,不要为了测试额外制造大量请求。
- 一次只调整一项。优先选择容易撤销的变量,例如在任务允许时切换到账号中可用的 Sonnet;若上下文确实较大并准备使用
/compact,先保存必要信息,因为它会改变当前会话状态。不要两项同时改。 - 完成后再次记录同一组信息,比较计数器、上下文和任务结果。
- 如果变化仍无法解释,停止继续试错并保留记录,不要把一次观察包装成普遍规律。
可以把每轮观察压缩成一条记录,前后使用同一组字段:
text起止时间:
账号计划:
Settings > Usage(五小时 / 周):
/usage:
/context:
/model:
订阅或 API 计费路线:
任务与工作量:
本轮唯一改动:
观察结果:
这里记录的是页面与命令实际显示的内容,不要自行换算精确 token 配额,也不要把 API key 的值写进记录。
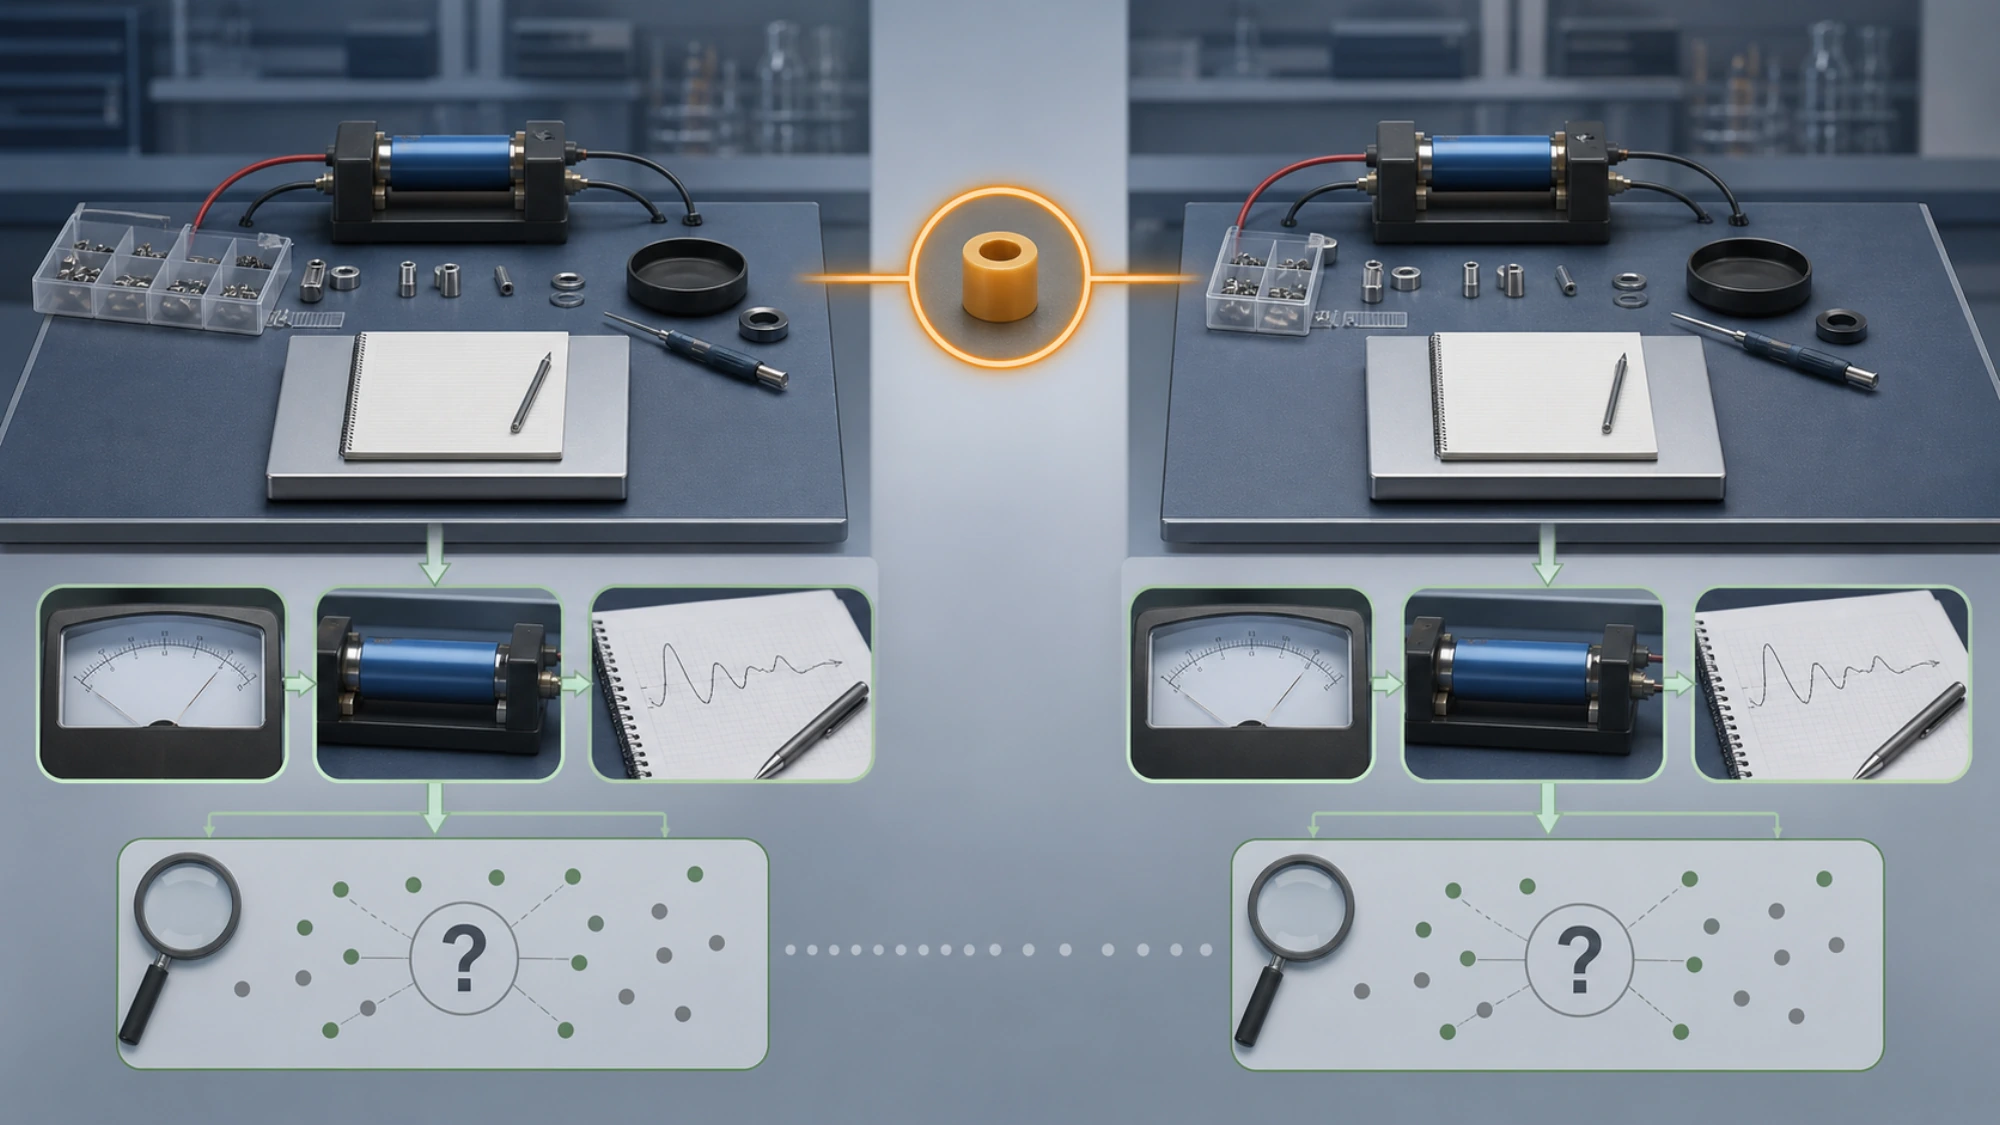
这个方法不会告诉你“每次应该省多少”,但能把“感觉更快”变成可复核的问题:哪条计数器在什么时间段变化、当时使用什么模型、上下文多大、认证走哪条路线,以及改变一项后发生了什么。
哪些说法现在不能当作答案
截至 2026 年 8 月 21 日,已核对的公开资料不能证明所有账号发生了统一限额下调、存在一条普遍的高峰时段加权规则,或近期社区报告背后一定是计量事故。没有公开确认也不能排除账号特定、地区性、尚未披露或后来才确认的问题。
同样不能仅凭公开文档算出你的精确消息数或 token 配额。官方明确指出实际可用量会随输入和使用方式变化,而个体根因还需要计划、认证状态、Usage 页面、命令输出、模型、工具、并行活动、时间戳与实际工作内容。
如果一次单变量观察仍无法解释快速消耗,最有价值的下一步不是继续猜,而是整理以下信息:账号计划、发生时间、五小时与周进度、/usage、/context、/model、认证路线、当时任务和已经做过的单项调整。用这份证据检查 Claude 状态页 或联系支持,才能把“用得太快”变成可以核对的个案。
最短结论
Claude Code 的 5 小时限制用得太快时,先查账号 Usage、/usage、/context、/model 和认证路线。能确认的是不同计数器、共享订阅用量、上下文增长与模型选择都会影响你应如何排查;不能确认的是某个账号的精确根因、固定额度或所谓统一缩水。先分类,后做一次可逆的单变量观察;解释不了就保留证据并停止猜测。