先に結論:定価重視ならDeepSeek、画像入力や総合指標重視ならSol
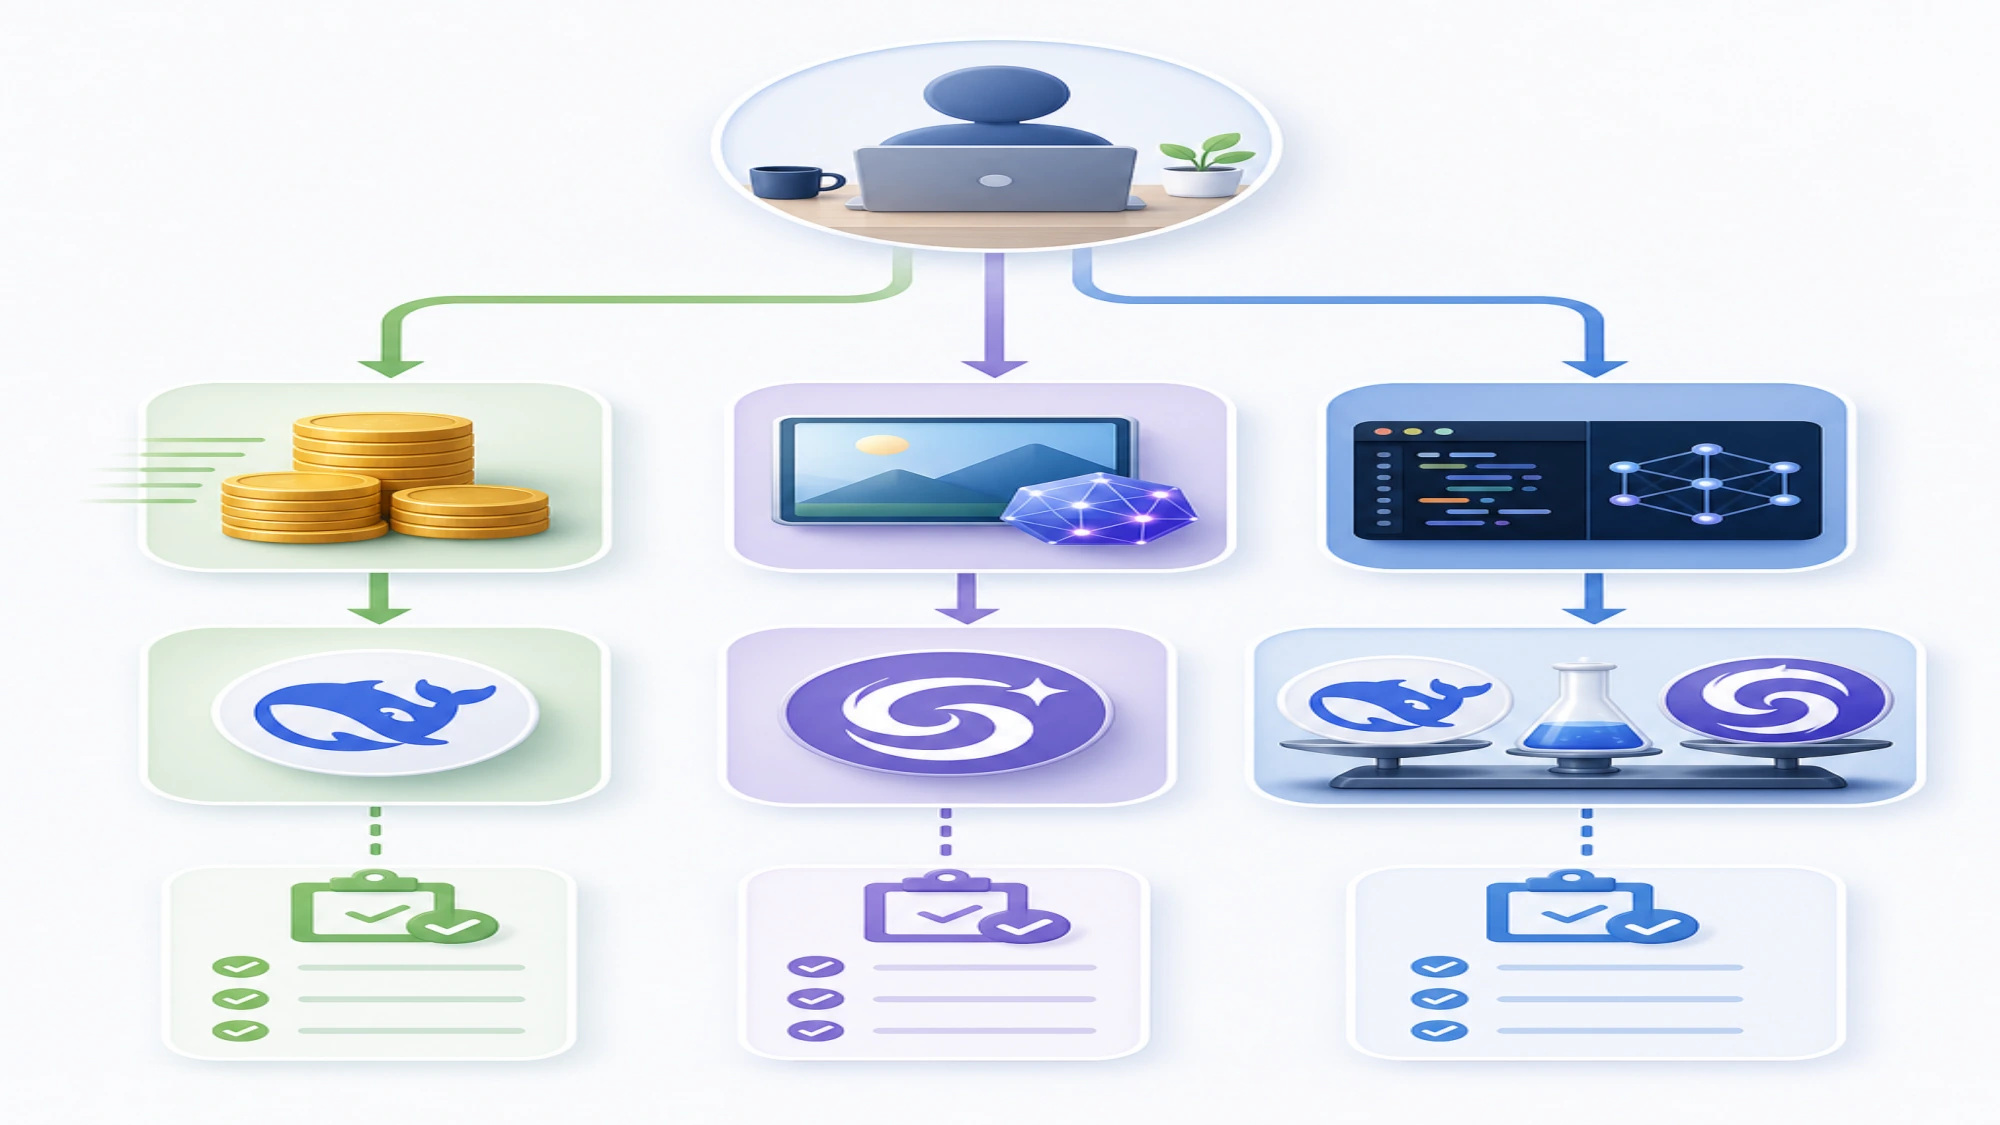
2026年8月13日時点で、最初の検証候補は次のように絞れます。
- 大量のテキスト処理でAPI定価を抑えたいなら、まず
deepseek-v4-proを試す。2026年8月13日時点の入力・出力単価はGPT-5.6 Solより大幅に低い。ただし、DeepSeekは8月16日16:00 UTC(日本時間8月17日1:00)から価格体系を変更する予定なので、当日の単価を長期予算へそのまま使わない。 - 画像入力が必要、または第三者の総合指標で高い側から確かめたいなら、まず
gpt-5.6、つまりGPT-5.6 Solを試す。公式仕様で画像入力が明記され、Artificial Analysisの比較ではIntelligence IndexがDeepSeek V4 Pro 0813を上回る。ただし、この指標だけで自分のコーディングやAIエージェント業務の勝者は決まらない。 - 日本語、コーディング、AIエージェントの実務品質を決めたいなら、最初から一方を勝者にせず、同じタスク、API提供経路、推論強度の方針、反復回数、合格条件で両方を走らせる。現行の0813版とSolをその条件で比較した再現可能な公開実測は、調査時点では確認できなかった。
ここで比較するDeepSeekは旧版やFlashではなく、API上の DeepSeek-V4-Pro-0813 です。GPT-5.6もLunaではなく、gpt-5.6 エイリアスが指す GPT-5.6 Sol を対象にします。「GPT-5.6は安い」という情報の一部はLunaの価格改定を扱っているため、Solの選定にはそのまま使えません。
比較条件を先に固定する
モデル比較が食い違う最大の理由は、名前が似ていても比較対象や測定条件が同じとは限らないことです。今回は次の境界を固定します。
| 比較項目 | DeepSeek V4 Pro | GPT-5.6 Sol |
|---|---|---|
| 現行API上の識別 | deepseek-v4-pro → DeepSeek-V4-Pro-0813 | gpt-5.6 → GPT-5.6 Sol |
| 提供状態 | 2026年8月13日にアプリ、Web、APIで正式提供 | GPT-5.6の最上位モデル |
| 推論強度 | low、high、max | none、low、medium、high、xhigh、max |
| コンテキスト長 | 100万トークン | 105万トークン |
| 最大出力 | 38万4,000トークン | 12万8,000トークン |
| 入出力形式 | テキスト中心。画像入力の可否は今回の根拠だけでは確定しない | テキスト・画像入力、テキスト出力 |
| API上の主な機能 | thinking/non-thinking、JSON、ツール呼び出し、Responses API、Anthropic互換形式 | Responses APIで利用できるSolの公式仕様 |
DeepSeek側のモデル名と仕様は公式アップデートおよび公式モデル・価格表に基づきます。GPT側はGPT-5.6 Solの公式モデルページに基づきます。
この表で分かるのはAPIの提供仕様です。日本語の自然さ、コード修正の成功率、ツール呼び出しの安定性、長いAIエージェント実行の完遂率までは証明しません。また、DeepSeekの公開ウェイトとAPIで配信される0813版が同一の挙動を持つことも、今回確認した第一方資料では確定できません。セルフホストの判断へAPI測定値を転用しないでください。
価格は「8月13日」と「8月16日以降」を分ける
2026年8月13日時点のAPI定価
100万トークン当たりの米ドル建て定価は次の通りです。
| モデル | キャッシュヒット入力 | 通常/キャッシュミス入力 | 出力 |
|---|---|---|---|
| DeepSeek V4 Pro | $0.003625 | $0.435 | $0.87 |
| GPT-5.6 Sol | $0.50 | $5.00 | $30.00 |
同じトークン量を単純に定価へ掛ける限り、DeepSeekの方が大幅に安くなります。ただし、ここから「DeepSeekの方が常に費用対効果が高い」とは言えません。合格までの反復回数、失敗後の再試行、ツール呼び出し、推論トークン、キャッシュヒット量が、成功タスク当たりの総費用を変えるからです。
GPT-5.6 Solでは、入力が27万2,000トークンを超えるリクエストについて、リクエスト全体の入力単価が2倍、出力単価が1.5倍になると公式ページに明記されています。長大な入力を送る用途では、105万トークンという上限だけでなく、この料金分岐を見積もりへ入れる必要があります。
DeepSeekは8月16日16:00 UTCに価格変更予定
DeepSeekは、2026年8月16日16:00 UTCからピーク/オフピーク制を導入すると告知しています。日本時間では 8月17日1:00 の予定です。
| 予定区分 | キャッシュヒット入力 | キャッシュミス入力 | 出力 |
|---|---|---|---|
| オフピーク | $0.022 | $0.66 | $1.98 |
| ピーク | $0.044 | $1.32 | $3.96 |
告知されたピーク時間は01:00–04:00 UTCと06:00–10:00 UTCです。日本時間に直すと10:00–13:00と15:00–19:00になります。これは8月13日時点では将来価格であり、発効後の請求を確認した事実ではありません。実装や予算を確定する前に、8月17日1:00以降の公式表と自分の請求明細を再確認してください。
同じトークン量でも、成功タスク当たりの費用は変わる
例として、キャッシュを使わず、10万トークンを入力し、2万トークンを出力する1回の処理を考えます。税、ゲートウェイ手数料、再試行、ツール実行は含めません。
- 8月13日時点のDeepSeek:
0.1 × $0.435 + 0.02 × $0.87 = $0.0609 - GPT-5.6 Sol:
0.1 × $5 + 0.02 × $30 = $1.10 - 予定されるDeepSeekオフピーク:
0.1 × $0.66 + 0.02 × $1.98 = $0.1056 - 予定されるDeepSeekピーク:
0.1 × $1.32 + 0.02 × $3.96 = $0.2112
これは品質差を含まない単価計算です。安いモデルが合格までに計3回の実行を要し、高いモデルが1回で合格するなら、差は縮まります。逆に、同じ合格率を保てる大量処理なら定価差がそのまま効きやすくなります。
第三者計測は「方向」を見る。勝者の証明には使わない
Artificial Analysisの比較では、DeepSeek V4 Pro 0813 Max EffortとGPT-5.6 Sol highが次のように報告されています。
| 第三者計測 | DeepSeek V4 Pro 0813 | GPT-5.6 Sol |
|---|---|---|
| Intelligence Index | 53 | 57 |
| Blended Price(混合単価) | $0.18 | $4.35 |
| 出力速度 | 約83トークン/秒 | 約56トークン/秒 |
| 初回トークンまでの時間 | 約1.63秒 | 約19.28秒 |
この結果は、Solが集計上のIntelligence Indexで高く、DeepSeekが混合単価と応答特性で有利な可能性を示す材料です。しかし、比較時の推論強度はDeepSeekがmax、Solがhighで同一ではありません。Blended Priceもキャッシュ入力・通常入力・出力を7:2:1で混ぜた同サイト独自の算出値であり、各社の単純な定価表でも、あなたの実際のトークン構成でもありません。
したがって、この数値から「Solは必ず高品質」「DeepSeekは必ず高速」「どちらかが日本語コーディングで勝つ」と結論づけることはできません。集計指標は候補を減らすために使い、最終判断は自分の受け入れ条件で行うのが安全です。
用途別に、どちらを最初に試すか
大量の分類、抽出、変換、要約
出力の合否を機械的または短時間で判定でき、画像入力が不要なら、DeepSeek V4 Proから始める理由が強い用途です。現在の定価差が大きく、第三者測定でも価格と速度に有利な方向が報告されています。
ただし、低価格を理由に品質確認を省かないでください。JSONスキーマ遵守率、欠落率、再試行率、長文末尾の取りこぼしを測り、成功した1件当たりの費用へ換算します。8月17日1:00(日本時間)以降をまたぐ運用なら、ピーク/オフピークの比率もログに残します。
難しい推論や高品質コーディング
第三者の総合指標で高い側から試したいなら、GPT-5.6 Solを先に置く判断ができます。推論強度を細かく選べるため、品質と待ち時間の関係も段階的に確認できます。
ただし、公開指標はあなたのリポジトリやAIエージェント環境での成功率ではありません。バグ修正なら、テスト合格、変更範囲、回帰、レビュー後の修正回数を同時に測ります。コード生成の見た目や1回のデモではなく、受け入れ可能な変更を得るまでのトークン、時間、再試行回数を比較してください。
画像を含む入力
画像入力が必須なら、公式仕様で対応が明記されているGPT-5.6 Solを最初に試すのが明確です。今回確認したDeepSeek V4 Proの公式API資料からは、同じ画像入力条件を保証できません。
これは「画像理解ではSolが勝つ」という意味ではありません。必要な入力形式が公式に提供されている側から検証を始める、というAPI仕様上の判断です。
12万8,000トークンを超える長い出力
仕様上の最大出力はDeepSeek V4 Proが38万4,000トークン、GPT-5.6 Solが12万8,000トークンです。単一レスポンスで12万8,000トークンを超える出力が本当に必要なら、DeepSeekを先に検証する理由になります。
一方、最大値に近い出力が安定して得られることや、その長さが読者・システムにとって有用であることは別問題です。分割生成、チェックポイント、検証、再開を含めた設計の方が安全な場合もあります。上限値だけで運用品質を判断しないでください。
地域、支払い、データ取り扱いが重要
日本での支払い方法、税、割り当て上限、データ保管地域、ネットワーク遅延、サポート条件は、今回の公開資料だけでは確認できません。日本向けの検索結果やグローバルなAPI文書は、日本のアカウントで同じ条件が使える証明にはなりません。
この条件が選定を左右するなら、両サービスで実際に使う組織アカウントを用意し、請求画面、契約、データ処理条件、レート制限、東京からの実測遅延を確認してから決めます。
比較テストは「同じプロンプト」だけでは足りない
公平な比較には、入力文を揃える以上の固定が必要です。少なくとも次を同一にします。
- API経路:公式API同士、または同じゲートウェイ内で比較する。片方だけ異なる提供経路にしない。
- モデルIDと日付:
deepseek-v4-proが0813版を指すこと、gpt-5.6がSolを指すことを実行ログに残す。 - 推論条件:名称が同じでも計算量が同等とは限らない。設定値と課金トークンを保存する。
- タスク集合:日常の簡単な例だけでなく、失敗すると困る境界ケースを含める。
- 反復回数:各タスク1回で決めず、ばらつきと失敗率を確認する。
- 合格条件:正確性、スキーマ、テスト、引用、禁止事項などを実行前に固定する。
- 総コスト:入力・キャッシュ・出力・推論・再試行・ツール呼び出しを含め、合格したタスク数で割る。
- 時間:初回トークンだけでなく、ツール実行を含む完了時間とタイムアウト率を測る。
評価表には、単なる「良い/悪い」ではなく、合否、修正回数、総トークン、請求額、完了秒、失敗理由を1実行ごとに残します。日本語品質なら、敬語の自然さ、指示の省略解釈、固有名詞、長文の参照関係など、実務で差が出る条件を合格基準へ入れます。
採用前に確認する最小チェック
- 比較対象がDeepSeek-V4-Pro-0813とGPT-5.6 Solになっているか。
- DeepSeekの費用は、実行日のピーク/オフピークを反映しているか。
- Solで27万2,000トークンを超える入力がある場合、割増を含めたか。
- キャッシュ率ではなく、実際のキャッシュヒット分のトークン数を記録したか。
- 同じAPI提供経路、タスク、推論強度の方針、反復回数、合格条件で走らせたか。
- 「1回当たり」ではなく「合格タスク当たり」の費用を比べたか。
- 公開ウェイトの結果とDeepSeek API版の結果を同一視していないか。
- 日本のアカウント条件、税、割り当て上限、データ取り扱いを実画面・契約で確認したか。
最終的な選択は一つである必要もありません。定型の大量処理をDeepSeekへ、画像入力や難しい案件の検証をSolへ振り分け、失敗時だけ別モデルへ回す構成も候補です。ただし、その振り分けが得かどうかも、成功タスク当たりの費用と完了時間で判断します。
いま選ぶなら、結論は「条件付き」
DeepSeek V4 Proは、現行API定価と第三者の速度・価格指標を重視するなら、最初に試す価値が高いモデルです。GPT-5.6 Solは、画像入力が必要な場合や、第三者のIntelligence Indexで高い側から検証したい場合に先行候補になります。
それ以上の「日本語ではどちらが上か」「コーディングの総合勝者はどちらか」という問いには、公開根拠だけで確定回答できません。版、モデル階層、価格時点を揃えたうえで、同じ仕事を複数回実行し、合格率、総トークン、請求額、再試行回数、完了時間を比較してください。その結果が、あなたの環境における最も再現可能な答えです。