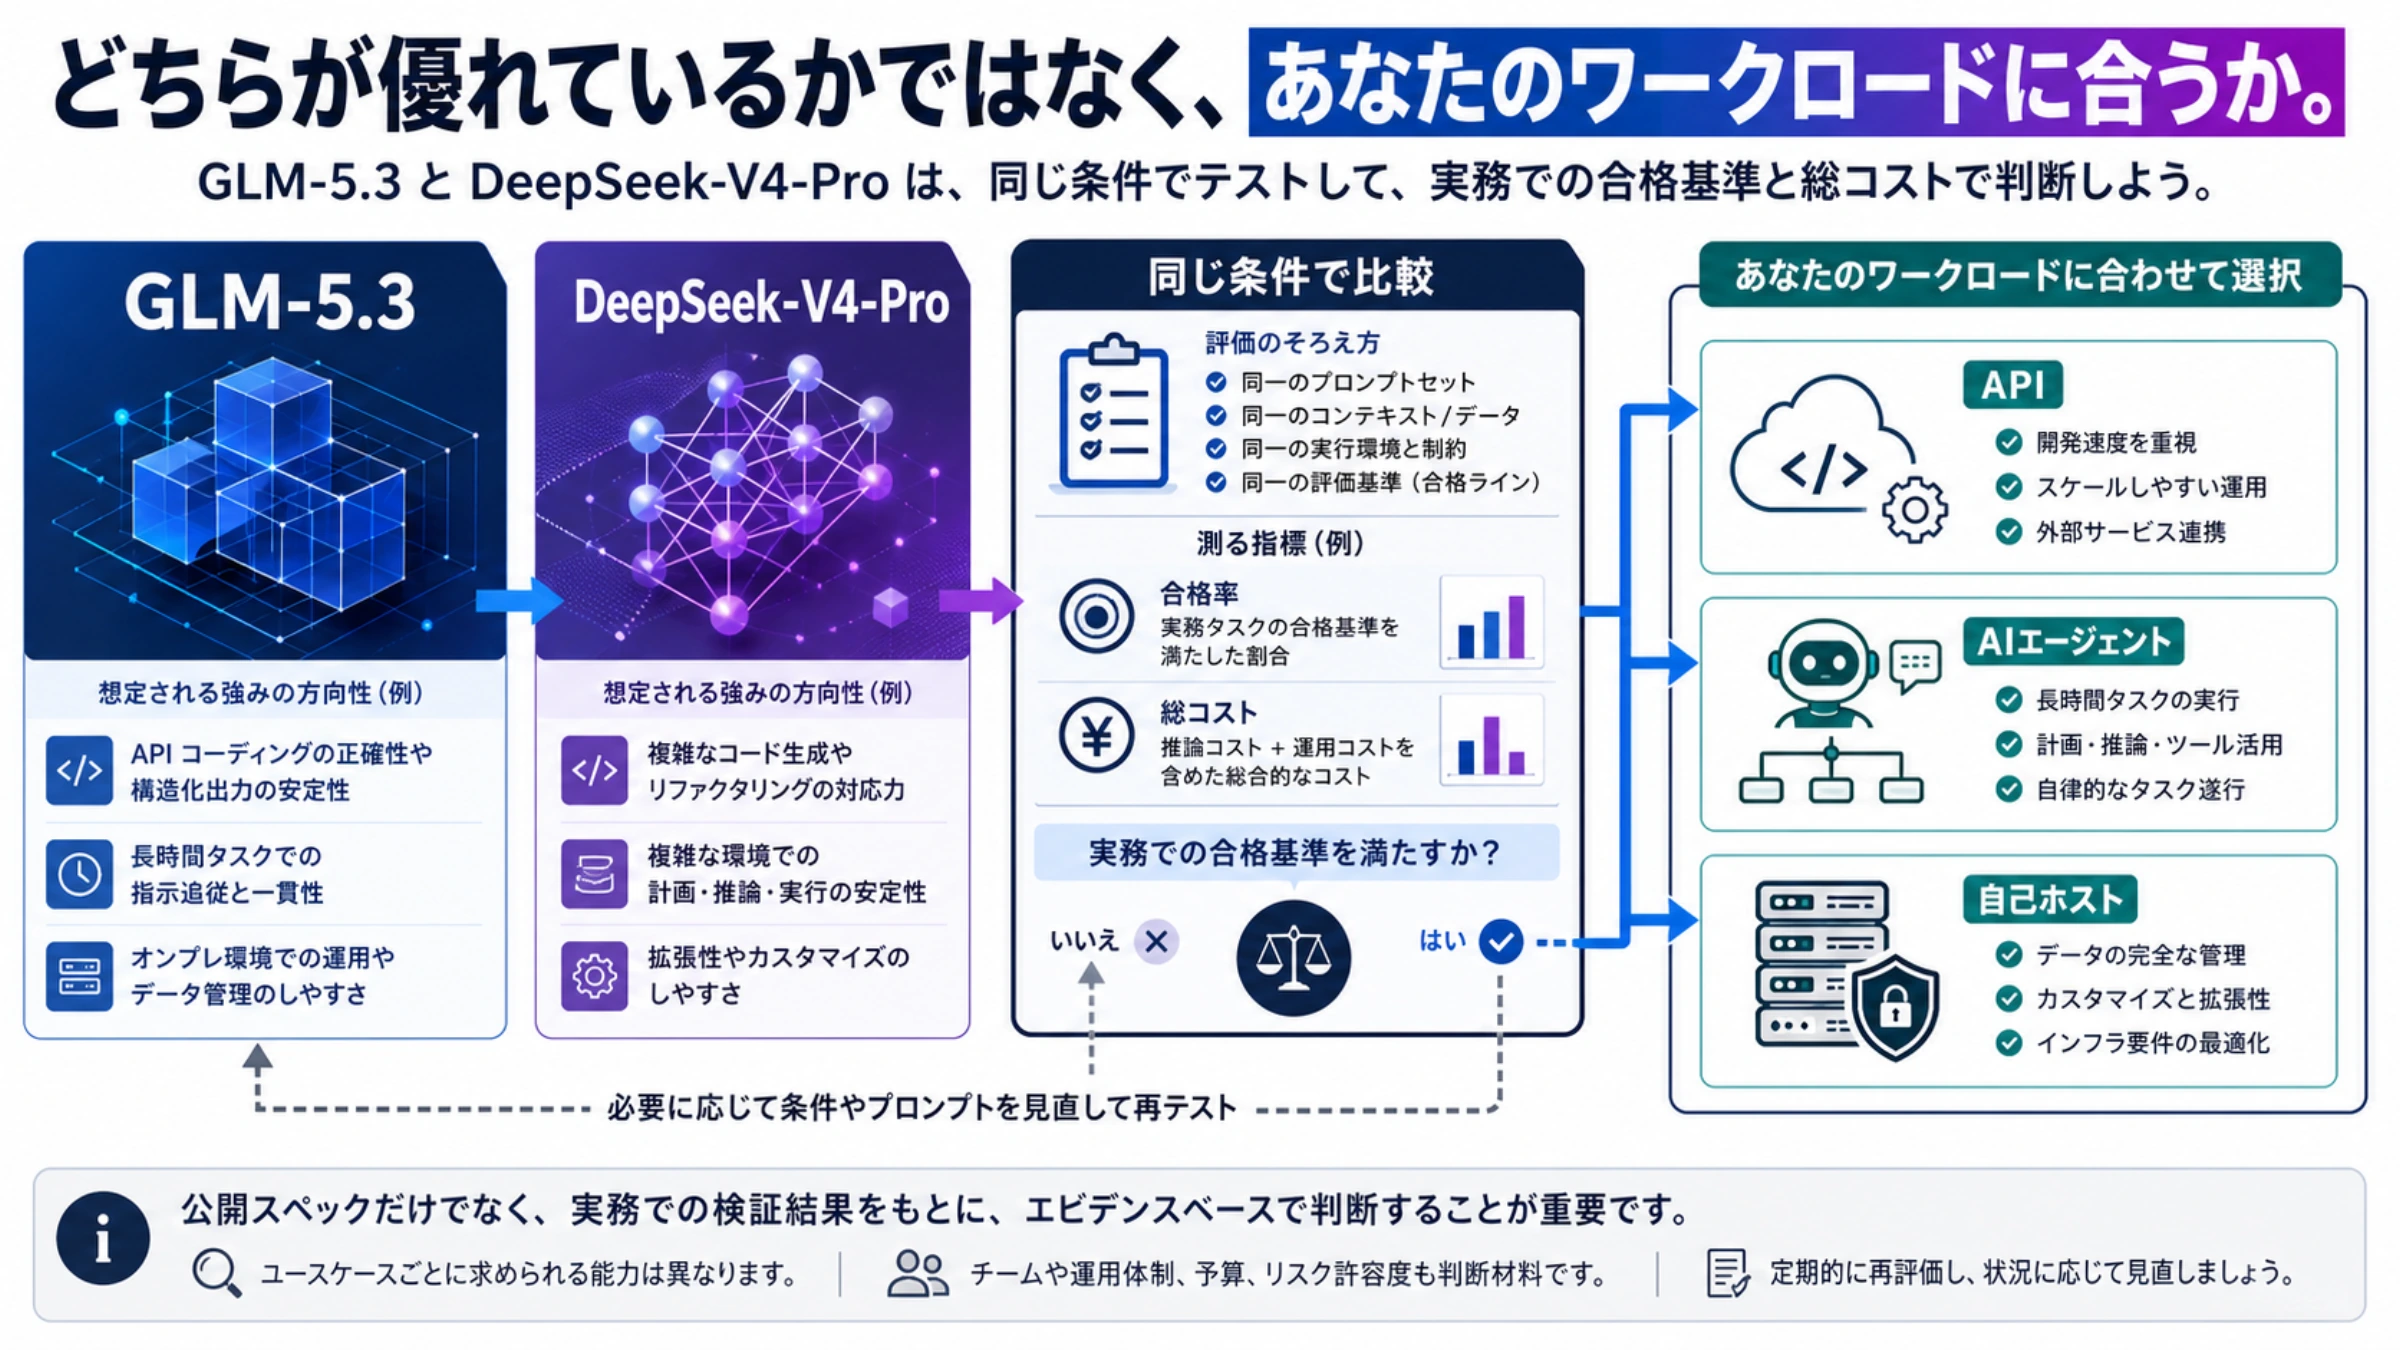
先に結論を言うと、公開情報だけで決められる「総合1位」はありません。 APIでコーディングや長時間のAIエージェント処理を行うなら、GLM-5.3とDeepSeek-V4-Proを同じタスクで試し、完了率と総コストで選ぶのが安全です。一方、公開ウェイトを自分で運用したい場合は、MITライセンスのウェイトを確認できるDeepSeek-V4-Proが先行候補になります。
選び分けの出発点は次のとおりです。
- 自己ホストを前提にする:公開ウェイトと導入手順を確認できるDeepSeek-V4-Proから検証する。
- 非常に長い出力やResponses APIを重視する:最大出力384K、Responses API対応を掲げるDeepSeek-V4-Proが仕様上は合わせやすい。
- Z.aiのAPIやCoding Planで開発を進める:GLM-5.3を候補にし、
reasoning_effortと実タスクの完了率を測る。 - 画像や動画も入力したい:テキスト専用の両旗艦だけで判断せず、GLM-5.3-Flashまたは実験版DeepSeek V4 Flash Visionを別枠で評価する。
- 品質を最優先する:ベンダー公表ベンチマークではなく、自社のプロンプト、ツール、タイムアウト、受け入れ条件をそろえて比較する。
まず、比較対象を現在のモデルにそろえる
古い比較記事ではGLM-4.7、GLM-5.2、DeepSeek V3.2などが混在しています。2026年8月27日に公式情報で確認できる主な比較対象は、Z.aiの GLM-5.3 とDeepSeekの DeepSeek-V4-Pro-0813 です。
| 項目 | GLM-5.3 | DeepSeek-V4-Pro |
|---|---|---|
| APIモデルID | glm-5.3 | deepseek-v4-pro(提供版はDeepSeek-V4-Pro-0813) |
| 主な入力 | テキスト | テキスト |
| コンテキスト | 1Mトークン | 1Mトークン |
| 最大出力 | 128Kトークン | 最大384Kトークン |
| 推論強度 | 常時推論、low / high / max | low / high / max |
| API・機能 | Function Calling、Structured Output、Context Cachingなど | JSON、Tool Calls、Responses API、Anthropic APIなど |
| 公開ウェイト | 2026年8月27日の確認では公開を確定できず | 公式Hugging FaceでMITライセンスのウェイトを公開 |
| API定価(100万トークン) | 入力 $1.40、キャッシュ入力 $0.26、出力 $4.40 | キャッシュヒット入力 $0.022〜$0.044、キャッシュミス入力 $0.66〜$1.32、出力 $1.98〜$3.96 |
仕様はGLM-5.3公式ドキュメント、DeepSeekの価格・モデル表、DeepSeek V4 Proの公開ウェイトに基づきます。価格は2026年8月27日に確認した公開リスト価格で、DeepSeekはオフピークとピークの幅です。税、為替、決済可否、キャッシュ命中率、ツール呼び出し、再試行、人手修正は含みません。
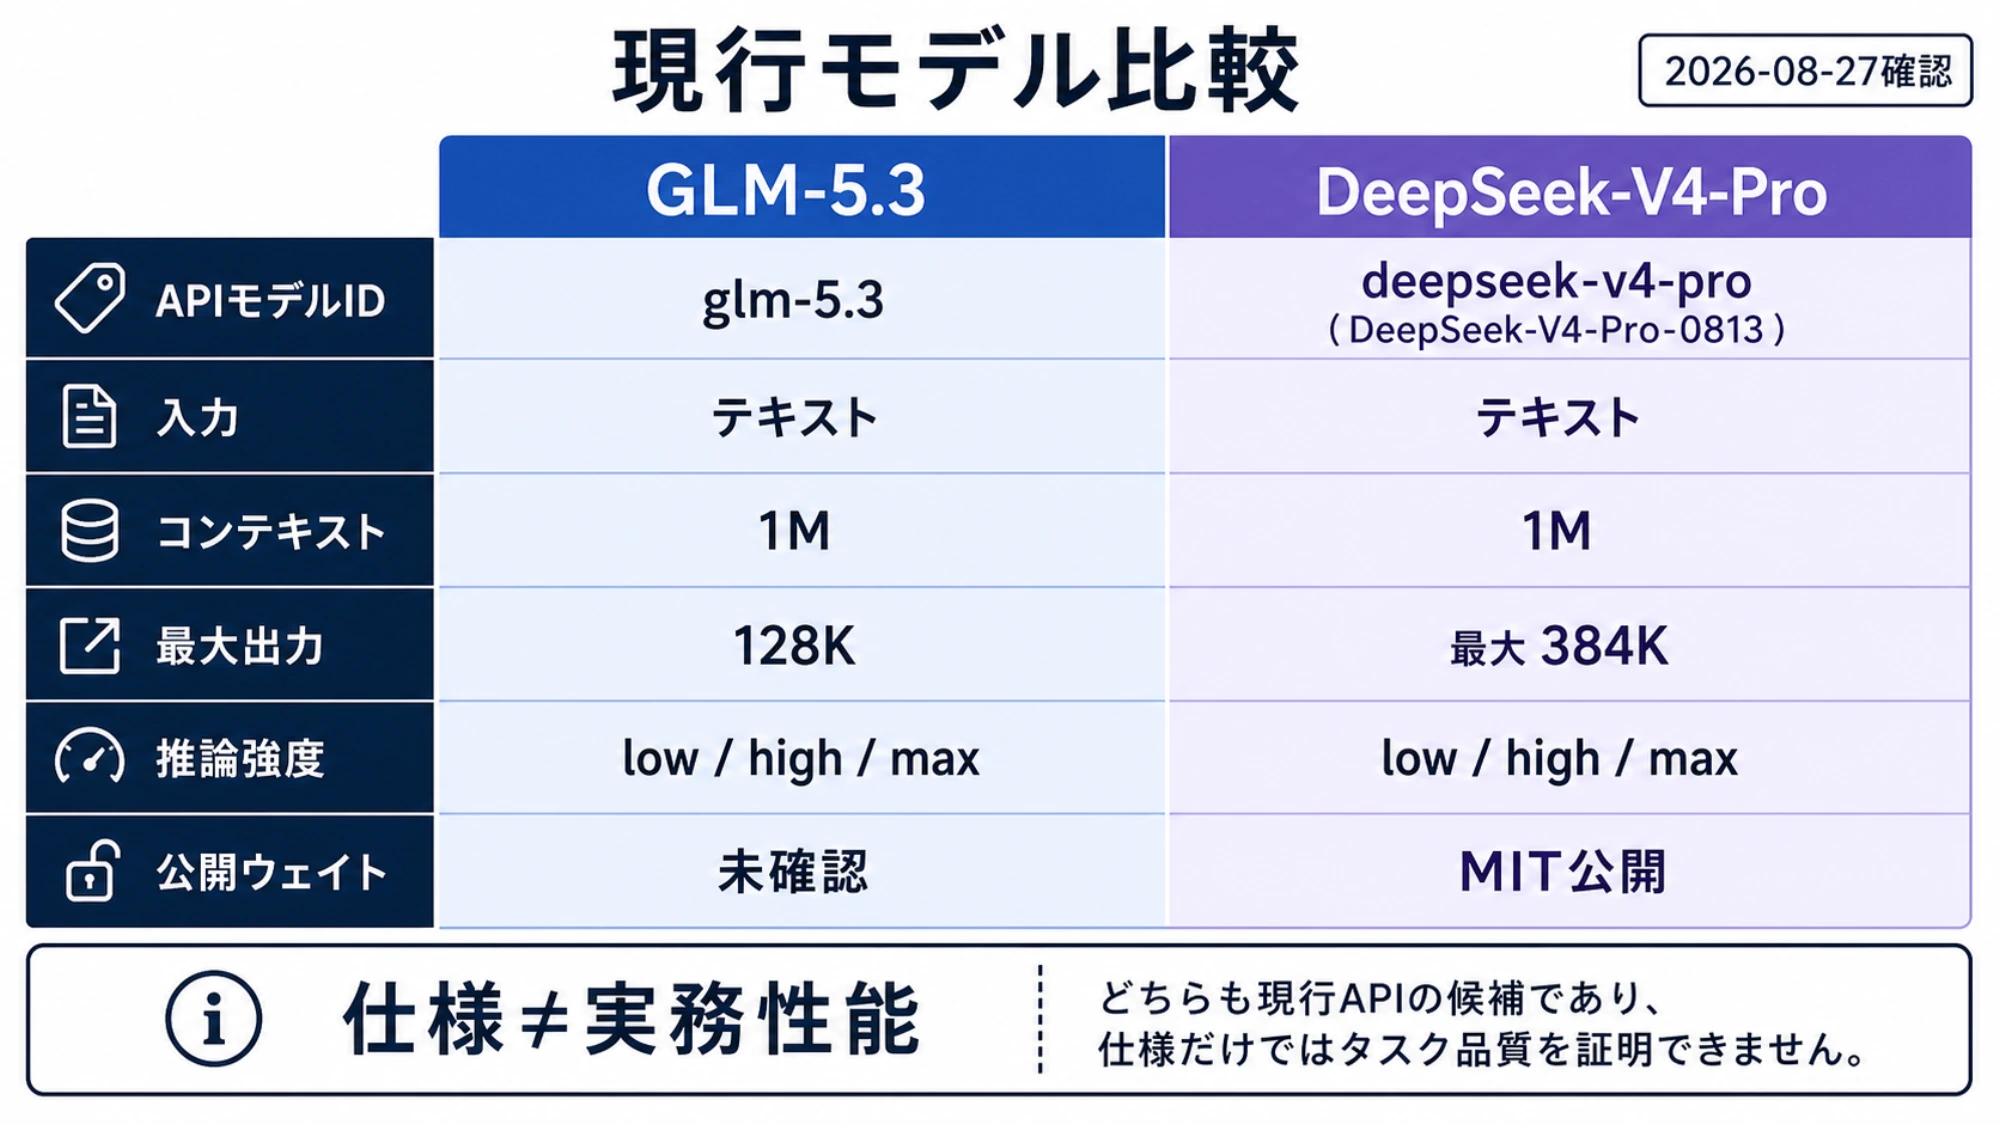
この表だけで性能の勝敗は決まりません。1Mトークンを受け取れることと、長い入力全体から必要情報を安定して拾えることは別です。同様に、最大出力が大きくても、実務で正しい成果物を一度で完成できるとは限りません。
コーディングとAIエージェントでは「最後まで終わるか」を比べる
Z.aiはGLM-5.3について、GLM-5.2からコーディングと長時間のAIエージェント処理が改善したと報告しています。DeepSeekもV4-Pro-0813のエージェント系ベンチマーク向上を報告しています。ただし、両社の数値は同一のハーネス、エンドポイント、推論強度、ツール予算、評価者で測られた直接対決ではありません。
したがって、公開スコアを横に並べて「GLMが上」「DeepSeekが上」と結論づけるのは早計です。実務では次の指標の方が役立ちます。
- タスク完了率:テスト、lint、型検査、受け入れ条件をすべて満たした割合。
- 初回合格率:人が追加指示を出さずに完了した割合。
- 修復コスト:再試行回数、追加トークン、人のレビュー時間。
- ツールの安定性:引数スキーマ違反、空の呼び出し、同じ操作のループ回数。
- 時間上限内の成功率:長い推論が品質向上につながったか、単に待ち時間が増えたか。
セキュリティ用途には限定的な第三者比較もあります。Aikido Securityは、インターネット接続を切った32件の脆弱性探索で10モデルを各ケース3回試し、DeepSeek V4 ProがGLM-5.3より多くの脆弱性を拾った一方、候補報告と誤検知も多かったと報告しています。これは特定のサイバーセキュリティ用ハーネスの結果であり、一般的なコーディング、推論、速度、価格、安全性の総合判定には使えません。
API統合では、モデル名より運用条件を見る
GLM-5.3が合わせやすいケース
GLM-5.3はテキスト専用で、1Mコンテキスト、最大128K出力、常時推論を提供します。reasoning_effort は low、high、max から選べるため、同じタスクで品質・待ち時間・消費トークンの折り合いを確認できます。
Z.aiの既存APIやCoding Planを使っており、Function Calling、Structured Output、Context Cachingを含む実装経路を短くしたい場合は、有力な検証候補です。ただし、公開仕様は日本からの契約可否、実効レート制限、SLA、データ所在地まで保証しません。
DeepSeek-V4-Proが合わせやすいケース
DeepSeek-V4-Proは1Mコンテキスト、最大384K出力に加え、OpenAI Responses APIとAnthropic API互換の経路を案内しています。既存のAIエージェント基盤がこれらの形式を前提としている場合、移植範囲を抑えられる可能性があります。
ただし、「互換」と「完全に同じ挙動」は同義ではありません。ストリーミング、Tool Calls、エラー形式、トークン計数、再試行時の冪等性まで、実際のクライアントで確認してください。DeepSeekのV4 Proリリース案内は提供機能を確認する入口として使えます。
マルチモーダルは旗艦同士の比較から分離する
glm-5.3 と deepseek-v4-pro は、今回確認した仕様ではどちらも主にテキストモデルです。画像入力が必要なら、モデル名の近さだけで混ぜず、別の候補群として試します。
- GLM-5.3-Flash:テキスト、画像、動画、ファイル入力、1Mコンテキスト、Function Calling、Structured Output、Context Cachingを掲げるGLM-5系のネイティブマルチモーダルモデルです。仕様はGLM-5.3-Flash公式ドキュメントで確認できます。
- DeepSeek V4 Flash Vision:
deepseek-v4-flash-vision-expはテキストと画像を扱う実験モデルです。公式更新履歴でも実験版とされているため、長期運用の安定性や互換性は本番投入前に別途検証が必要です。
なお、GLM-5.3-Flashの入力 $0.075、キャッシュ入力 $0.015、出力 $0.25という価格は、2026年9月9日24:00(UTC+8)までの50%割引として掲載されたものです。恒久価格として予算計画に固定しないでください。
自己ホストならDeepSeekが先、ただし運用費まで測る
DeepSeekはDeepSeek-V4-Pro-0813のウェイトをMITライセンスで公開し、vLLMとSGLangによる導入手順を示しています。そのため、ウェイトを自社環境で動かすことが必須なら、現時点ではDeepSeekから技術検証を始める理由があります。
一方、ウェイトが公開されていることは「安く運用できる」ことを意味しません。必要なGPU構成、量子化後の品質、並列度、消費電力、障害対応、モデル更新、監視まで含めると、APIより総コストが高くなることもあります。少なくとも次を測ってからAPIと比較します。
- 目標同時実行数でのp50・p95レイテンシ
- 1時間あたりの処理トークンと完了タスク数
- 量子化前後の受け入れテスト合格率
- GPU、電力、運用担当、監視を含む月額原価
- モデル更新時の再評価と切り替えに必要な工数
GLM-5.3については、今回確認した時点で公式ウェイトの実利用を確定できませんでした。予告や第三者ミラーを根拠に本番計画を立てず、公式の配布URL、ライセンス、チェックサム、推奨ランタイムを入手できた時点で再評価するのが安全です。
価格は「100万トークン単価」ではなく完了タスク単価で比べる
公開リスト価格だけならDeepSeek-V4-Proは低く見えます。しかし、AIエージェント処理では出力トークン、キャッシュ命中、ツールの往復、失敗時の再実行、人の手直しが総額を左右します。
比較に使う式はシンプルです。
text1タスクの総コスト =
  入力トークン費
  + キャッシュ入力費
  + 出力トークン費
  + ツール/API費
  + 失敗時の再試行費
  + 人手修正の時間原価
たとえば、安いモデルが3回の再試行を必要とし、高いモデルが1回で受け入れ条件を満たすなら、単価と総コストの順位は逆転します。逆に、低い reasoning_effort で多数の定型タスクを安定処理できるなら、そのモデルの方が大量実行に向きます。
小規模な選定テストを同一条件で行う
まず各モデルに同じ5〜10件の代表タスクを渡します。ベンチマーク用の小問ではなく、実際に投入予定の作業から、短い修正、複数ファイル変更、ツール利用、長文入力、失敗しやすい境界条件を含めて選びます。
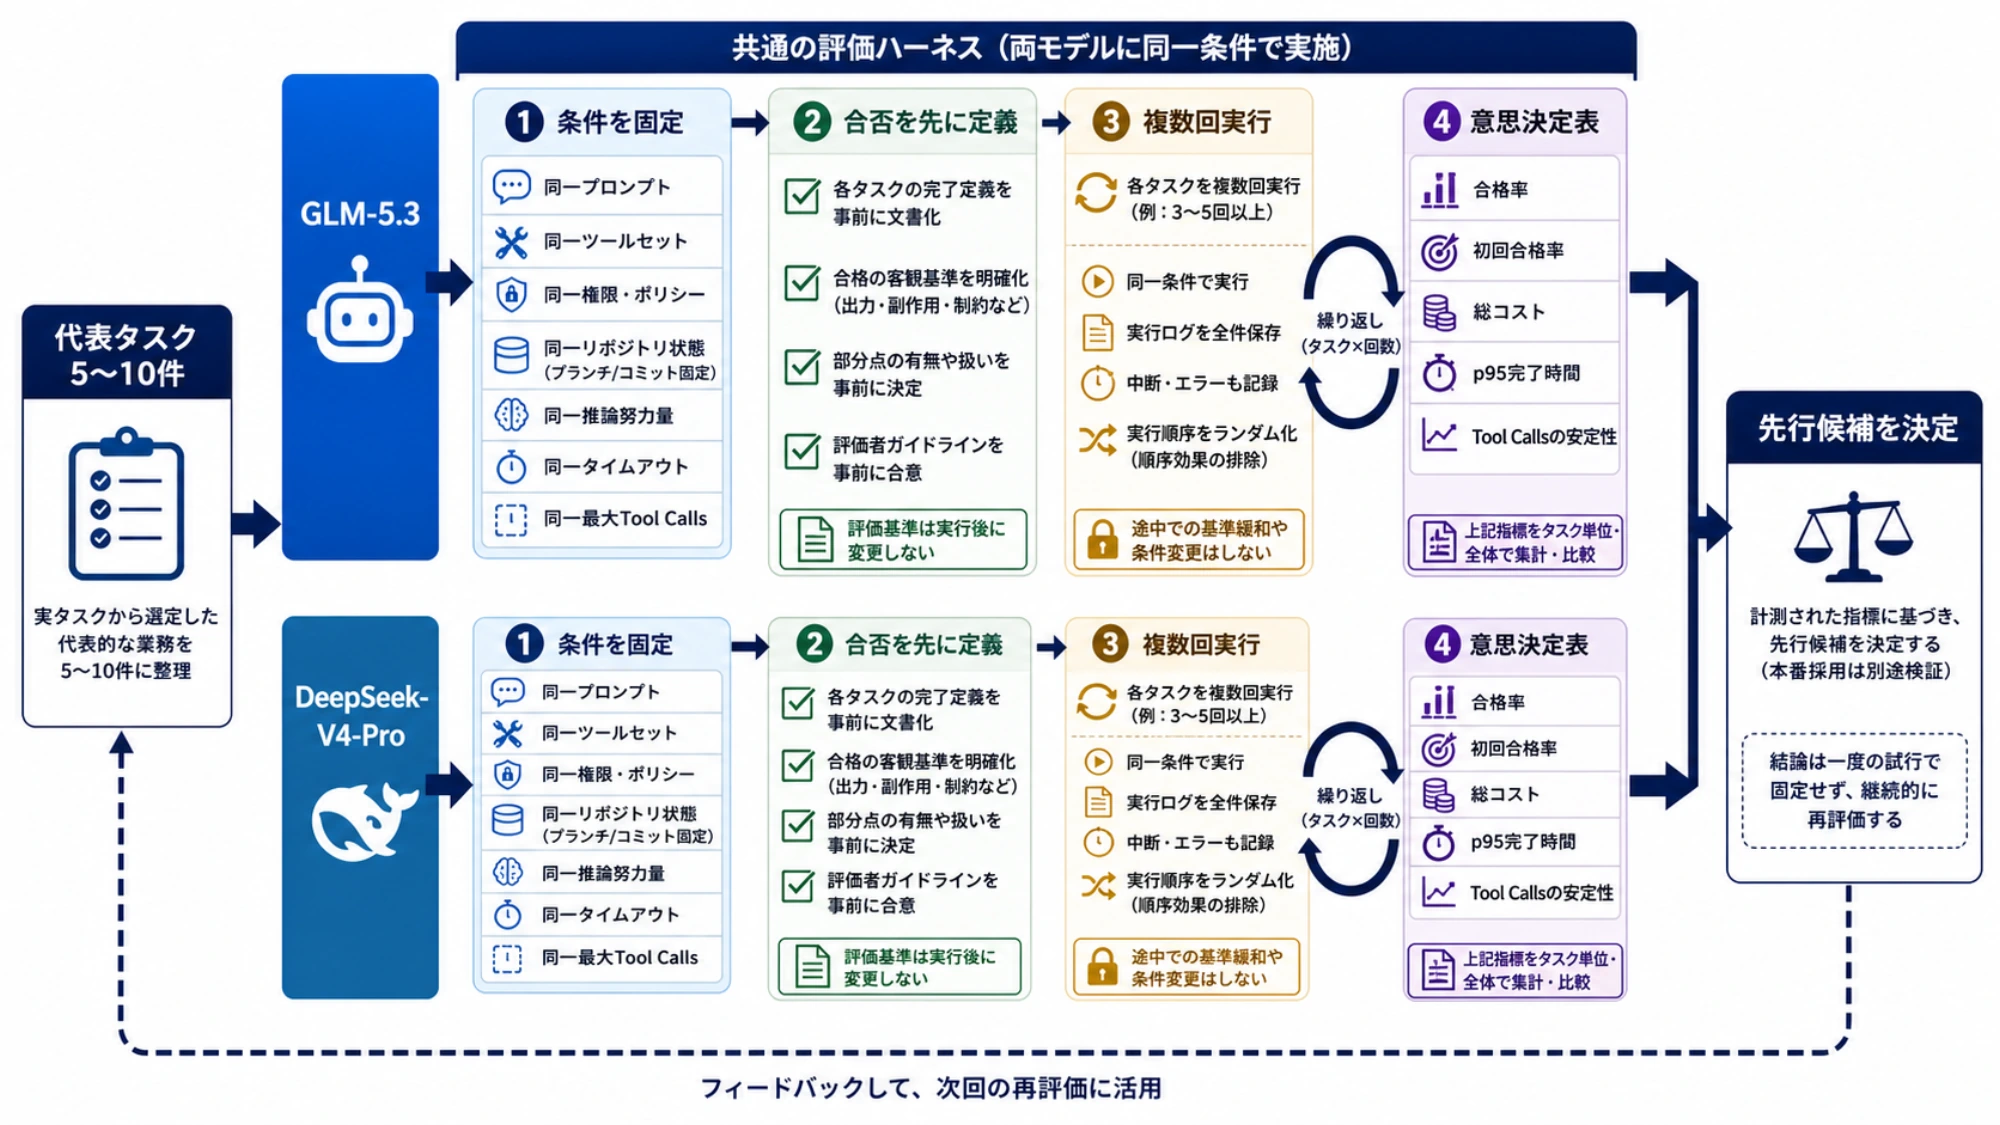
1. 条件を固定する
- 同じシステムプロンプトとユーザープロンプト
- 同じツール、権限、リポジトリ状態
- 同じ
reasoning_effort - 同じ最大出力、タイムアウト、最大ツール回数
- 温度などの生成設定を可能な範囲で一致
- キャッシュ利用の有無を記録
2. 合否を先に定義する
コードなら、テスト、型検査、lint、差分範囲、セキュリティ条件を自動判定にします。調査エージェントなら、必須ソース、引用の正確性、未確認事項の明示、期限内完了を合否条件にします。モデルの出力を見てから基準を緩めないことが重要です。
3. 各タスクを複数回実行する
LLMの結果にはばらつきがあります。1回の成功例だけで決めず、少なくとも各タスクを複数回実行し、成功数、所要時間、入力・出力トークン、ツール回数、再試行、人手修正を記録します。
4. 意思決定表に集約する
| 指標 | 重みの例 | GLM-5.3 | DeepSeek-V4-Pro |
|---|---|---|---|
| 受け入れ条件の合格率 | 40% | 実測 | 実測 |
| 初回合格率 | 20% | 実測 | 実測 |
| 完了タスクあたり総コスト | 20% | 実測 | 実測 |
| p95完了時間 | 10% | 実測 | 実測 |
| Tool Callsの安定性 | 10% | 実測 | 実測 |
重要なのは、この重みを自社の失敗コストに合わせることです。大量の定型処理ならコストと速度を重くし、コード変更やセキュリティ判断なら合格率と誤検知率を重くします。
日本から使う前に確認すべき契約・データ条件
公式ページにアクセスできることは、日本居住者や日本法人がそのまま契約・決済できる証拠ではありません。試験導入の前に、両サービスについて次を確認してください。
- 新規登録、支払手段、請求通貨、税、適格請求書の扱い
- 利用可能地域と契約主体
- プロンプトと生成物の保存期間、学習利用、削除方法
- データ所在地、越境移転、サブプロセッサ
- 法人向けSLA、障害通知、監査資料、サポート窓口
- 日本からの実効レイテンシ、スループット、レート制限
これらは今回確認した公開モデル・価格ページだけでは確定できません。機密データを送る前に、実際のアカウント画面と契約文書で確認し、必要なら法務・セキュリティ審査を通してください。
よくある質問
GLMとDeepSeekでは、結局どちらがコーディングに強いですか?
同一条件で十分に反復されたGLM-5.3対DeepSeek-V4-Proの独立比較は、今回確認した資料では確立できませんでした。両社とも改善を報告していますが、評価条件が一致しません。自分のリポジトリと受け入れテストで完了率を測るのが確実です。
どちらのAPIが安いですか?
2026年8月27日の公開リスト価格ではDeepSeek-V4-Proの単価が低く見えます。ただし、時間帯、キャッシュ命中、出力量、再試行、人手修正、税・為替・決済条件を含む総コストでは逆転し得ます。完了タスクあたりで比較してください。
長いコンテキストなら同じ性能ですか?
いいえ。両方が1Mコンテキストを掲げていても、必要情報の検索、長文中の指示維持、ツール実行、正確な最終出力は別の能力です。実データに似せた長文テストが必要です。
画像入力にはどちらを選びますか?
GLM-5.3とDeepSeek-V4-Proの旗艦同士ではなく、GLM-5.3-Flashと実験版deepseek-v4-flash-vision-expを別枠で比較してください。本番安定性、画像理解、日本語出力、価格を同じ入力で測ります。
日本語の品質はどちらが上ですか?
今回の公開資料だけでは決められません。敬語、専門用語、長文編集、曖昧な指示、構造化出力を含む日本語タスクセットで、人の評価基準を固定して確認してください。
迷ったら、二者択一ではなく短い予選を行う
API中心なら、まず両方を同じ5〜10件で走らせ、合格率、総コスト、完了時間、Tool Callsの安定性を記録してください。自己ホストが必須なら、公開ウェイトを確認できるDeepSeek-V4-Proから始めます。マルチモーダルが必須ならFlash系を別テストに切り分けます。
最終的な選択基準はモデルの知名度や最大コンテキストではなく、あなたの受け入れ条件を、許容できる時間と総コストで何回満たせたかです。公開仕様を候補選びに使い、勝敗は小さな実測で決める。それが、更新の速いGLMとDeepSeekを比較する最も再現可能な方法です。