先给结论:如果工作负载以文本为主、预算敏感,或需要低成本扩大回归样本,先测 DeepSeek V4 Pro 0813;如果图像输入是硬要求,先测 GPT-5.6 Sol;如果一次错误会触发高额返工、合规风险或人工复核,不要预判赢家,先让两者跑同一组小样本,再决定扩大哪一边。
这里的“先测”只决定测试顺序,不等于“已经证明更好”。截至 2026 年 8 月 13 日,没有找到这两个当前版本在同一供应方条件、推理强度、任务集、重复次数和计价口径下的可复现横评。最稳妥的选择方式,是先按模态、预算和部署条件缩小范围,再用真实任务计算“每个通过任务的成本”。
先把比较对象对准
这不是泛指整个 GPT-5.6 家族与整个 DeepSeek V4 家族的比较。
- OpenAI 官方文档将
gpt-5.6别名指向 GPT-5.6 Sol。Luna 和 Terra 是不同层级,不能拿它们的价格或表现代替 Sol。 - DeepSeek 官方模型表将 API 名
deepseek-v4-pro映射到 DeepSeek-V4-Pro-0813。V4 Flash 是另一条低价路线,不能混进本次结论。
因此,下面比较的是 GPT-5.6 Sol 与 API 提供的 DeepSeek-V4-Pro-0813。公开权重是否与 API 版本逐字节、逐行为一致,目前没有足够的第一方证据;自托管场景需要另做验证。
哪些条件可以直接决定先测谁
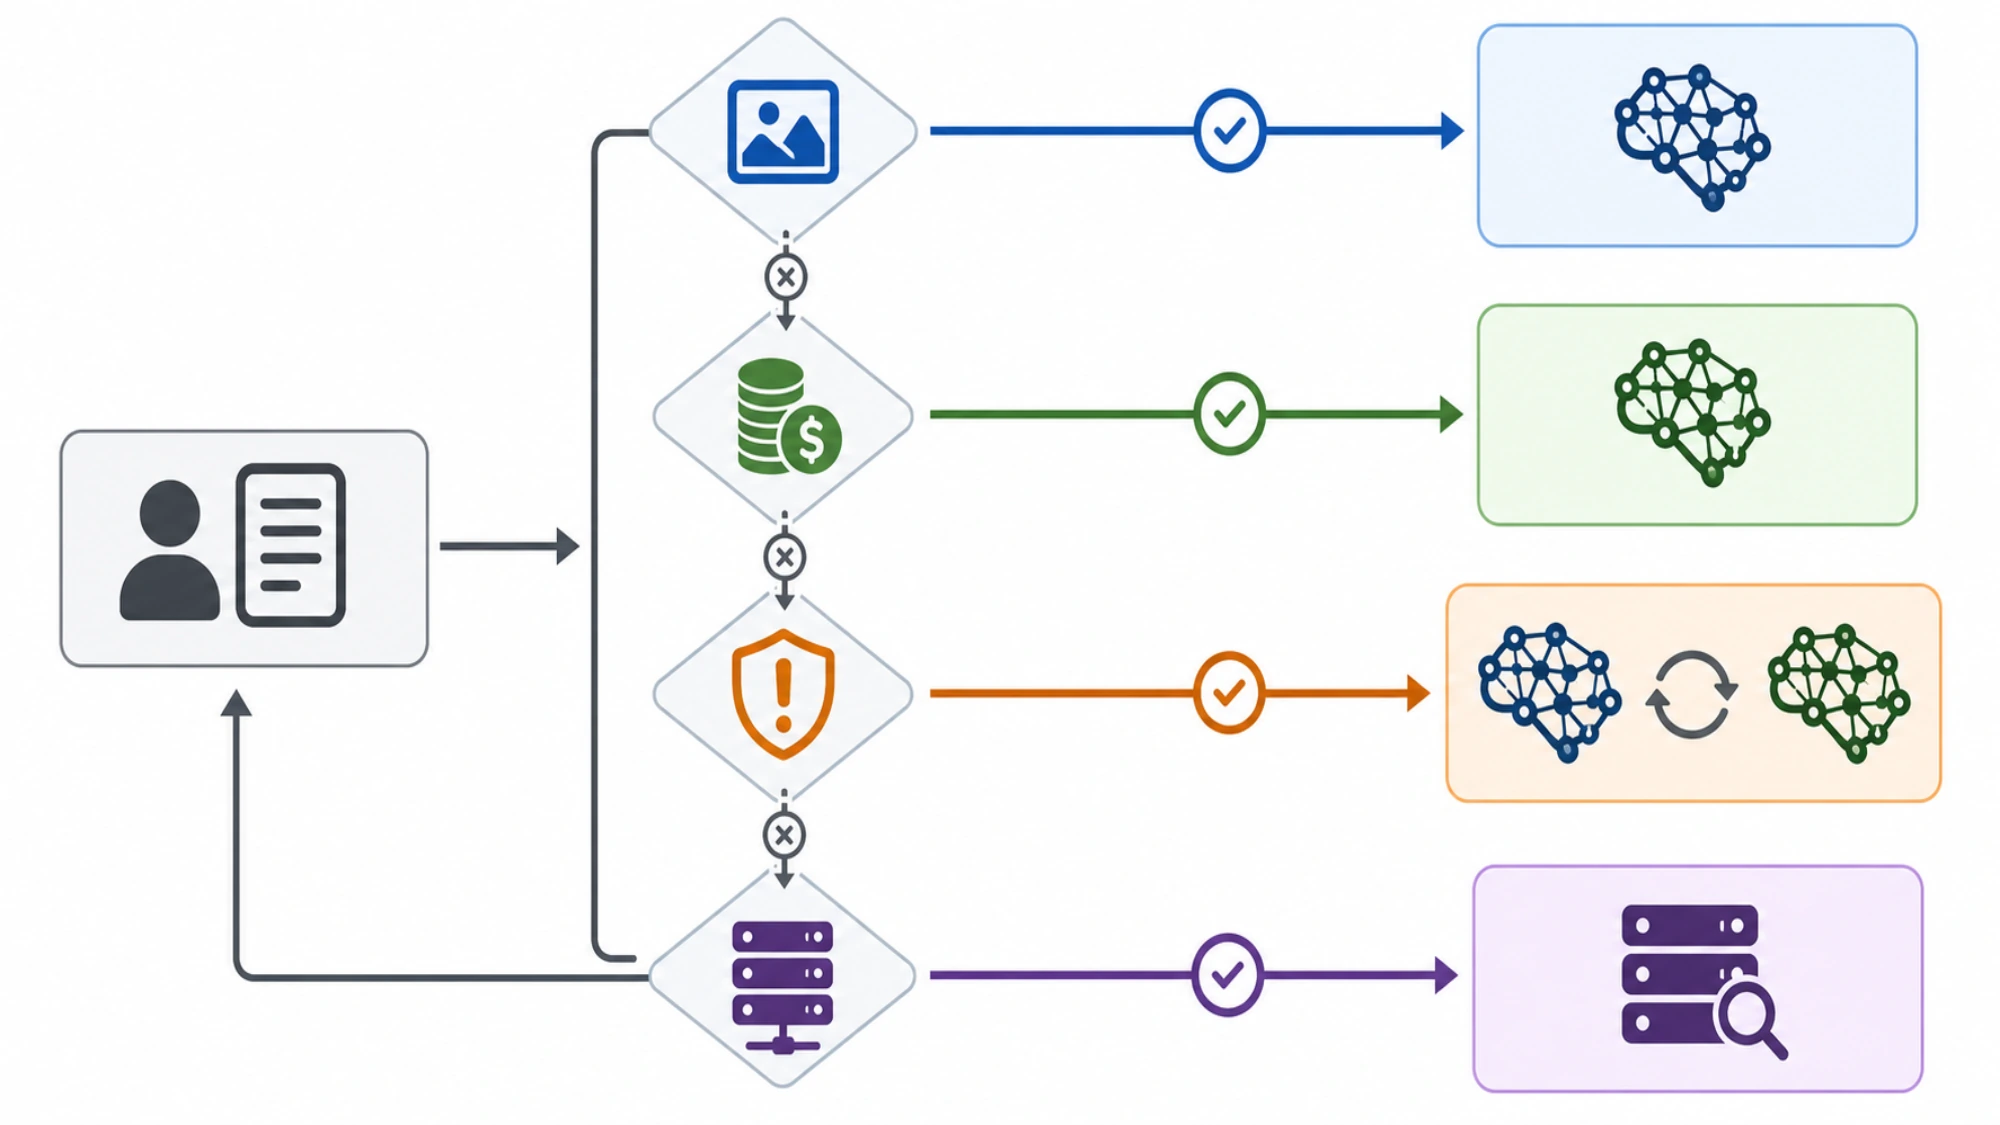
| 你的硬条件 | 建议先测 | 判断依据 |
|---|---|---|
| 文本 API 成本是首要约束 | DeepSeek V4 Pro 0813 | 2026-08-13 官方 token 单价明显更低,但 8 月 16 日将调整 |
| 需要用低预算扩大回归样本 | DeepSeek V4 Pro 0813 | 更低单次调用成本更适合先扩大覆盖面;质量仍要验收 |
| 输入包含图片 | GPT-5.6 Sol | OpenAI 官方明确列出文本、图像输入;本次证据未确认 DeepSeek 对应能力 |
| 单次失败会造成高额返工、合规风险或人工复核 | 两者先做小样本 | 第三方综合测量只能排测试顺序,不能替代同任务验收 |
| 单次输出可能非常长 | 两者都测 | Sol 官方最大输出 128K,DeepSeek 为 384K;实际可用性还受任务、延迟和成本影响 |
| 输入经常超过 272K token | 先核算再决定 | Sol 对整个请求触发更高计费;不要只比较基础单价 |
| 必须自托管 | 暂不从本文二选一 | API 版本与公开权重的等同性未确认,部署路线应独立评估 |
如果你的任务同时满足多项条件,不要把表格当投票器。例如,“有图片且调用量大”意味着 Sol 满足模态硬要求,但你仍应先测较小样本,并把图片预处理、输出长度和人工复核都算入总成本。
官方参数差异,真正影响的是这些决定
| 项目 | DeepSeek V4 Pro 0813 | GPT-5.6 Sol | 决策含义 |
|---|---|---|---|
| API 模型名 | deepseek-v4-pro | gpt-5.6 别名指向 Sol | 固定 ID 和日期,避免测试对象漂移 |
| 上下文窗口 | 1M | 1,050,000 token | 都能承接超长输入,但窗口大小不等于检索或推理质量 |
| 最大输出 | 384K | 128K token | 超长生成任务可优先验证 DeepSeek,但需测截断、连贯性和延迟 |
| 输入模态 | 本次引用资料未确认图像输入 | 文本、图像 | 图像任务不能从“上下文接近”推导等价能力 |
| 推理强度 | low、high、max | none、low、medium、high、xhigh、max | 横评必须记录档位,不能只写“都开了推理” |
| 接口 | 原生 Responses API、Anthropic 格式、工具调用、JSON 输出 | OpenAI API 对应模型能力 | 迁移成本要用真实 SDK、工具链和错误处理测试 |
这些是接口和规格事实,不是质量排名。1M 上下文不保证模型能在百万 token 中稳定找到关键证据,384K 最大输出也不代表真实业务应该生成如此长的答案。真正应测试的是:在你的输入分布中,模型能否稳定返回可接受结果。
价格差距很大,但 DeepSeek 的价格即将变化
以下均为厂商公开的美元 API 标价,不含税、网关加价、付款限制和人工复核成本。
GPT-5.6 Sol
OpenAI 在 2026 年 8 月 13 日列出的每百万 token 标准价格为:
- 输入:5 美元
- 缓存输入:0.50 美元
- 输出:30 美元
当输入超过 272K token 时,整个请求按 2 倍输入价和 1.5 倍输出价计费。超长上下文任务若忽略这一档位,预算会被系统性低估。
DeepSeek V4 Pro 0813
DeepSeek 在 2026 年 8 月 13 日列出的每百万 token 价格为:
- 缓存命中输入:0.003625 美元
- 缓存未命中输入:0.435 美元
- 输出:0.87 美元
这组价格具有很强的时效性。官方已经公布自 2026 年 8 月 16 日 16:00 UTC(北京时间 8 月 17 日 00:00) 起实施峰谷价:低谷期缓存命中、未命中输入、输出分别为 0.022、0.66、1.98 美元;高峰期分别为 0.044、1.32、3.96 美元。高峰时段为 01:00–04:00 和 06:00–10:00 UTC,换算为北京时间分别是 09:00–12:00 和 14:00–18:00。
因此,本文只能说明 8 月 13 日的价格和已公告的新价,不能替你确认生效后的实际账单。上线前应重新打开官方价格页核验时段、币种与账户条件。
不要只算 token 单价,要算每个通过任务的成本
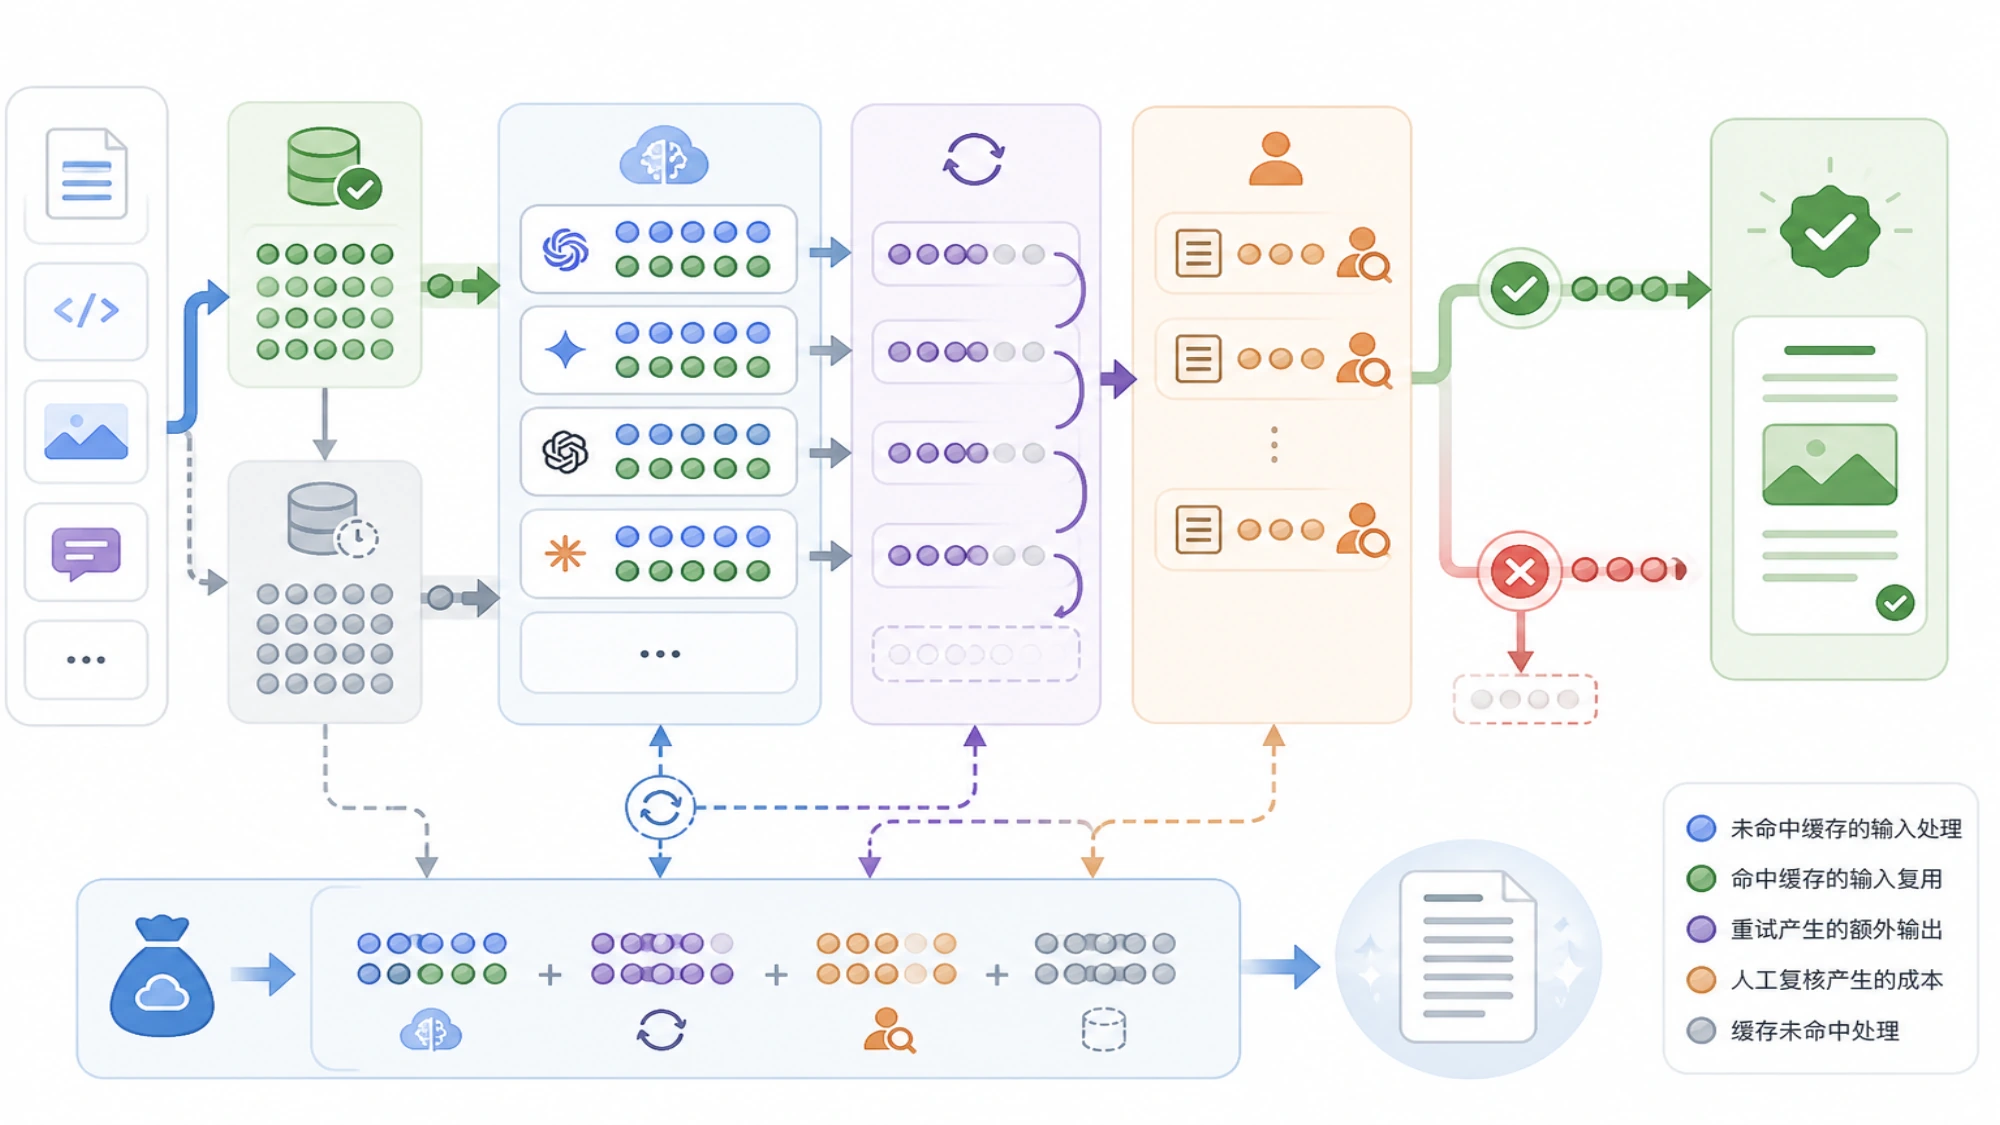
低价模型如果需要更多重试、更多人工修复,最终可能并不便宜;高价模型若一次通过率更高,也可能降低总成本。用下面的口径比较:
text单次模型成本
= 缓存未命中输入 token × 输入单价
+ 缓存命中输入 token × 缓存单价
+ 输出 token × 输出单价

每个通过任务的成本
=(全部模型调用成本 + 人工复核成本 + 重试成本)÷ 通过任务数
举例说,同一批 100 个编码任务不能只比较 API 账单。还要记录首次通过数、重试次数、人工修复分钟数、工具调用失败和不可接受错误。这样得到的才是部署决策所需的成本,而不是营销页上的最低单价。
缓存命中率也必须用你自己的流量测量。把所有输入都按缓存价估算,或者完全忽略可复用前缀,都会让两边的成本比较失真。
第三方分数只能告诉你“值得测什么”
Artificial Analysis 在其公开比较中,以 DeepSeek V4 Pro 0813 Max Effort 对 GPT-5.6 Sol high,报告的 Intelligence Index 为 53 对 57;其 7:2:1 缓存/输入/输出混合价格为 0.18 对 4.35 美元,输出速度约为 83 对 56 token/s,首 token 时间约为 1.63 对 19.28 秒。
这些数据可以形成两个待验证假设:在高失败代价任务中先给 Sol 一个小样本名额,在成本和吞吐敏感任务中优先扩大 DeepSeek 样本。但它们不能直接推出:
- Sol 一定更会写中文、写代码或跑 Agent;
- DeepSeek 在你的供应商、地区和并发条件下一定更快;
- 53 与 57 的差距能覆盖你的具体任务;
- 两边的推理强度和价格口径完全等价。
把第三方结果当作实验设计输入,而不是最终采购结论。
用 30 个真实任务完成首轮验证
无需先建一个庞大的 benchmark。挑选 30 个能够代表真实流量、且你已经知道什么叫“合格”的任务,通常足以发现明显不合适的候选;它不是统计充分性的保证,也不替代上线前的回归测试。可以先分成 18 个常规任务、6 个边界任务和 6 个高失败代价任务,再按真实流量调整比例。
- 固定版本与配置。 记录模型 ID、日期、推理强度、温度、最大输出、工具定义、系统提示词和供应商。保存响应中的实际模型标识,不要让
gpt-5.6别名在测试后发生无记录变化。 - 覆盖真实难度。 至少包含常规任务、边界任务和高失败代价任务;长上下文、图片、工具调用只在业务真的使用时加入。
- 先定义通过标准。 例如测试全过、引用可核验、JSON schema 有效、工具调用顺序正确,或人工复核不超过 3 分钟。看完答案后再定标准会引入偏差。
- 盲评并重复。 隐去模型名;对随机性明显的任务至少重复 3 次。分别记录首次通过、修复后通过和彻底失败。
- 同时记录质量与成本。 保存 token、延迟、重试、错误、人工分钟和最终通过状态,最后计算每个通过任务成本。
- 设置停止条件。 若某模型触碰安全、格式或正确性硬门槛,停止扩大该模型的流量并保留失败样本;若两者都通过,再依据通过率、每个通过任务成本、尾延迟和运维复杂度选择。
测试期间不要一边调提示词、一边只给其中一个模型更多上下文或更高推理强度。若必须分别优化,先完成同条件基线,再记录每个模型的独立优化轮次与额外成本。
选择建议:把“首测”与“上线”分开
文本为主、成本敏感:先测 DeepSeek V4 Pro 0813。 它的官方 API 标价为扩大样本提供了明显空间,最大输出也更高。上线前重新核验 8 月 16 日后的价格,并确认你的账户、网络、并发和数据要求。
图像输入是硬要求:先测 GPT-5.6 Sol。 当前官方资料明确支持图像输入,而本文证据不足以确认 DeepSeek 这一能力。这个建议来自接口边界,不等于 Sol 的图片理解已经在你的任务中获胜。
错误代价高:让两者先跑同一组小样本。 如果必须决定调用顺序,可以先验证 Sol,但这是由第三方综合指标提出的测试假设,不是质量结论。若两者都过硬门槛,再比较通过率与每个通过任务成本;只有这时,DeepSeek 的低标价才可能转化为业务优势。
必须自托管:暂时不要把 API 对比当部署结论。 公开权重与 API 服务的等同性尚未确认。你需要重新核对模型卡、许可证、硬件、推理框架、量化影响和本地实测。
最终答案不是“谁的参数表更漂亮”,而是:先用模态、部署和预算硬条件决定测试入口,再让两者接受同一套验收;谁能越过质量门槛,并以更低的每个通过任务成本稳定交付,谁才适合进入下一阶段。
来源与仍需自行确认的条件
- OpenAI:GPT-5.6 Sol 模型文档
- DeepSeek:V4 Pro 更新记录
- DeepSeek:模型规格与价格
- Artificial Analysis:GPT-5.6 Sol 与 DeepSeek V4 Pro 比较
上述公开资料没有确认中国大陆账号的可用性、付款方式、税费、配额、数据驻留、网络延迟或支持条件。涉及这些条件时,应以你自己的账户和合同为准,不要把网页可见或搜索地区参数当作可用性证明。