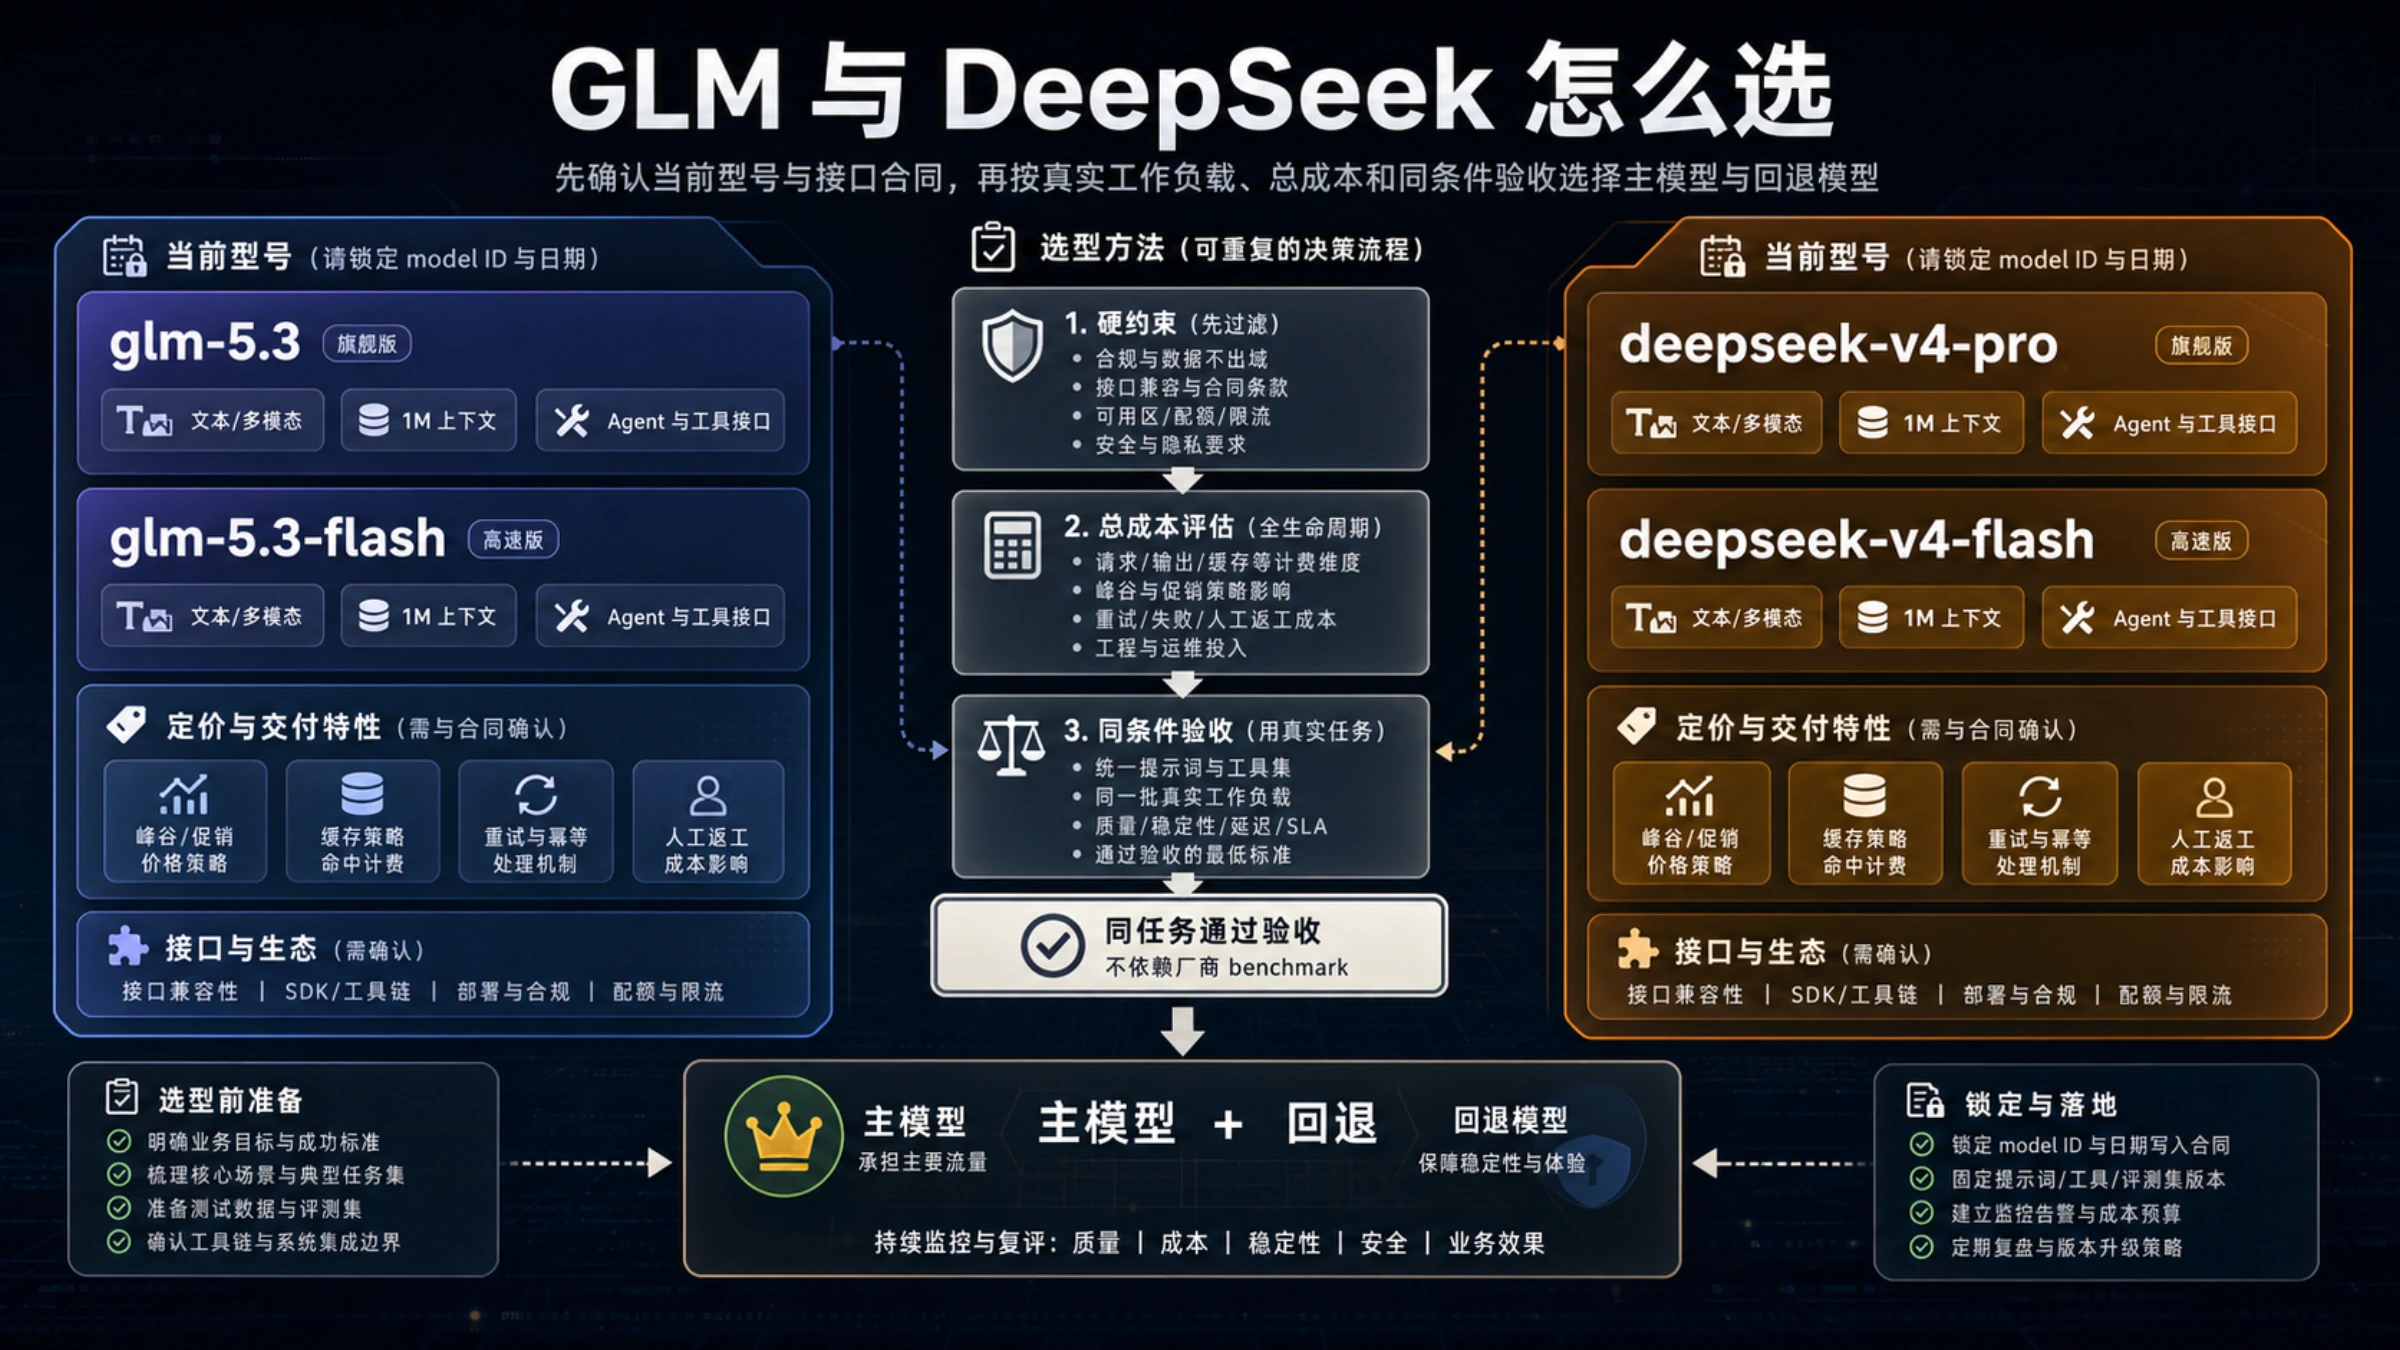
如果你正在为 API、编码工具或 Agent 选模型,现在没有证据支持一个脱离场景的绝对赢家。截至 2026 年 8 月 27 日,更合理的比较对象是 GLM-5.3 / GLM-5.3-Flash 与 DeepSeek V4 Pro / V4 Flash,而不是继续用 GLM-5.1、GLM-5.2 或更早的 DeepSeek 型号代表双方现状。
先给结论:
- 纯文本、长上下文和长流程 Agent,可以把
glm-5.3与deepseek-v4-pro同时放入最终候选;规格和厂商跑分不足以替你决定。 - 需要图片、视频或文件输入时,先核对具体入口:GLM-5.3-Flash 是 GLM-5 系列的原生多模态型号;DeepSeek 当前另有实验性的视觉 Flash 型号。实验状态、客户端支持和生产稳定性要分别验证。
- 成本敏感时,不要只比较“每百万 token 单价”。应比较每个通过验收任务的总成本,把缓存、峰谷时段、重试、工具调用和人工返工一起算进去。
- 需要自部署或审查权重许可证时,DeepSeek 官方仓库已发布 DeepSeek-V4-Pro-0813 权重并标注 MIT License;公开资料没有给出双方自部署条件的完整同口径比较,因此不能据此推导 GLM 的相反结论。
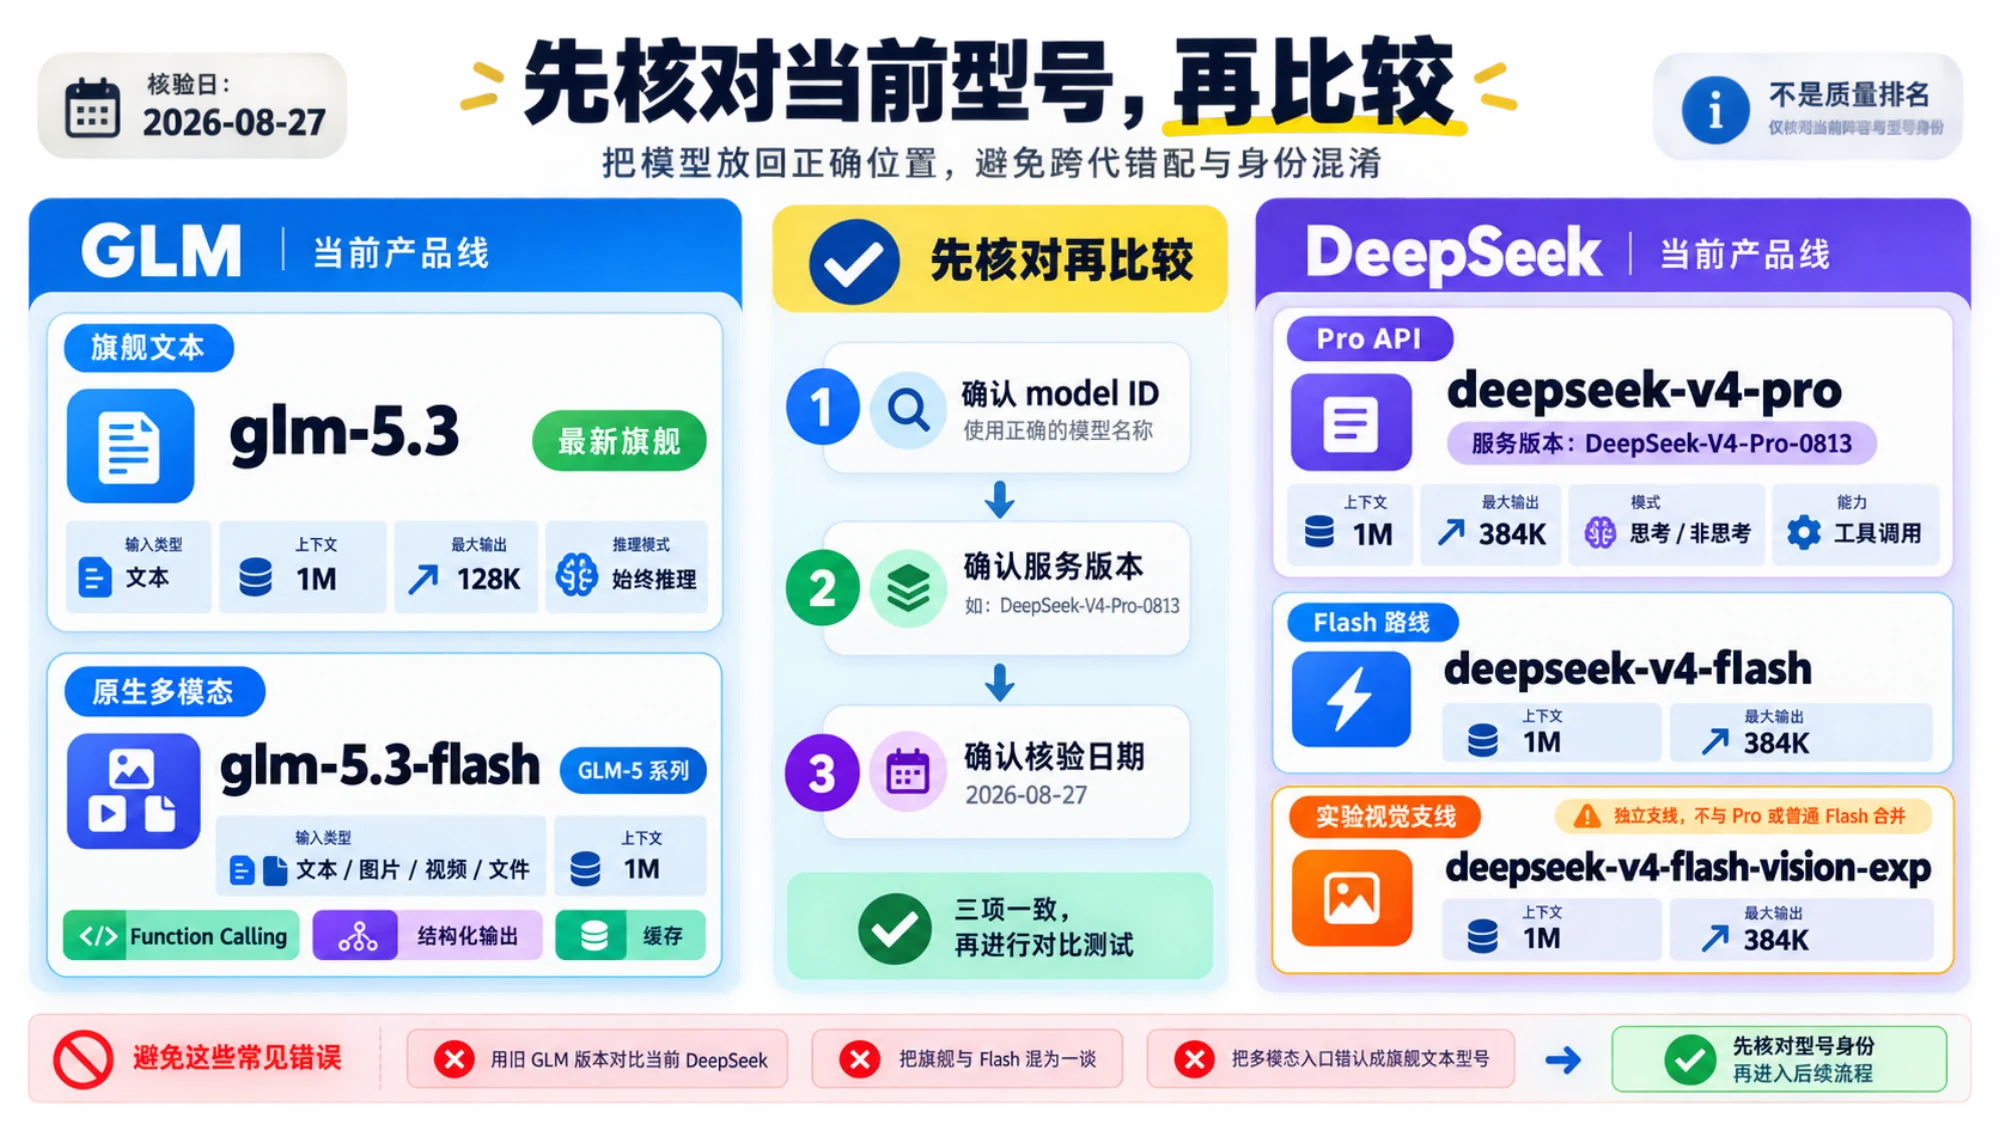
先把四个名字放回正确位置
| 候选 | 当前公开定位 | 输入与上下文 | 推理与接口要点 | 选型时最容易踩的坑 |
|---|---|---|---|---|
glm-5.3 | GLM 最新旗舰文本模型 | 仅文本;1M 上下文;最大输出 128K | 始终启用推理,支持 low、high、max effort | 用旧版 GLM 的单次测试代替当前型号结论 |
glm-5.3-flash | GLM-5 系列原生多模态型号 | 文本、图片、视频、文件;1M 上下文 | 支持 Function Calling、结构化输出和上下文缓存 | 把限时折扣当成长期预算 |
deepseek-v4-pro | DeepSeek V4 Pro 当前 API 型号 | 1M 上下文;最大输出 384K | 支持思考/非思考、工具调用、Responses API 与 Anthropic API | 忽略服务版本 DeepSeek-V4-Pro-0813 可能更新 |
deepseek-v4-flash | V4 的 Flash 路线 | 1M 上下文;最大输出 384K | 当前价卡列出 JSON、工具调用及兼容接口 | 把 Flash 与 Pro 的价格或质量混为一谈 |
这些是发布方公开合同,不是质量排名。GLM 的模型文档与 DeepSeek 的当前价卡和模型表可以确认型号、上下文和接口范围,但“兼容 OpenAI/Anthropic”并不意味着所有参数、工具循环、错误处理和状态语义完全一致。
多模态需求不要只看“支持图片”
GLM-5.3 本身是文本模型;多模态入口是 GLM-5.3-Flash。DeepSeek 在 2026 年 8 月 21 日公布了实验性的 deepseek-v4-flash-vision-exp。如果你的流程依赖截图理解、视频或文件输入,至少要实际验证:所用 endpoint 是否接受目标格式、单次大小限制、工具调用能否与多模态输入共存,以及实验型号是否满足你的稳定性要求。
价格表能筛选候选,不能直接算出谁更省
截至 2026 年 8 月 27 日,Z.ai 的美元价卡列出 GLM-5.3 每百万 token 输入 $1.40、缓存命中输入 $0.26、输出 $4.40。GLM-5.3-Flash 当时处于截至 2026 年 9 月 9 日 24:00(UTC+8)的限时五折:输入 $0.075、缓存命中输入 $0.015、输出 $0.25。促销结束后不能继续沿用这组数字,采购前应重查官方价卡。
DeepSeek V4 Pro 的公开价卡采用峰谷价。每百万 token 的闲时/高峰价格分别是:缓存命中输入 $0.022 / $0.044、缓存未命中输入 $0.66 / $1.32、输出 $1.98 / $3.96。时段、服务版本和价格都可能调整,应以调用当天的官方价格页为准。
真正有用的成本公式是:
text单个通过验收任务的总成本
= 输入费用 + 输出费用 + 工具/API 费用
 + 失败重试费用 + 人工修复费用
例如,一个模型单次调用便宜 30%,但需要两次重试才能通过测试,它可能比单价更高、一次完成的模型更贵。订阅套餐、Coding Plan 积分与 API 按量价格也不是同一种口径,不应直接摆在一列比较。
编码和 Agent:不要把厂商 benchmark 当采购结论
两家发布方都报告了各自当前模型在编码或 Agent benchmark 上的提升,但测试 harness、effort、预算和评测器并未形成一套完全相同的跨厂商对照。现有第三方测试也只能回答特定问题:例如 Aikido Security 的冻结网络安全测试覆盖 32 个近期漏洞、10 个模型、每例运行三次;在这套 harness 里,DeepSeek V4 Pro 找到的汇总漏洞更多,同时也产生了更多候选发现和误报线索。它不能外推成通用编码、推理、延迟或成本排名。
因此,编码和 Agent 选型应把“能否完成你的任务”放在最前面。下面这套小样本测试通常比再看一张综合跑分表更有效。
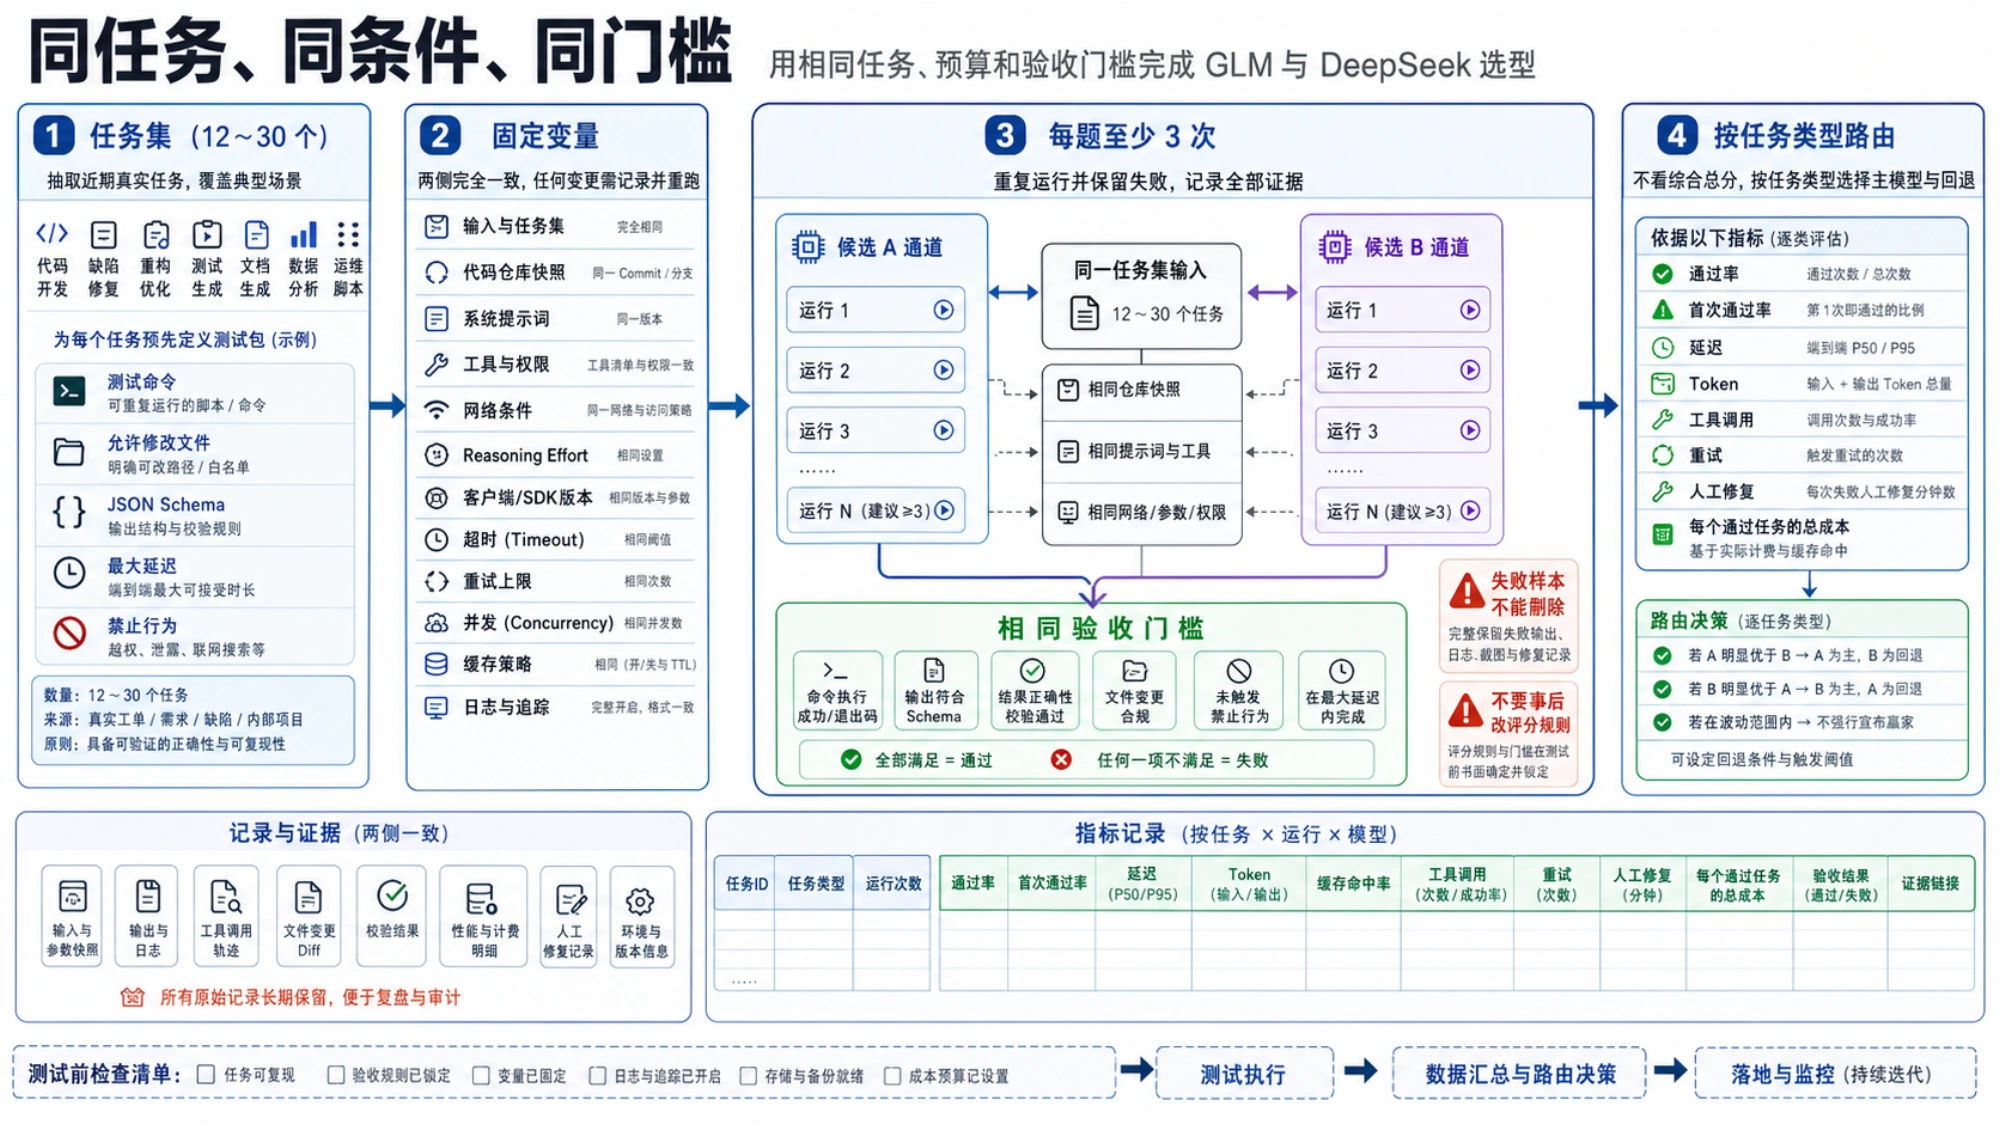
用 12~30 个真实任务做一次同条件验收
1. 建立任务集,不挑模型擅长题
从近期真实工作中抽取 12~30 个任务,覆盖你最在意的失败方式。例如:
- 跨文件修改并通过现有测试;
- 从日志定位缺陷,禁止改动无关文件;
- 调用两到三个工具后输出结构化结果;
- 在长上下文中遵守早期约束;
- 对高风险操作先停止并请求确认。
为每个任务预先写清客观验收条件,如测试命令、允许修改的文件、JSON Schema、最大延迟和禁止行为。不要在看到模型答案后再改变评分规则。
2. 固定可控变量
两边使用同一份输入、仓库快照、系统提示词、工具权限和网络条件。对齐 reasoning effort;无法完全对齐的参数要记录为限制。还要固定客户端版本、超时、最大重试次数和并发,避免把 SDK 或限流差异误判成模型能力。
3. 每题重复运行并保留失败
同一题至少重复三次。记录成功率、首次通过率、端到端延迟、输入/输出 token、缓存命中、工具调用次数、重试和人工修复分钟数。失败样本不能从结果中删除。
下面只是记录格式示例,数值不是模型实测结果:
json{
  "task_id": "repo-fix-07",
  "model": "glm-5.3",
  "reasoning_effort": "high",
  "accepted": true,
  "retries": 0,
  "latency_seconds": 94,
  "tool_calls": 11,
  "human_rework_minutes": 3,
  "total_api_cost_usd": 0.42
}
4. 按任务类型决定路由
不要只算一个总分。如果 GLM 在长流程修改上首次通过率更高,而 DeepSeek 在短任务上成本更低,可以按任务分类路由;如果差异落在重复测试的波动范围内,就优先选择接入更稳、合同更清楚或采购更容易的一方。
一份可以直接执行的选择规则
- 先查型号。 调用前记录 model ID、实际服务版本与日期,避免别名悄悄切换后仍沿用旧结论。
- 再按硬约束排除。 输入模态、上下文、输出上限、自部署、数据治理、账户和付款条件有一项不满足,就先排除。
- 价格只做预算上限。 用真实 token、峰谷时段、缓存率和重试率估算,不用宣传页里的最低单价代替总成本。
- 最后做同条件验收。 只有真实任务的通过率、延迟和返工成本才能决定主模型。
- 保留回退。 生产路由不要只绑定一个别名;同时监控版本、错误率、延迟和价卡变化。
常见问题
GLM-5.3 和 DeepSeek V4 Pro 谁的编程能力更强?
截至 2026 年 8 月 27 日,本文核对的公开资料中没有一份独立、同环境、足量重复、当前代且完全同条件的正面对照,所以不能负责任地给出绝对答案。先用你的仓库、测试和工具权限做小样本验收,比引用双方不一致的厂商 benchmark 更可靠。
1M 上下文是不是意味着两边长文档能力一样?
不是。1M 是公开的上下文上限,不代表相同的信息保持、检索准确率、延迟、费用或任务完成率。应使用接近生产长度的样本验证,而且要观察长输入下的工具调用和约束遵守情况。
OpenAI 或 Anthropic 兼容接口可以直接无缝替换吗?
不能默认无缝。字段可接受不等于工具循环、流式事件、推理内容、错误码、重试与状态管理完全相同。先在隔离环境跑一遍真实客户端测试,再切换生产流量。
中国大陆团队还要核对什么?
公开页面可访问不等于你的主体一定能注册、支付、开票或满足数据驻留、保留、训练使用、SLA 与采购要求。公开文档没有完整回答这些地区和主体相关条件,应由法务、采购和安全团队按实际账户合同确认。
最后的判断标准
GLM 与 DeepSeek 的版本更新很快,“最新”只是比较的起点。先用官方文档锁定准确型号,再用硬约束排除不合适候选,最后用同条件任务验收决定主模型和回退模型。这样得到的不是一句容易过期的“谁更强”,而是一条可以在版本、价格和工作负载变化后重复执行的选型路径。